 decalage2/collisions
Hash-Kollisionen und ihre Ausnutzung

TL;DR eine MD5-Kollision dieser beiden Bilder zu erzeugen ist jetzt(*) trivial und sofort möglich.
 ⟷
<a href=http://gunshowcomic.com/648>
Spiel nicht mit dem Feuer, verlass dich nicht auf MD5.
(*) Es ist seit vielen Jahren möglich, beliebige Dateipaare kollidieren zu lassen, aber es dauert jedes Mal mehrere Stunden, ohne Abkürzung.
Diese Seite bietet dateiformatspezifische Tricks und vorberechnete Kollisions-Präfixe, um Kollisionen sofort zu ermöglichen.
git clone. Skript ausführen. Fertig.
Von Ange Albertini und Marc Stevens.
Das Ziel ist es, bestehende Angriffe umfassend zu untersuchen - und dabei zu zeigen, wie schwach MD5 ist (sofortige Kollisionen für beliebige JPG, PNG, PDF, MP4, PE...) - und auch gängige Dateiformate im Detail zu untersuchen, um festzustellen, wie sie mit gegenwärtigen oder zukünftigen Angriffen ausgenutzt werden können.
Tatsächlich kann derselbe Dateiformat-Trick bei mehreren Hashes verwendet werden (dieselben JPG-Tricks wurden für MD5, malicious SHA-1 und SHA1), solange die Kollisionen denselben Byte-Mustern folgen.
Dieses Dokument handelt nicht von neuen Angriffen (der neueste wurde 2012 dokumentiert), sondern von neuen Formen der Ausnutzung bestehender Angriffe.
Aktueller Status - Stand Dezember 2018 - der bekannten Angriffe:
eine Datei zu erhalten, die den Hash einer anderen Datei oder einen vorgegebenen Hash ergibt: unmöglich
zwei verschiedene Dateien mit demselben MD5 zu erhalten: sofort
zwei beliebige Dateien auf denselben MD5 zu bringen: einige Stunden (72 hours.core)
zwei beliebige Dateien bestimmter Dateiformate (PNG, JPG, PE...) auf denselben MD5 zu bringen: sofort
zwei verschiedene Dateien mit demselben SHA1 zu erhalten: 6500 years.core
(*) Beispiel mit crypt - danke Sven!```
import crypt crypt.crypt("5dUD&66", "br") 'brokenOz4KxMc' crypt.crypt("O!>',%$", "br") 'brokenOz4KxMc'
# Angriffe

MD5 und SHA1 arbeiten mit Blöcken von 64 Bytes.

Wenn zwei Inhalte A & B denselben Hash haben, dann bleibt der Hash gleich, wenn man denselben Inhalt C an beide anhängt.``` text
hash(A) = hash(B) -> hash(A + C) = hash(B + C)
Kollisionen funktionieren, indem an einer Blockgrenze eine Anzahl berechneter Kollisionsblöcke eingefügt wird, die von dem abhängt, was zuvor in der Datei stand. Diese Kollisionsblöcke sehen sehr zufällig aus, mit einigen geringfügigen Unterschieden (die einem bestimmten Muster für jeden Angriff folgen), und sie führen winzige Unterschiede ein, während sie nach diesen Blöcken schließlich denselben Hash-Wert ergeben.
Diese Unterschiede werden ausgenutzt, um gültige Dateien mit bestimmten Eigenschaften zu erzeugen.
Dateiformate arbeiten ebenfalls von oben nach unten, und die meisten arbeiten mit Byte-Chunks.
Einige 'Comment'-Chunks können eingefügt werden, um Datei-Chunks an Blockgrenzen auszurichten, um bestimmte Strukturen an die Unterschiede der Kollisionsblöcke anzupassen, um den Rest der Zufälligkeit der Kollisionsblöcke vor den Datei-Parsern zu verbergen und um ansonsten gültigen Inhalt vor dem Parser zu verbergen (damit er einen anderen Inhalt sieht).
Diese 'Comment'-Chunks sind oft keine offiziellen echten Kommentare: Sie werden nur als Datencontainer verwendet, die vom Parser ignoriert werden (z. B. sind PNG-Chunks mit einer ID, die mit einem Kleinbuchstaben beginnt, ergänzend (ancillary), nicht kritisch).
Meistens wird ein Unterschied in den Kollisionsblöcken verwendet, um die Länge eines Comment-Chunks zu ändern, der typischerweise direkt vor den Daten dieses Chunks deklariert wird: In der Lücke zwischen der kürzeren und der längeren Version dieses Chunks wird ein weiterer Comment-Chunk deklariert, um über den Inhalt A einer Datei hinwegzuspringen. Nach diesem Dateiinhalt A wird einfach ein weiterer Dateiinhalt B angehängt.
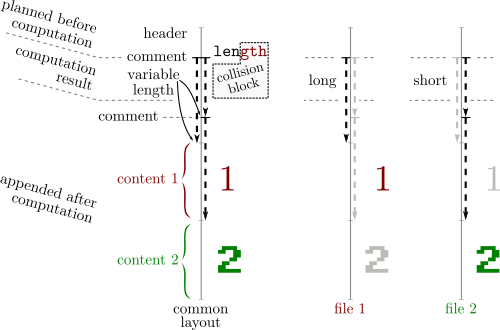
Da Dateiformate normalerweise einen Terminator definieren, der die Parser danach stoppt, beendet A das Parsen, wodurch der angehängte Inhalt B ignoriert wird.
Normalerweise sind also mindestens zwei Kommentare erforderlich – oft drei:
