 cisagov/findcdn
Scannt Domains, um zu identifizieren, welches Content Delivery Network (CDN) sie verwenden, indem HTTPS-Header, CNAME-Einträge und WHOIS-Daten gefingerprintet werden, mit JSON-Ausgabe und Modulunterstützung.


findcdn ist ein Tool, das die Art des
Content Distribution Network (CDN)
scannen und erkennen kann, das eine Domain verwendet. findcdn kann Ergebnisse
in einer Datei speichern, als Modul verwendet werden oder einfach auf stdout
ausgeben.
findcdn hilft den Nutzern des Tools, genau zu bestimmen, welches CDN eine
Domain verwendet. Die Liste der unterstützten Domains ist in der Datei
cdn_config.py
im Repository aufgeführt. Die Bibliothek kann als eigenständiges Tool oder als
importierbares Modul in Ihrem Projekt implementiert werden. In beiden Fällen
können die Ergebnisse in eine Ausgabedatei geschrieben werden.
findcdn erfordert Python 3.7+. Python 2 wird nicht unterstützt.
findcdn kann als Modul mit pip und der Datei requirements.txt im
Repository installiert werden.
findcdn kann über pip installiert werden:
pip install --requirement requirements.txt
Anschließend kann es direkt ausgeführt werden:
findcdn list github.com
Alternativ können Sie es schnell in jedes Projekt installieren mit:
pip install git+https://github.com/cisagov/findcdn.git
Hinweis: Es wird empfohlen, eine Python-virtuelle-Umgebung zu verwenden, um Module zu installieren und Ihre Umgebung sauber zu halten. Wenn Sie dies tun möchten, benötigen Sie pyenv und das pyenv-virtualenv-Plugin, bevor Sie das Modul installieren.
findcdn file <fileIn> [options]
findcdn list  <domain>... [options]
findcdn (-h | --help)

findcnd -h
findcdn file domains.txt -o output_cdn.txt -t 17 -d
findcdn list dhs.gov cisa.gov -o output_cnd.txt -v
findcdn list cisa.gov
  -h --help                    Diese Meldung anzeigen.
  --version                    Die aktuelle Version anzeigen.
  -o FILE --output=FILE        Falls angegeben, wird die JSON-Ausgabedatei
                               unter dem angegebenen Wert erstellt.
  -v --verbose                 Fügt zusätzliche Ausgabeanweisungen hinzu.
  --all                        Bezieht Domains mit und ohne CDN in die
                               Ausgabe ein.
  -d --double                  Führt die Prüfungen zweimal aus, um die
                               Genauigkeit zu erhöhen.
  -t --threads=<thread_count>  Anzahl der Threads, andernfalls wird der
                               Standardwert verwendet.
  --timeout=<timeout>          Maximale Dauer in Sekunden, die auf den
                               Abschluss der Verarbeitung einer Domain gewartet
                               wird, andernfalls wird der Standardwert
                               verwendet.
  --user_agent=<user_agent>    Legt den zu verwendenden User-Agent fest,
                               andernfalls wird der Standardwert verwendet.
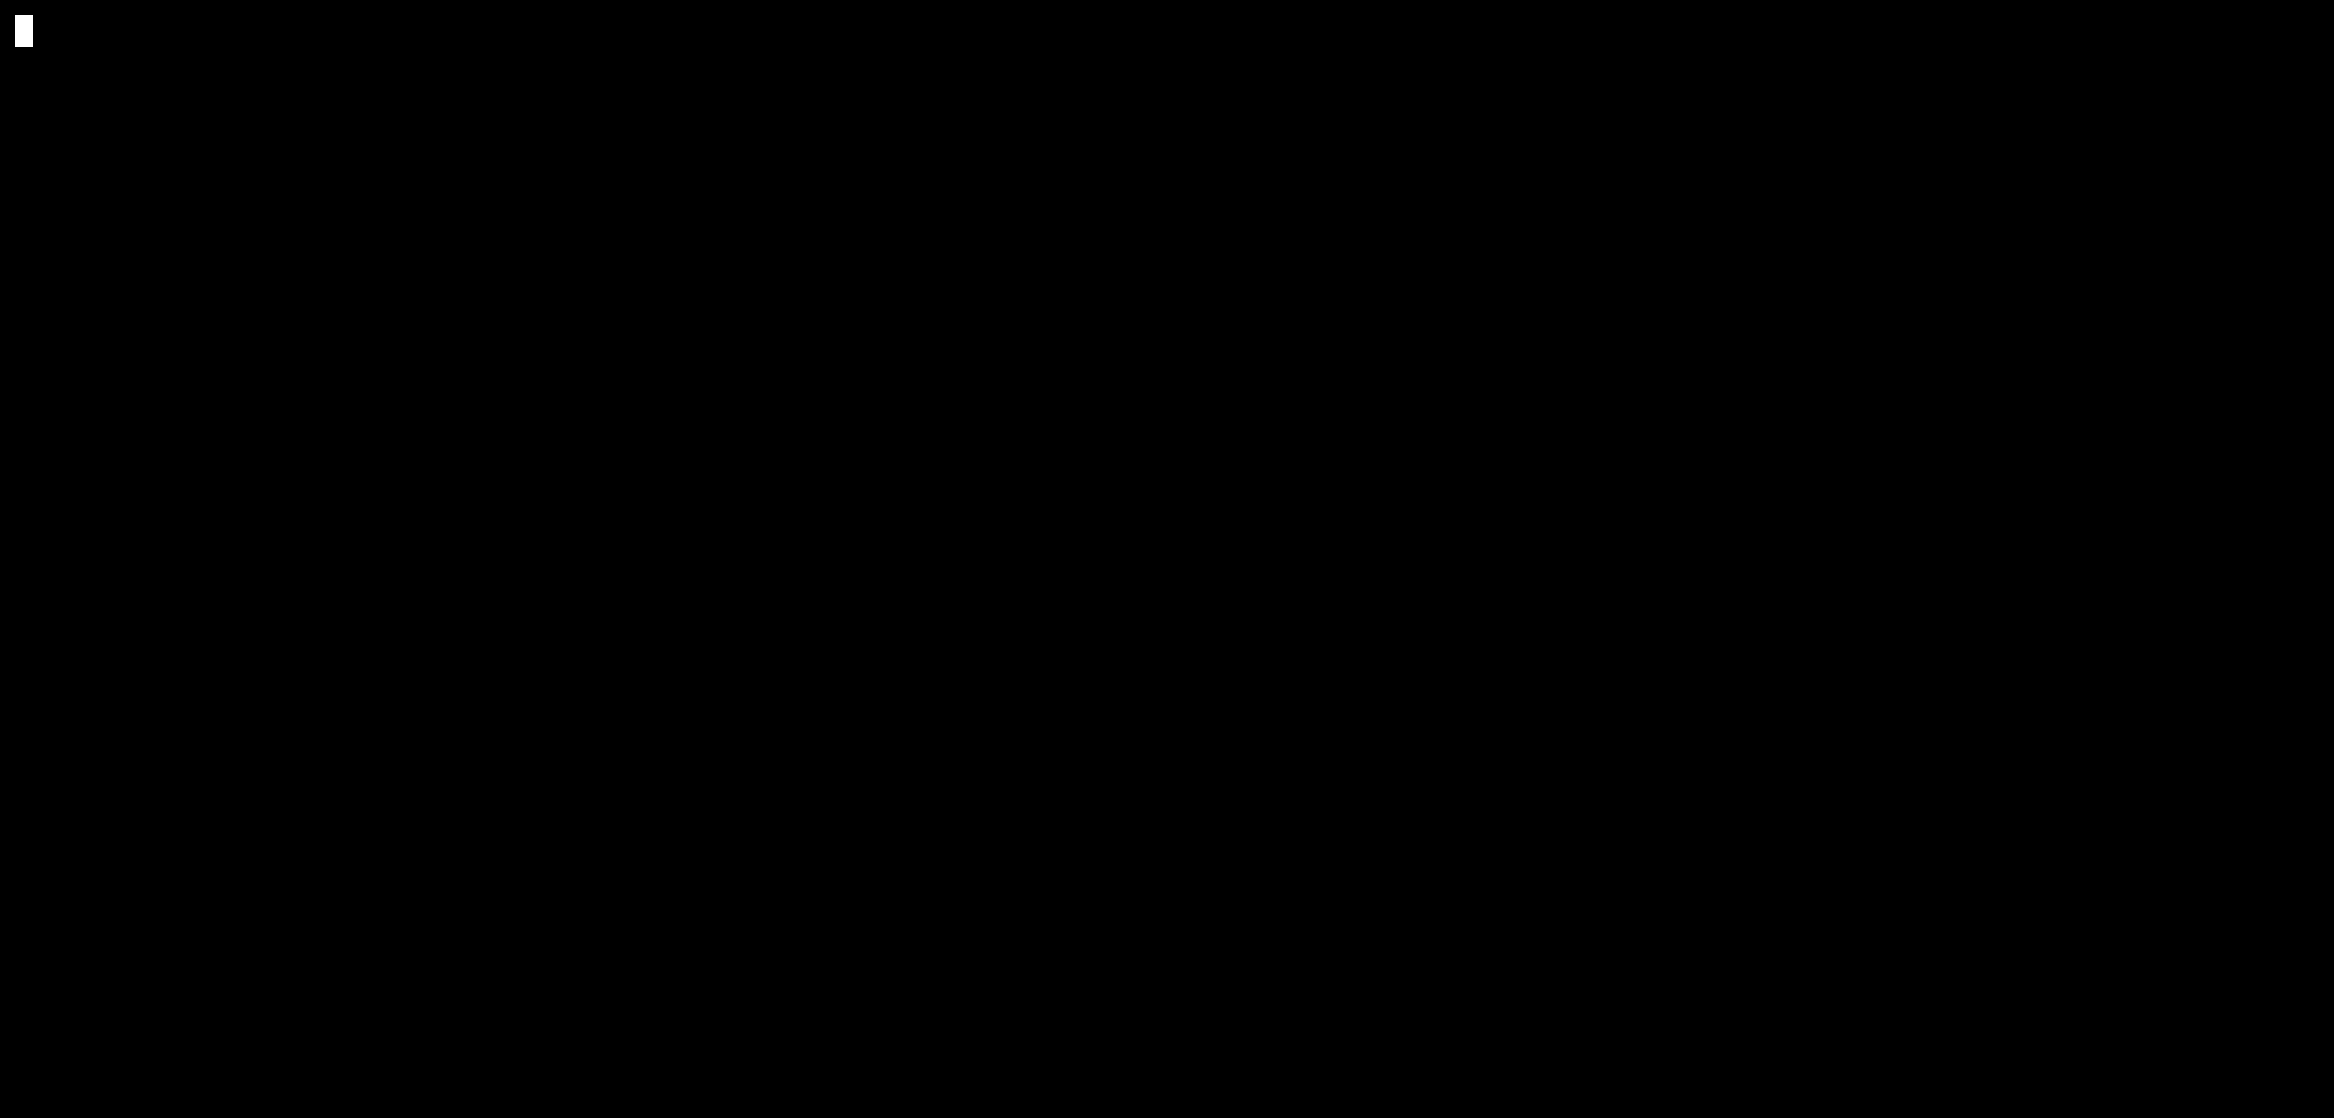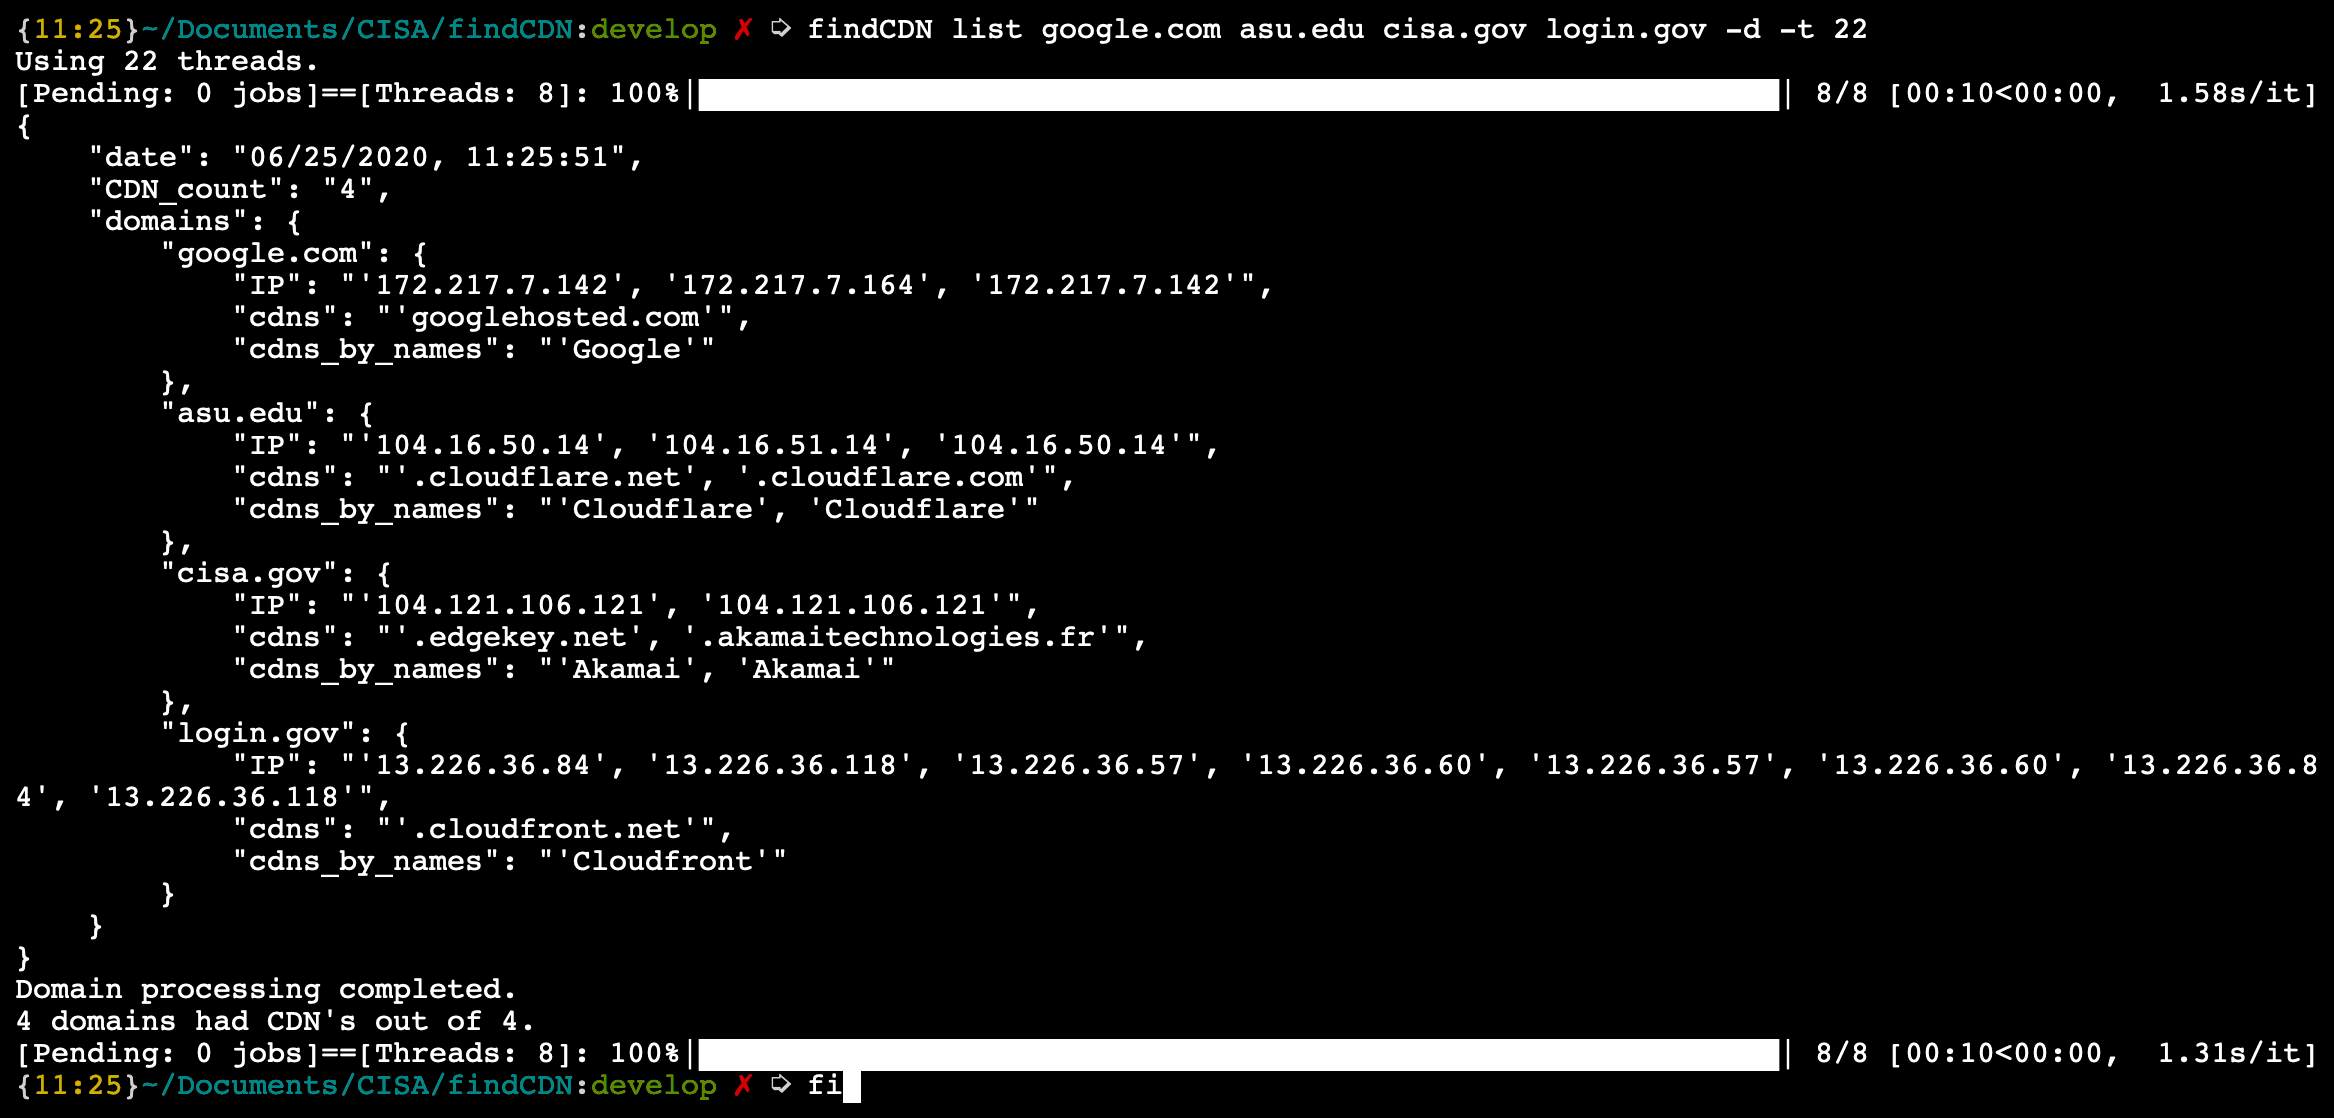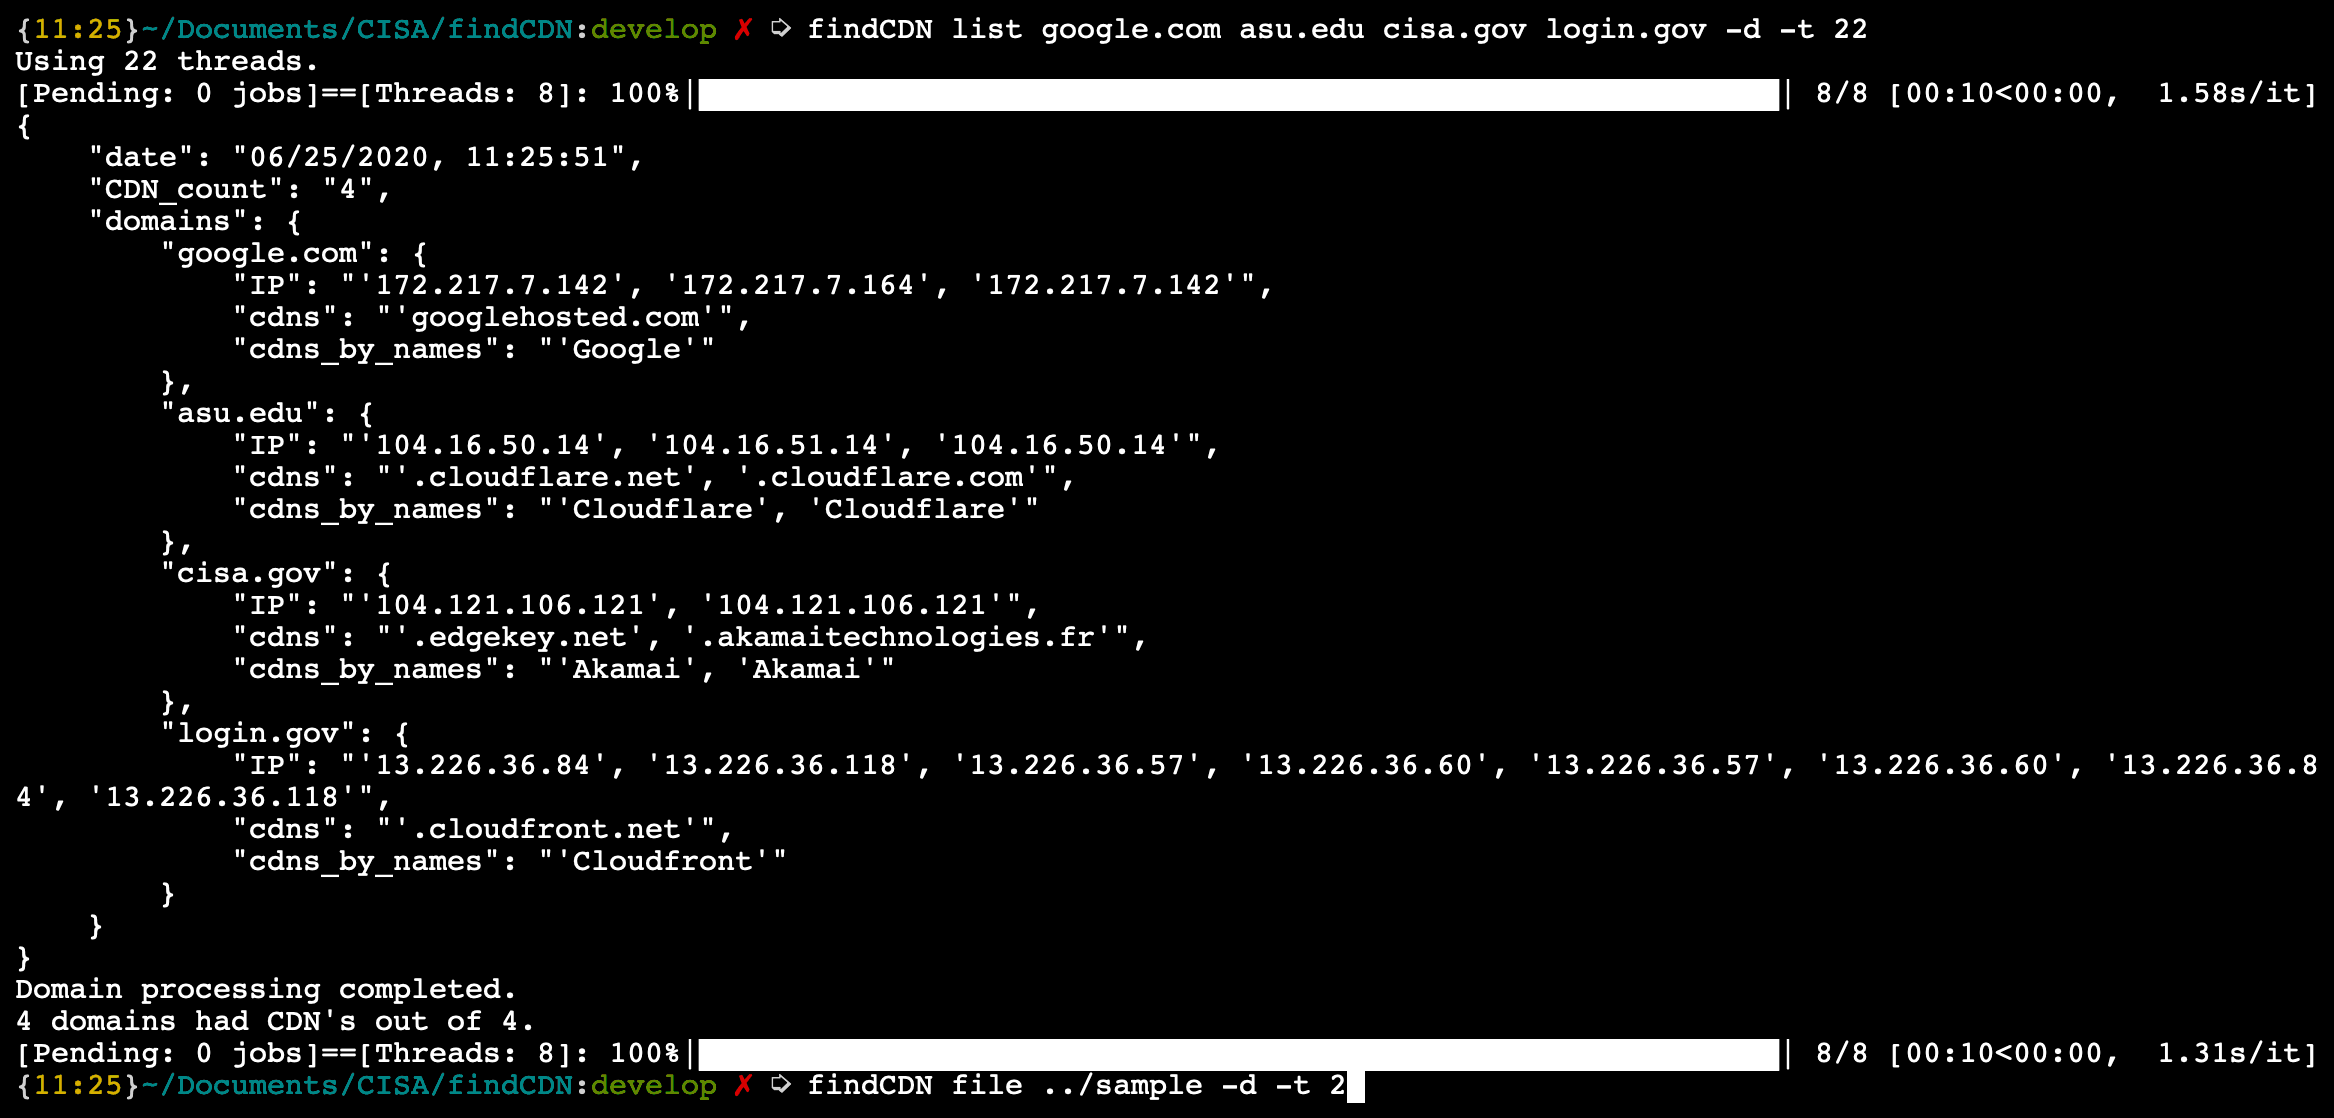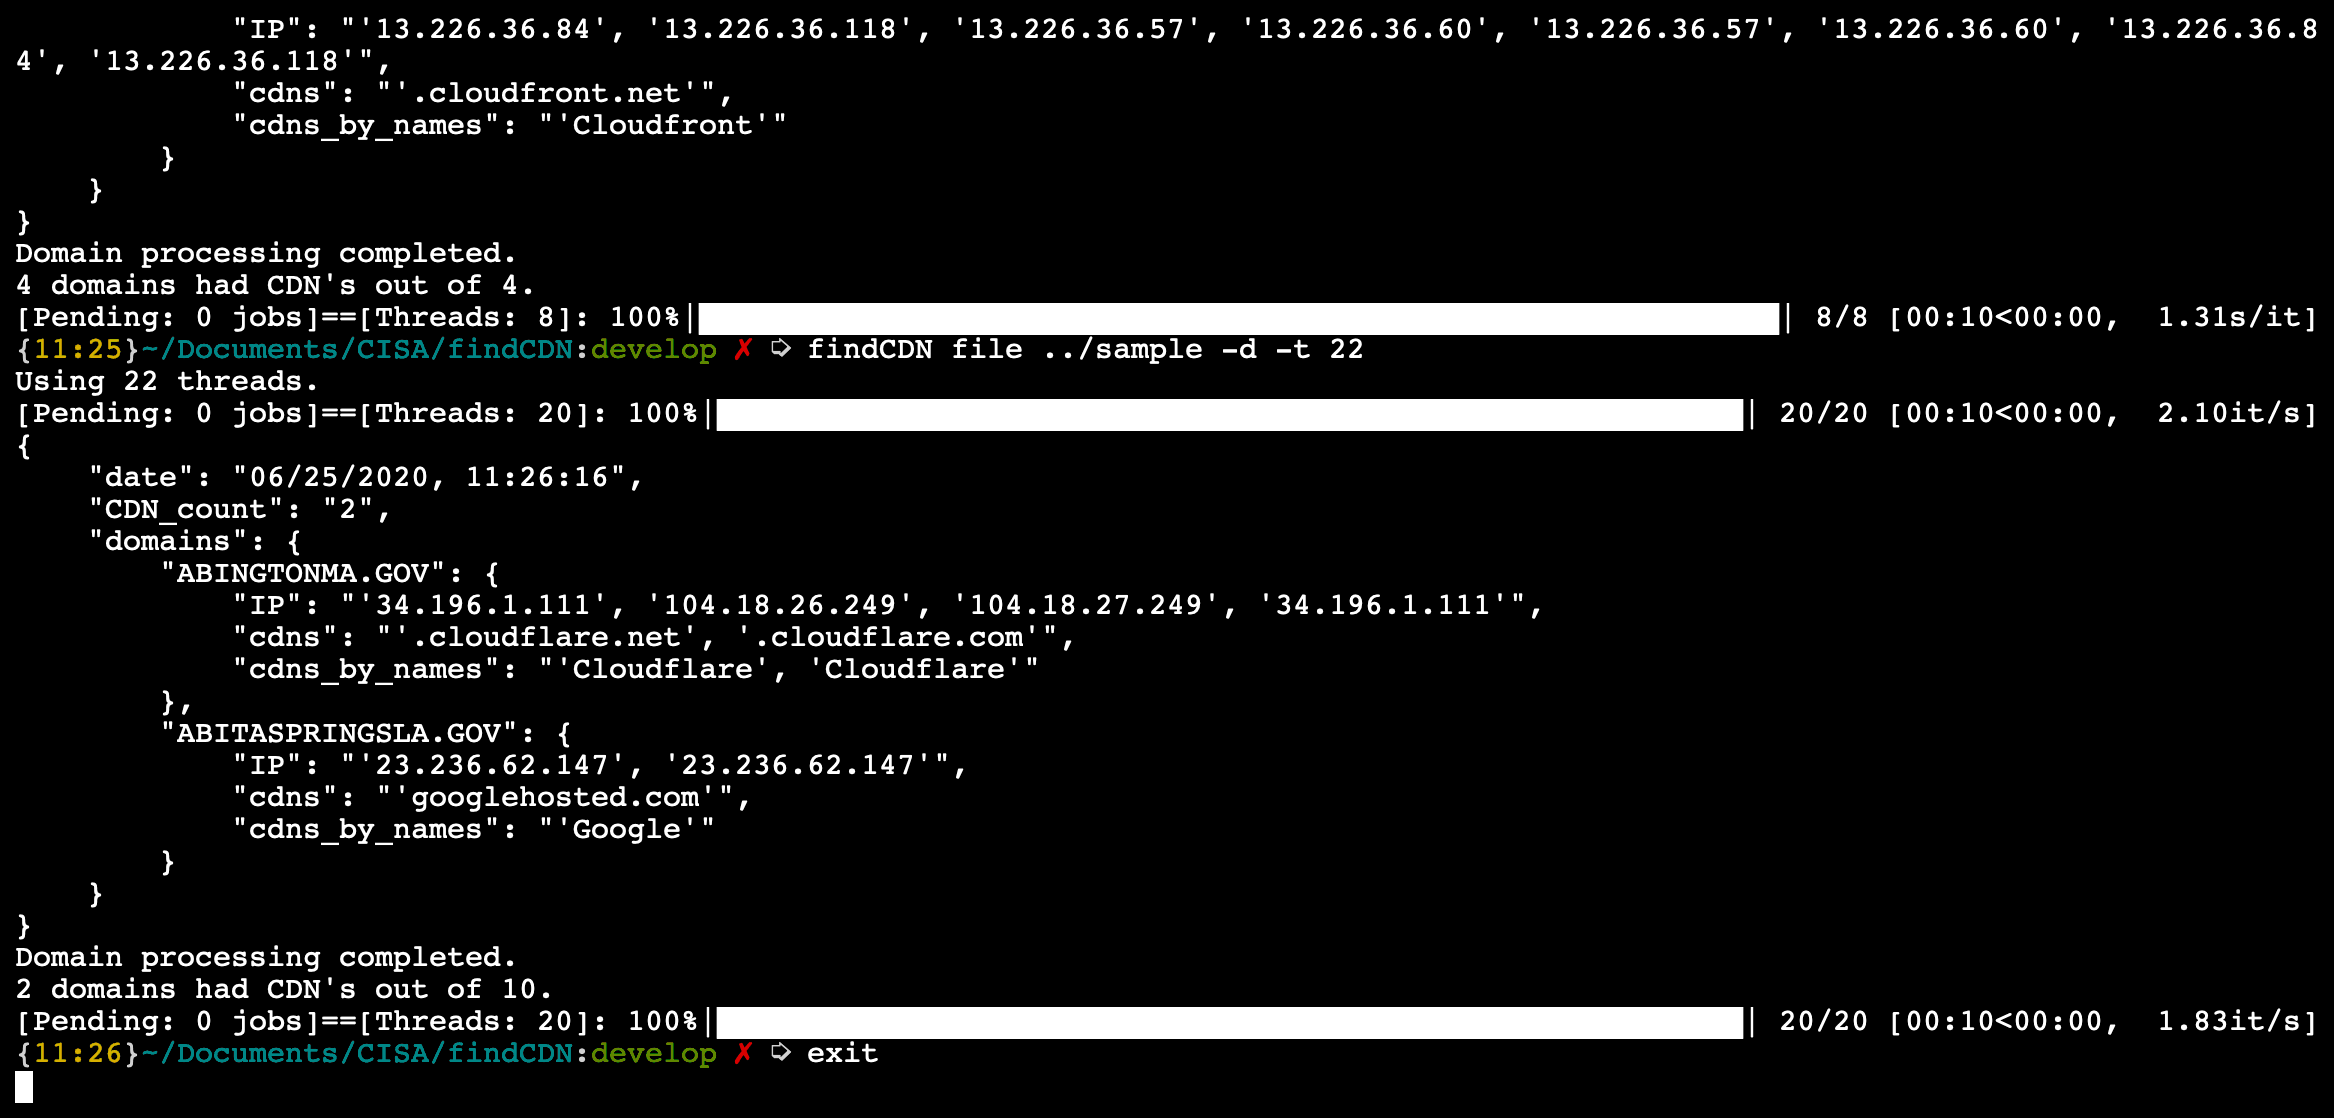
user2@ubuntu:~$ findcdn list asu.edu -t 7 --double
Using 7 threads.
[Pending: 0 jobs]==[Threads: 2]: 100%|███████████████████████████████| 2/2 [00:00<00:00,  2.22it/s]
{
    "date": "06/19/2020, 13:00:38",
    "CDN_count": "1",
    "domains": {
        "asu.edu": {
            "IP": "'104.16.50.14'",
            "cdns": "'.cloudflare.com'",
            "cdns_by_names": "'Cloudflare'"
        }
    }
}
Domain processing completed.
1 domains had CDN's out of 1.
Da findcdn als Modul installiert werden kann, kann seine CDN-Erkennungsfähigkeit
aus jedem Projekt heraus aufgerufen und implementiert werden. Importieren Sie
zunächst findcdn in Ihr Projekt, wie oben gezeigt. Übergeben Sie ihm dann eine
Liste von Domains zur Analyse. Nach der Verarbeitung gibt das Programm ein
JSON-Objekt zurück, das die eingegebenen Domains und die von ihnen verwendeten
CDNs enthält.
Die Funktionsweise von findcdn wird durch die übergebenen Optionen bestimmt;
die aktuell möglichen Optionen und ein Beispiel sind unten zu Ihrer
Bequemlichkeit aufgeführt:
findcdn.main(
    domain_list: List[str],  # List of domains to search
    output_path: str = None,  # if included, output results to JSON
    verbose: bool = False,  # Verbose mode (more printing!)
    all_domains: bool = False,  # Includes domains that dont have cdn's in the output
    interactive: bool = False,  # Includes a progress bar (normally used for command line)
    double_in: bool = False,  #D ouble the number of tries on a domain to increase accuracy
    threads: int = THREADS,  # Number of threads to use
    timeout: int = TIMEOUT,  # How long to wait on a domain
    user_agent: str = USER_AGENT,  # User Agent to use
)
import findcdn
import json

domains = ['google.com', 'cisa.gov', 'censys.io', 'yahoo.com', 'pbs.org', 'github.com']
resp_json = findcdn.main(domains, output_path="output.json", double_in=True, threads=23)

dumped_json = json.loads(resp_json)

for domain in dumped_json['domains']:
    print(f"{domain} has CDNs:\n {dumped_json['domains'][domain]['cdns']}")
findcdn ist in drei Abschnitte unterteilt:
Chef verwendet die CDN Detection Library, um alle CDNs für jede Domain zu
ermittelnChef führt dann eine Analyse durch, um den booleschen Wert has_cdn
festzulegen, wenn er erkennt, dass eine Domain ein CDN hat, und gibt dann
die Liste der Domains an die Runner-Datei zurückcdn_config.py definierten CDNs zu identifizieren.Der ursprüngliche Zweck dieses Tools war, automatisch zu erkennen, ob eine Domain, die ein CDN verwendet, frontbar ist. Aufgrund des erheblichen Aufwands für die Fronting-Erkennung haben wir die Entwicklung dieses Tools so ausgerichtet, dass es ausschließlich ein CDN-Erkennungs-Tool ist. Wir verwenden unser Wiki, um weiter zu beschreiben, was Domain Fronting ist, unsere Forschungsnotizen, Designentscheidungen und Playbooks für das Fronting bestimmter Domains. Wenn Sie zusätzliche frontbare Domains oder Fehler in den aktuellen Playbooks finden, ziehen Sie bitte in Betracht, beizutragen!
Weitere Informationen finden Sie auf unserer Wiki-Seite. Wir ermutigen Sie, Funktionswünsche zu äußern oder beizutragen, was auch immer Sie zum Projekt oder Wiki hinzugefügt sehen möchten.
Dies kann eines der folgenden sein:
Wir freuen uns über Beiträge! Weitere Details finden Sie in
CONTRIBUTING.md.
Dieses Projekt ist weltweit gemeinfrei.
Dieses Projekt ist in den Vereinigten Staaten gemeinfrei, und Urheberrechte sowie verwandte Schutzrechte an dem Werk weltweit werden durch die CC0 1.0 Universal Public Domain Dedication aufgegeben.
Alle Beiträge zu diesem Projekt werden unter der CC0-Dedication veröffentlicht. Durch das Einreichen eines Pull Requests erklären Sie sich damit einverstanden, dieser Aufgabe von Urheberrechtsansprüchen nachzukommen.
