
Ein leistungsstarkes Directory-Brute-Force-Tool, das für rekursive/Multiplex-Operationen, API-Erkennung und -Enumeration, JS-Datei-Scraping und die Auflistung von API-HTTP-Methoden in einem einzigen Befehl ausgelegt ist. Dies ist nicht NUR für APIs, mein Tool zeichnet sich einfach darin aus.
Ein leistungsstarkes Directory-Brute-Force-Tool, entwickelt für API-Erkundung und Penetrationstests. Es entdeckt automatisch versteckte API-Endpunkte, führt rekursives Subscanning durch und testet HTTP-Methoden für eine tiefere API-Erfassung.
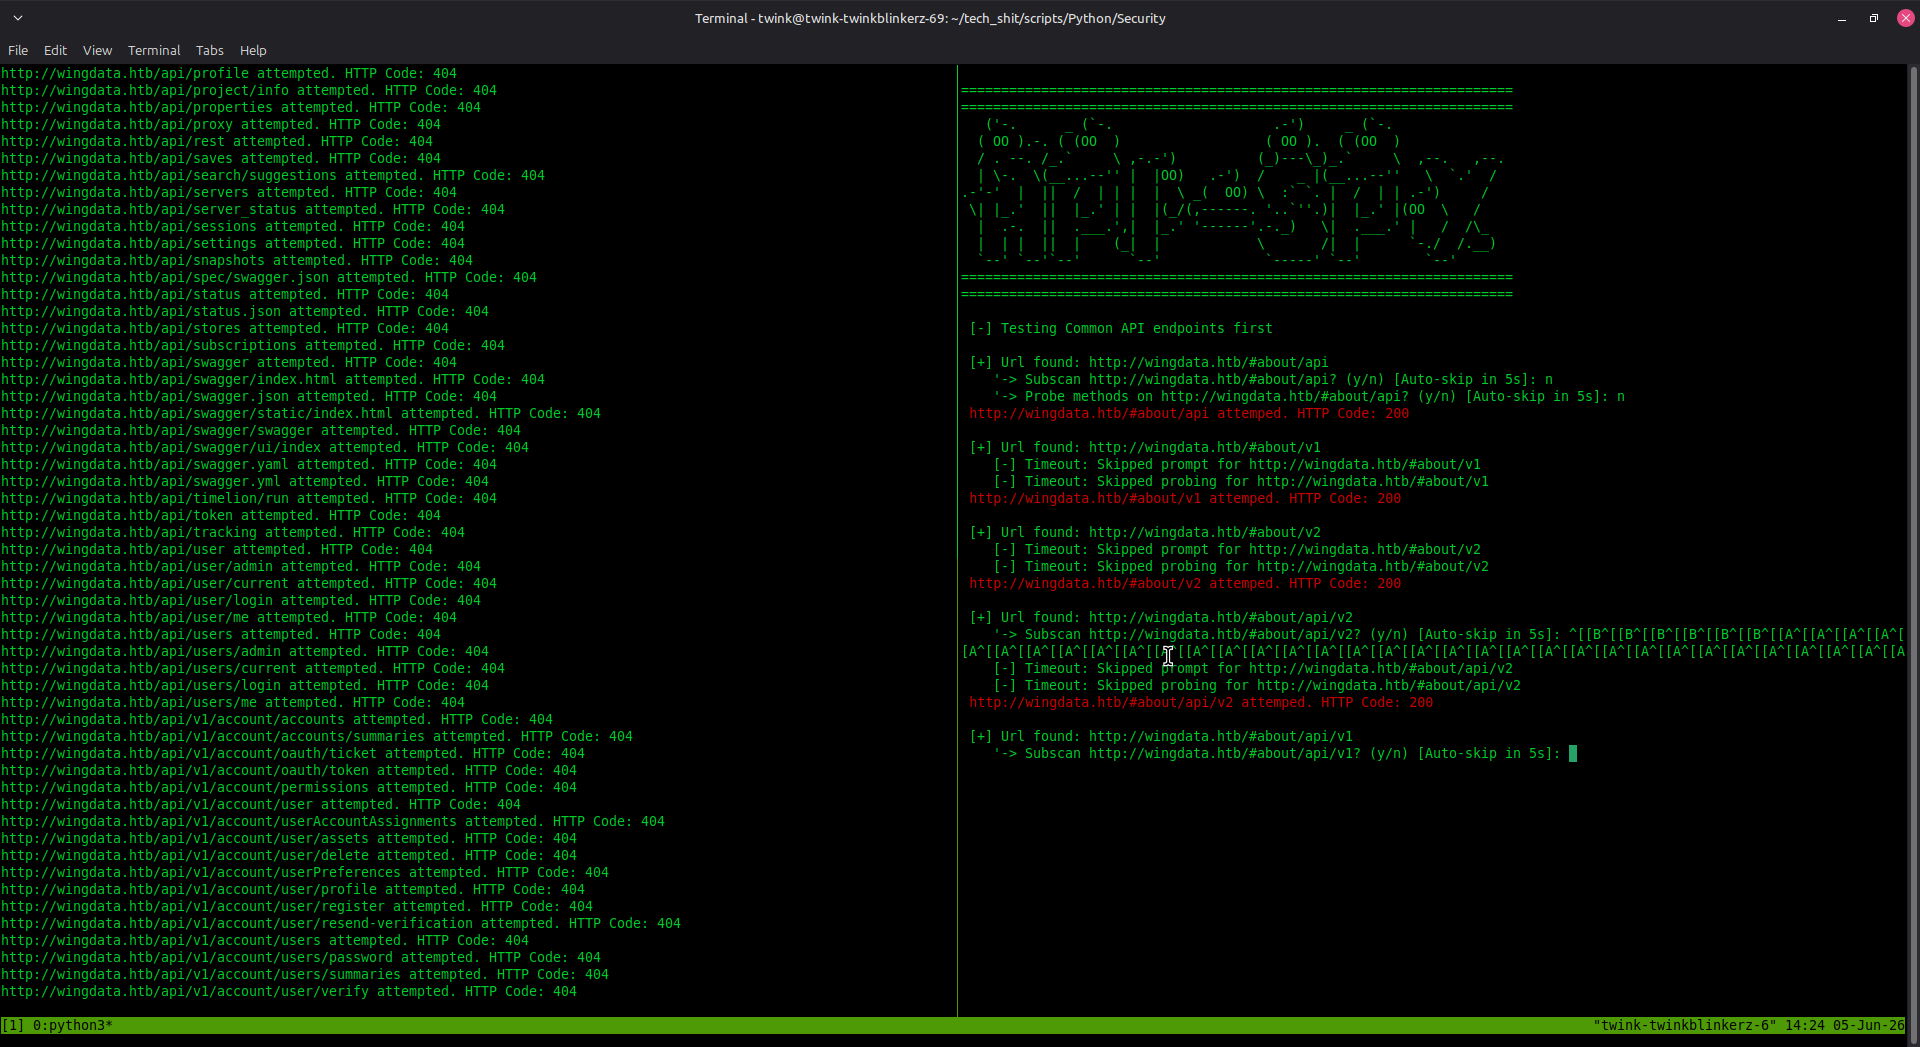
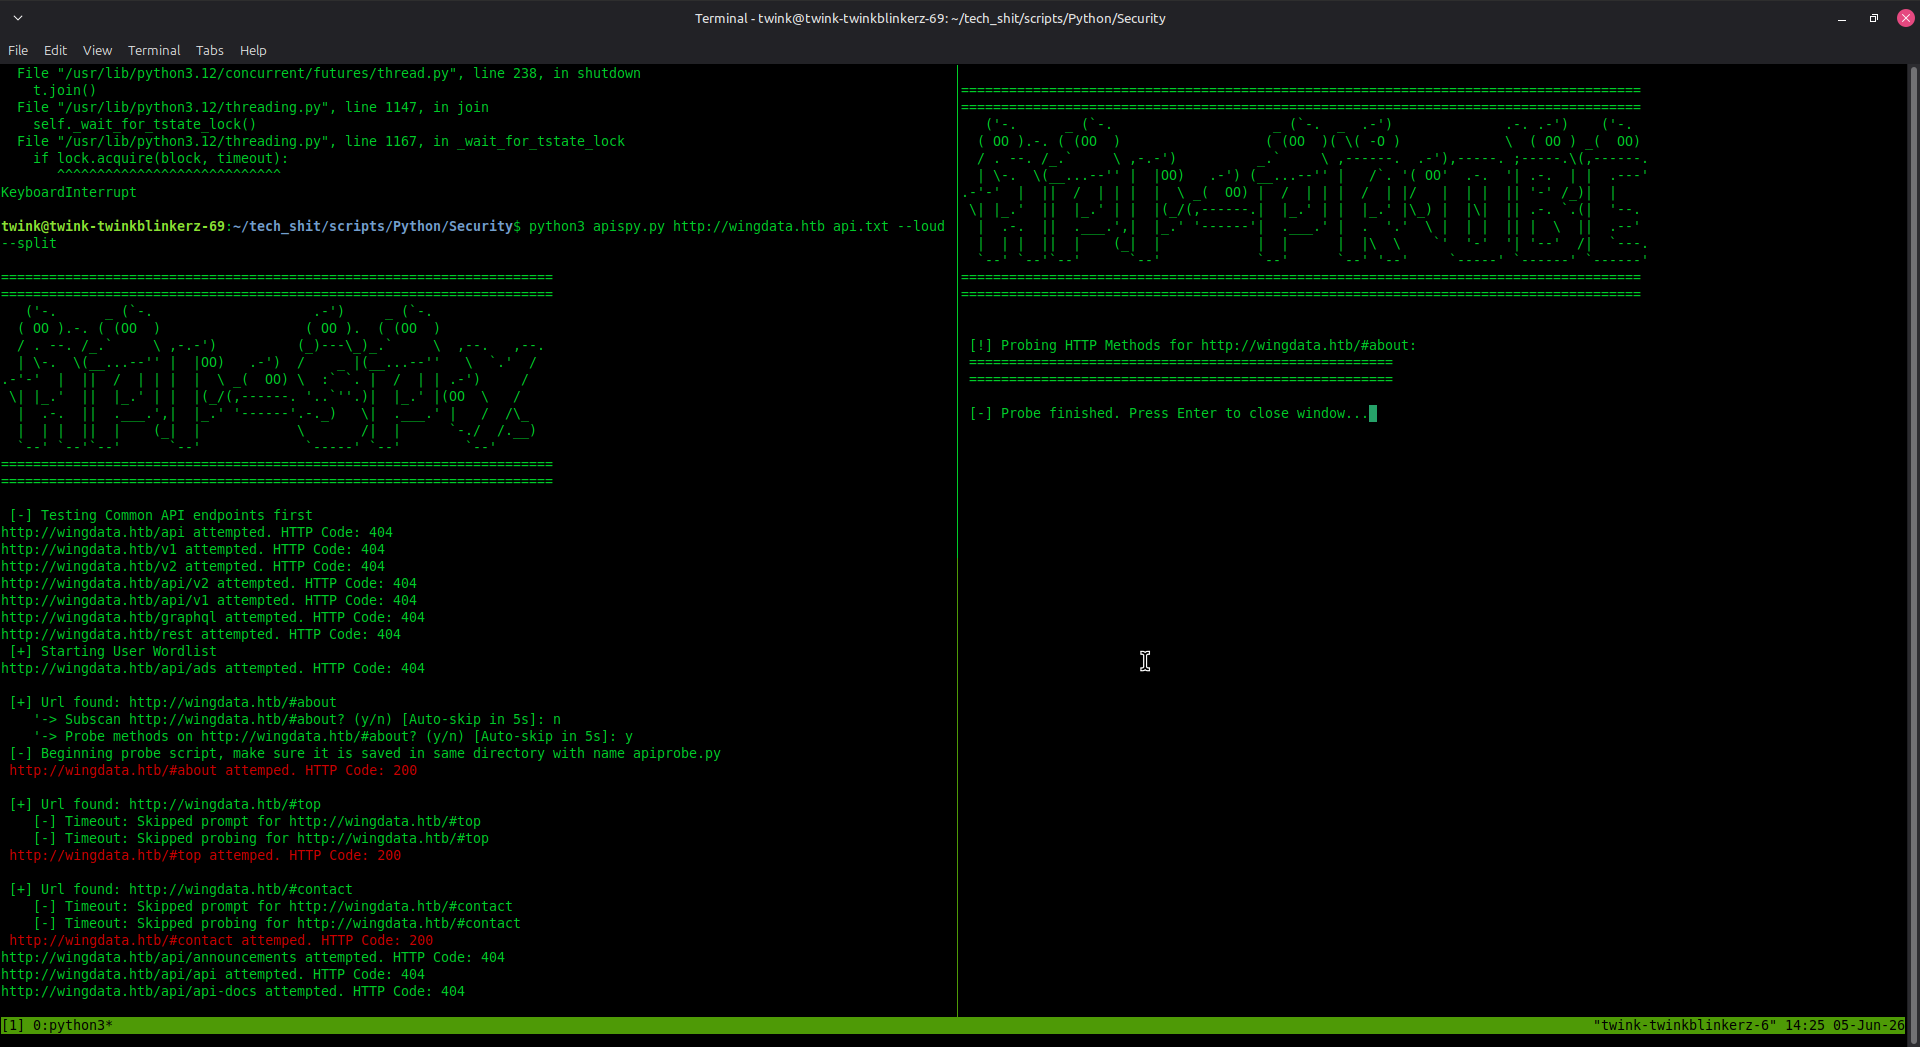
✨ Hauptfunktionen:
requests-Bibliothektmux (optional, für --split-Flag)xfce-terminal (für Linux-Desktop-Umgebungen)# Repository klonen
git clone https://github.com/austinjump-sec/API-SPY.git
cd API-SPY
# Abhängigkeiten installieren
pip install requests
# Skripte ausführbar machen (optional)
chmod +x apispy.py apiprobe.py
python3 apispy.py <baseUrl> <wordlist> [OPTIONEN]
| Argument | Beschreibung |
|---|---|
<baseUrl> | Ziel-URL (z.B. http://example.com oder http://api.example.com) |
<wordlist> | Pfad zur Wordlist-Datei mit Endpunkten (einer pro Zeile) |
| Argument | Beschreibung |
|---|---|
--t<number> | Thread-Anzahl (max. 150, Standard: 1) |
--split | tmux split-window anstelle neuer Terminalfenster verwenden |
--debug | Zeigt sonst verborgene Fehlermeldungen an |
--loud | Zeigt alle Meldungen, positive und Fehler, und hebt solche hervor, die nicht 404 zurückgeben |
--js | Durchsucht JavaScript-Dateien und extrahiert aus gefundenen Dateien gängige hartcodierte API-Endpunkte |
python3 apispy.py http://api.example.com wordlist.txt
python3 apispy.py http://api.example.com wordlist.txt -t10
python3 apispy.py http://api.example.com wordlist.txt -t5 --split
python3 apispy.py http://api.example.com/v1 wordlist.txt -t20
Das Tool beginnt mit dem Testen eines vordefinierten Satzes gängiger API-Pfade:
api, v1, v2, api/v1, api/v2, graphql, rest# beginnen)200, 401, 403Wenn ein Endpunkt gefunden wird, werden Sie gefragt:
'-> Subscan <url>? (j/n) [Auto-Überspringen in 5s]:
j/yes, um diesen Endpunkt rekursiv mit derselben Wordlist zu scannenNach dem Subscanning werden Sie gefragt:
'-> Methoden testen auf <url>? (j/n) [Auto-Überspringen in 5s]:
apiprobe.py, das HTTP-Methoden auf dem entdeckten Endpunkt testetAllow-Header[+] Url gefunden: http://api.example.com/v1 ← 200 OK (zugänglich)
'-> Subscan http://api.example.com/v1? (j/n) [Auto-Überspringen in 0s]:
[-] Timeout: Aufforderung für http://api.example.com/v1? übersprungen
'-> Methoden testen auf http://api.example.com/v1? (j/n) [Auto-Überspringen in 4s]:
[-] Url gefunden, aber nicht erlaubt (403 ERR): ... ← Verboten, existiert aber
[-] Url gefunden, aber nicht erlaubt (401 ERR): ... ← Erfordert Authentifizierung
[+] GET     -> STATUS: 200 OK (Größe: 1024)
[-] POST    -> STATUS: 405 (Größe: 0)
[Header-Hinweis] Allow: GET, HEAD, OPTIONS
Erstellen Sie eine einfache Textdatei mit Endpunkten (einer pro Zeile):
admin
users
api/users
v1/products
v2/customers
/api/v1/auth
/graphql
search
data
config
Hinweis: Zeilen, die mit # beginnen, werden als Kommentare behandelt und ignoriert.
Beliebte API-Wordlists zur Verwendung mit API-SPY:
# Stealth-Modus (niedrige Threads)
python3 apispy.py http://target.com wordlist.txt -t3

# Ausgewogener Modus
python3 apispy.py http://target.com wordlist.txt -t15

# Aggressiver Modus
python3 apispy.py http://target.com wordlist.txt -t50
timeout=5 im Quellcode zur AnpassungStellen Sie sicher, dass der Wordlist-Pfad korrekt und die Datei vorhanden ist:
ls -la /pfad/zur/wordlist.txt
Stellen Sie beim Subscanning sicher:
apispy.pyapiprobe.pyFalls --split fehlschlägt:
sudo apt install tmuxtmux new-session -s scancurl http://ihre-url/check_status()-Funktion
