
 0xsteph/pentest-ai
Open-Source-KI-Pentester, der jeden Befund beweist. Maschinen-Orakel führen jeden Exploit erneut aus; verifizierte Bugs werden mit einer Proof-Kapsel ausgeliefert, die du selbst erneut abspielen kannst.
Es flaggt nicht. Es beweist.


Website · Installation · Warum Verifikation · Benchmarks · Grenzen · Discord
⚠️ Angriffswerkzeug, nur mit Autorisierung testen. Mit der Installation akzeptierst du die AUP und die AGB. Siehe Verantwortungsvolle Nutzung ↓
pip install ptai && ptai demo
ptai demo scannt eine mitgelieferte verwundbare App und gibt 4 findings, 3 oracle-VERIFIED aus.
Es spielt einen Live-Beweis aus einer Proof-Kapsel erneut ab (replay 3/3), führt dann dieselben Routen
gehärtet aus und gibt 0 findings aus.
Zwei Dinge fallen auf. Die Findings erscheinen und verschwinden mit der Schwachstelle, nicht weil das Tool still wurde — das Einzige, was sich zwischen den beiden Läufen geändert hat, ist der Fix. Und eines der vier bleibt ein Kandidat: Der SQLi-Login- Bypass ist real, aber kein Oracle konnte ihn auf dieser Route erneut beweisen, also bekommt er kein Badge. Diese Lücke ist das Produkt, das funktioniert, kein Bug in der Demo.
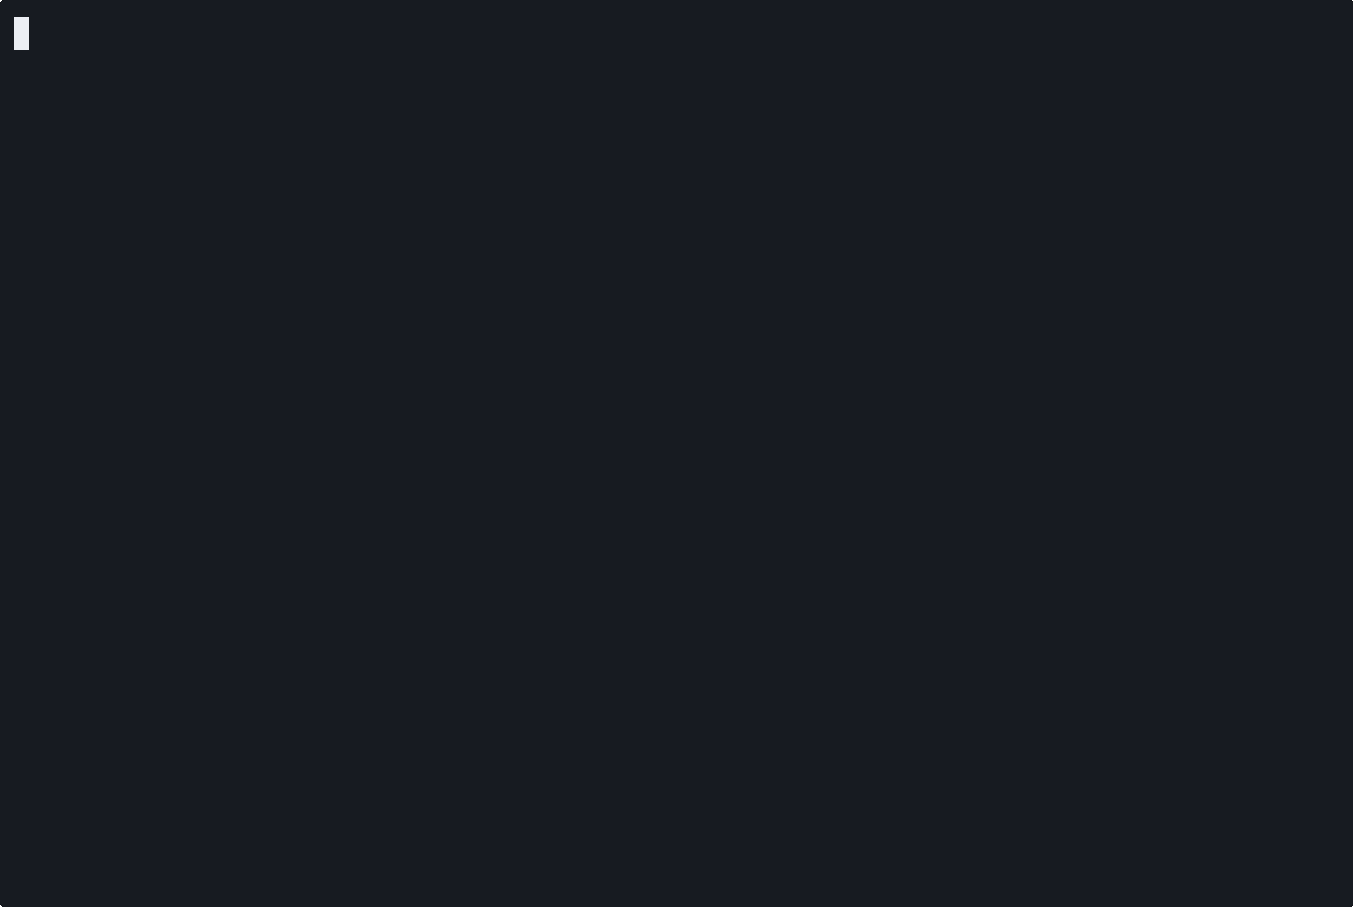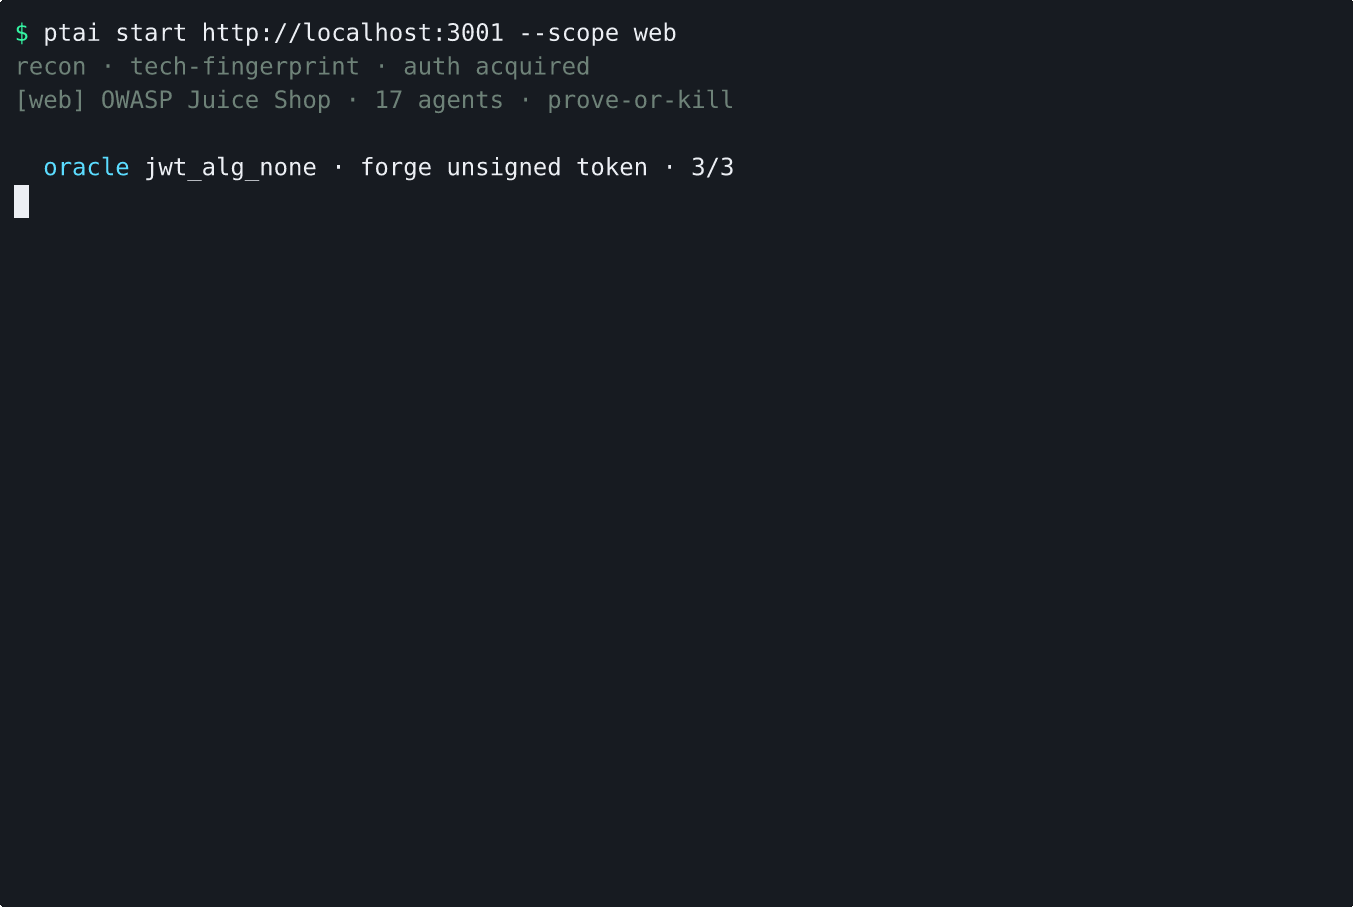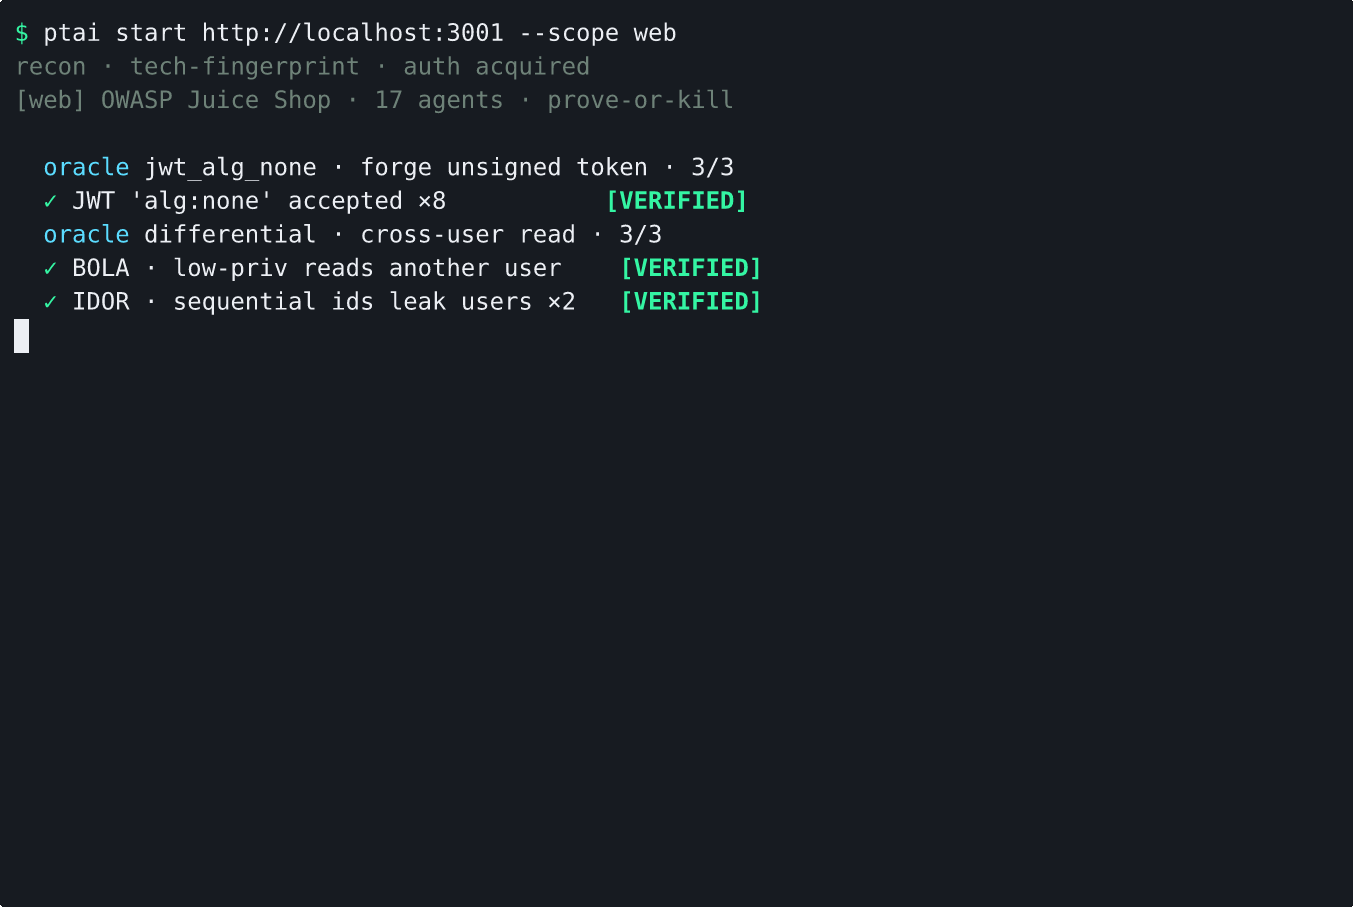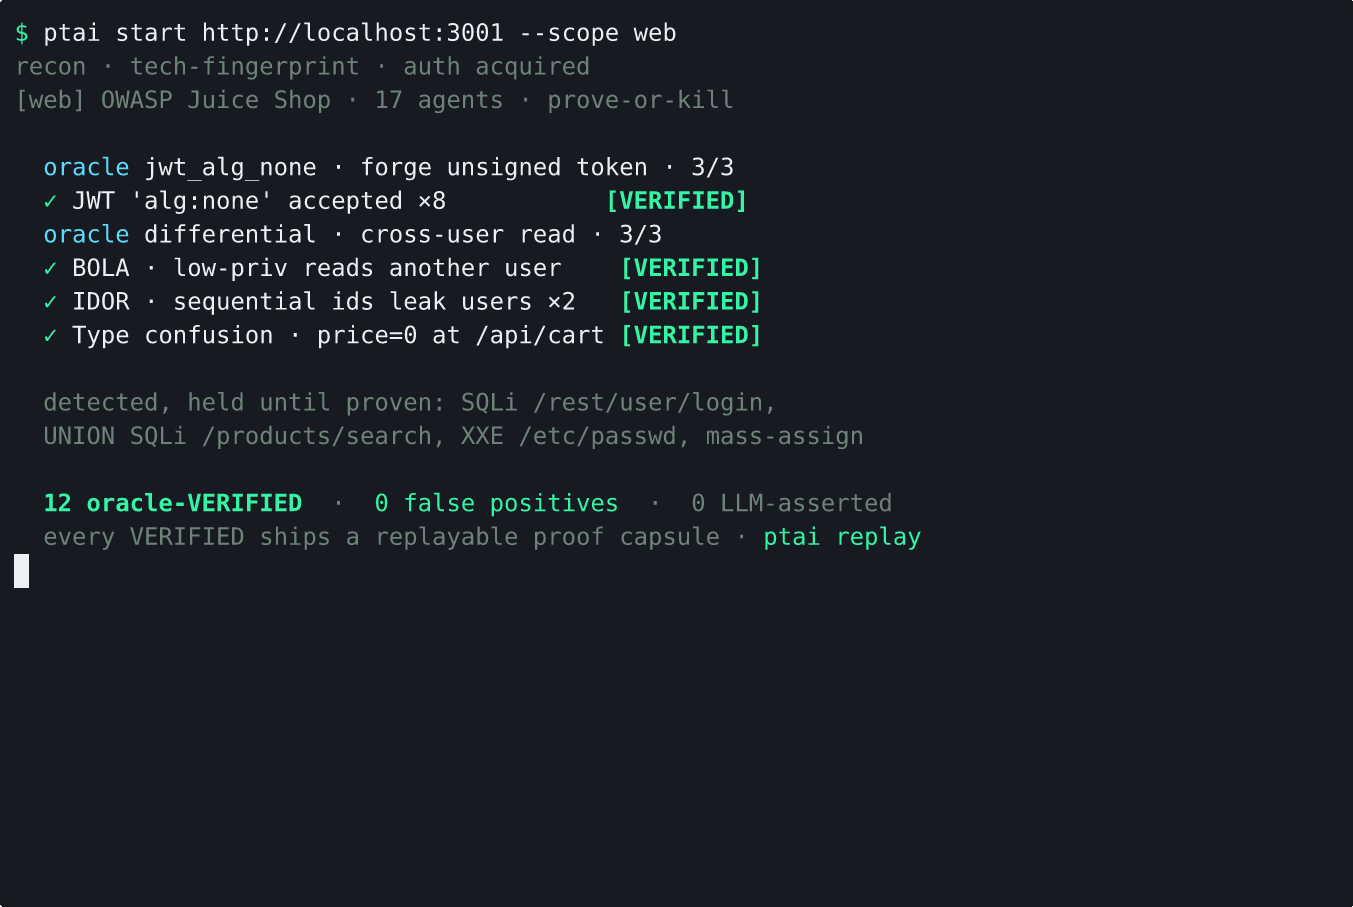
Die meisten Scanner sagen dir, dass etwas möglicherweise ausnutzbar ist, und überlassen das Triage dir. ptai behandelt ein Finding als Kandidaten, bis ein benanntes Maschinen-Oracle den Exploit erneut ausführt und ihn N von N Mal reproduziert. Erst dann verdient es VERIFIED.
Drei Eigenschaften machen das zu mehr als einem Slogan:
Kein LLM erzeugt jemals ein Urteil. Die Regel ist im Code durchgesetzt, nicht durch Richtlinie: Ein Urteil, das das Oracle, das es verdient hat, nicht benennen kann, wird abgelehnt. Ein LLM koordiniert den Lauf und denkt über Ergebnisse nach. Es entscheidet nie, ob ein Bug real ist.
Jedes Oracle hat eine Kontrolle, die fehlschlagen muss. Ein Trusted-Header-Bypass muss privilegierten Inhalt mit dem Header und eine Verweigerung ohne ihn zurückgeben. Ein Leak-Credential-Check muss für das echte Geheimnis akzeptiert und für einen absichtlich korrumpierten Zwilling abgelehnt werden. Ein Endpunkt, der auf alles mit 200 antwortet, verdient nichts. Das verhindert, dass „es gab 200 zurück“ mit einem Beweis verwechselt wird.
Ausgaben von Drittanbieter-Scannern werden zurückgehalten. nuclei-, nikto- und zap-Ergebnisse werden nicht aus eigener Autorität zu Findings. Sie bleiben unverifiziert, bis eines von ptai's eigenen Oracles sie unabhängig erneut beweist.
Jedes VERIFIED-Finding wird als portable Proof-Kapsel geliefert — das Finding, das
Rezept, es erneut zu beweisen, und die Quittung. Jeder kann ptai replay gegen das
Live-Ziel ausführen und zusehen, wie das Oracle erneut bestätigt, ohne ptai zu vertrauen. Kapseln sind
bewusst unsigniert: Replay ist der Vertrauensmechanismus, keine Signatur, die du
im Glauben annehmen musst.
| Schwachstellenklassen mit funktionierendem Oracle | 14 |
| Probes in der Bibliothek | 64 |
| Probes, die VERIFIED verdienen können | 30 |
| Oracle-Arten | 24 |
| Tool-Wrapper | 203 |
| …die heute Ausgabe in Findings parsen | 18 |
| MCP-Tools | 52 |
| Spezialisten-Agenten | 18 |
| Tests | 2.729 auf Python 3.10 / 3.12 / 3.14 |
Auf einem absichtlich verwundbaren Honeypot verifizieren 23 Findings über diese 14 Klassen
mit 100 % Präzision und null False Positives. Auf einem Standard-OWASP-Juice-Shop
verifizierten 17 Findings im Sweep vom 2026-08-23 — Bericht im Scope-HTTP / verifiziert /
Präzision, nicht 17/116. Eine Path-1-MCP-Sitzung vom 2026-08-25 (MCP-Client steuert
run_probe, Ziel starb vor der Orchestrator-Verifikation) verdiente 12 verifizierte Beweise
mit 100 % Präzision gegen 64 im Scope liegende HTTP-Herausforderungen (20 werden nicht verfolgt). OSINT,
Web3 und UI-only Juice-Shop-Schlüssel sind bewusst aus der Automatisierungs-Bestenliste ausgeschlossen.
Lies diese Zahlen sorgfältig, denn die Lücken sind der Punkt. 64 Probes existieren, aber nur 30 können ein Urteil verdienen; die anderen 34 melden ehrliche Kandidaten. 203 Wrapper sind registriert, aber nur 18 verwandeln Tool-Ausgabe in Findings — der Rest läuft und gibt Rohtext zurück. Das Oracle-Gate kauft Präzision, nicht Trefferquote: Es entfernt False Positives, es findet nicht mehr Bugs.
Das Honeypot-Harness (tests/honeypot/) und ein Clean-App-
Gate mit null False Positives (tests/cleanapp/) sind beide in diesem
Repo enthalten und laufen in CI, also sind diese reproduzierbar statt Screenshots.
Klar gesagt, weil ein Sicherheitstool, das sich selbst überverkauft, schlimmer als nutzlos ist.
unsupported statt einer irreführenden Null.ptai playbook run löst Abhängigkeiten auf
und druckt den Plan. Das Ausführen gegen ein Ziel ist noch nicht verdrahtet.Die vollständige interne Defektliste, einschließlich allem oben Genannten, wird offen statt still verfolgt. Wenn hier etwas falsch ist, öffne ein Issue und es wird korrigiert.
Dein bestehendes KI-Abo ist das LLM. ptai liefert die Tools.
pip install ptai
ptai mcp install          # erkennt deine MCP-Clients automatisch und schreibt deren Konfigurationen

