
New releaseSep 19, 2026
urx v0.11.0
Extrahiert URLs aus OSINT-Archiven für Sicherheitseinblicke
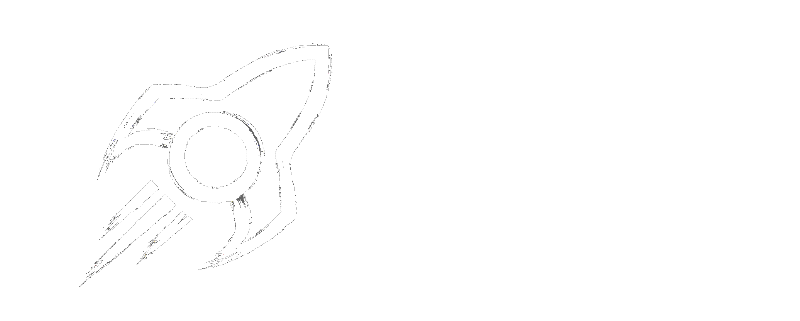
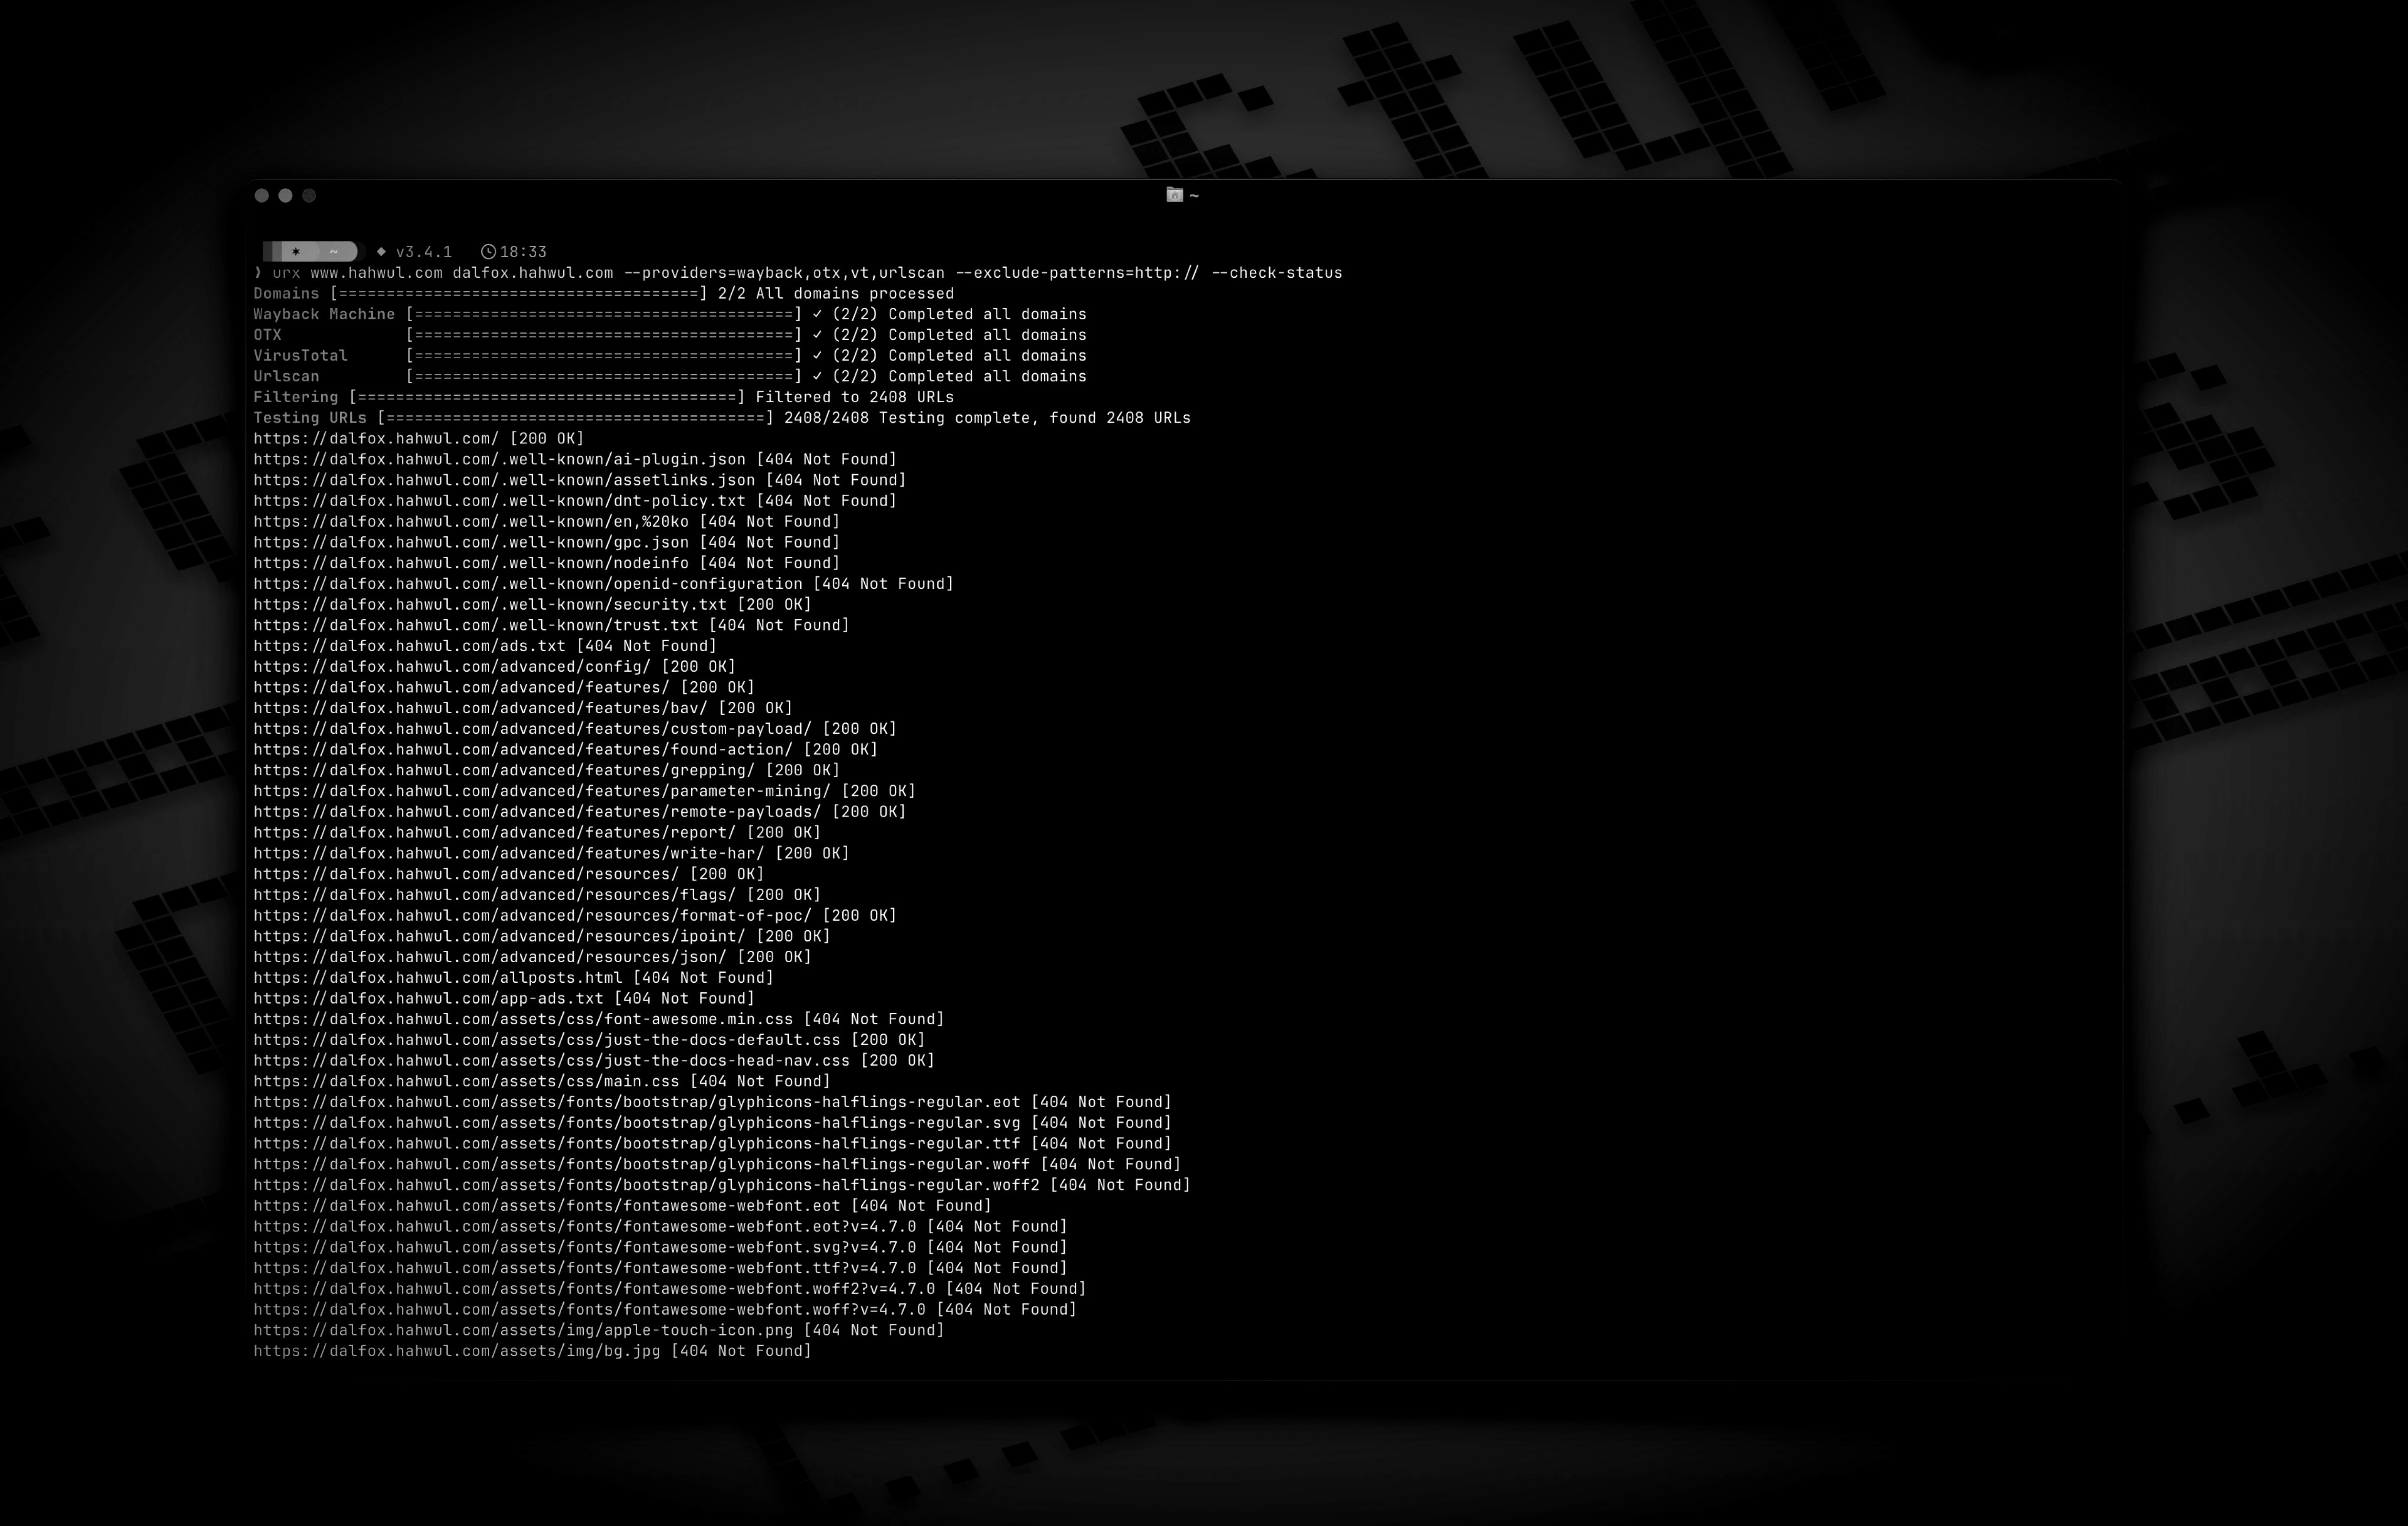
Extrahiert URLs aus OSINT-Archiven für Sicherheitserkenntnisse.



Urx ist ein Kommandozeilen-Tool zum Sammeln von URLs aus OSINT-Archiven wie der Wayback Machine und Common Crawl. Es ist in Rust auf Effizienz ausgelegt und nutzt asynchrone Verarbeitung, um mehrere Datenquellen schnell abzufragen. Das Tool vereinfacht das Sammeln von URL-Informationen für eine bestimmte Domain und liefert einen umfassenden Datensatz, der für verschiedene Zwecke genutzt werden kann, einschließlich Sicherheitstests und -analysen.
Funktionen
- URLs parallel aus mehreren Quellen abrufen (Wayback Machine, Common Crawl, OTX, Arquivo.pt)
- Jeden anderen CDX-Indexserver einbinden — nationale Webarchive, ein privates pywb, OutbackCDX — mit
--cdx-endpoint URL, ohne Codeänderung - Standardmäßig ohne Schlüssel: Wayback, Common Crawl, OTX, Arquivo.pt und URLScan (anonym) funktionieren alle ohne API-Schlüssel
- BeVigil-Provider: URLs, die aus entpackten Android-Apps extrahiert wurden — Endpunkte, die kein Webarchiv je gecrawlt hat
- API-Schlüsselrotation für jeden Provider mit Schlüssel (VirusTotal, URLScan, ZoomEye, GitHub, BeVigil), um Rate Limits zu mildern
- Authentifiziertes Testen:
-H,--cookieund--user-agentgelten für jede Anfrage, die urx an das Ziel stellt (--check-status,--extract-links,--extract-js-endpoints,--expand-specssowie dierobots/sitemap-Probes) und werden bewusst niemals an ein Archiv gesendet - Ergebnisse nach Dateiendungen, Teilstring-Mustern oder vollständigen regulären Ausdrücken filtern (
--match-regex/--filter-regex) - Vordefinierte Presets, sowohl nach Dateifamilie ("no-images", "only-js") als auch nach Sicherheitsinteresse ("only-secrets", "only-backup", "only-config", "only-api")
- Archivseitige Filterung: Statuscode, MIME-Typ und Datumsbereich direkt in die CDX-Abfrage schieben, sodass herausgefilterte Captures nie über das Netzwerk gehen
- Clientseitige Metadatenfilterung (
--meta-*): nach erstem/letztem Capture-Datum, aufgezeichnetem MIME-Typ und aufgezeichnetem Status einheitlich über jeden Provider filtern, nach der Sammlung - Pfadbezogene Ziele:
urx example.com/shopschiebt den Scope direkt in die CDX-Abfrage (url=example.com/shop*), sodass ein Teilbaum einer großen Site nur einen Bruchteil des gesamten Index kostet, statt clientseitig herausgefiltert zu werden - Bug-Bounty-Scope-Dateien (
--scope-file): die eigene*.example.com/!admin.example.com-Liste eines Programms wird wörtlich verwendet, wiederholbar und vereinigt, Ausschlüsse gewinnen immer - URL-Normalisierung und Deduplizierung: Query-Parameter sortieren, abschließende Schrägstriche entfernen, semantisch identische URLs zusammenführen und Fast-Duplikate zusammenfassen, die sich nur in IDs, Hashes oder Datumsangaben unterscheiden (
--dedup-similar) - Unterstützung mehrerer Ausgabeformate: Klartext, JSON, JSON Lines, CSV und
wordlist— die Pfadsegmente und Parameternamen, aus denen das Ziel aufgebaut ist, ohne IDs, Hashes und Datumsangaben - Parameter- und Fuzz-Ansichten:
--params(das gesamte Parameterinventar des Ziels),--params-by-endpoint(welcher Endpunkt was entgegennimmt) und--fuzz-placeholder FUZZ(eine templatisierte URL pro Parametersignatur, bereit für ffuf oder dalfox) - Archiv-Capture-Metadaten:
first_seen,last_seen,mime,archive_statusunddigestkommen mit jeder URL zurück, die ein CDX-Archiv gemeldet hat, ohne zusätzliche Netzwerkkosten - Streaming-Ausgabe (
--stream): URLs werden geschrieben, sobald jeder Provider sie meldet, sodass eine Pipeline sofort arbeitet, statt auf das langsamste Archiv zu warten - Direkte Dateieingabe: URLs direkt aus WARC-Dateien, komprimierten URLTeam-Dateien und Textdateien lesen
- Ergebnisse auf der Konsole oder in einer Datei ausgeben oder über stdin für die Pipeline-Integration streamen
- URL-Testing:
- URLs anhand von HTTP-Statuscodes und Mustern filtern und validieren.
- Zusätzliche Links aus gesammelten URLs extrahieren — Anker, Skripte, Stylesheets, Formularaktionen, Iframes, Bilder, Medienquellen, Objekte, Embeds und Meta-Refresh-Ziele
- Die archivierten Response-Bodies gesammelter URLs durchsuchen (
--archive-body), sodass Seiten, die nicht mehr existieren, noch die Links preisgeben, die sie enthielten — eine Anfrage pro unterschiedlichem Body, dank CDX-Digest-Deduplizierung - Mit
--extract-js-endpointsauch das archivierte JavaScript durchsuchen: Ein Bundle, das nach Build-Hash benannt ist, liefert 404, sobald die Site neu deployt wird, und das Archiv ist der einzige Ort, an dem seine API-Oberfläche noch existiert - Die wiedergegebenen Bodies (
--archive-body-dir) als Korpus behalten, um nach dem zu greppen, wonach kein Link-Extraktor sucht — Entwicklerkommentare, eingebettete Zugangsdaten, interne Hostnamen — ohne zusätzliche Anfragen - API-Spezifikationen erweitern (
--expand-specs): OpenAPI 3.x-, Swagger 2.0- und GraphQL-Introspection-Dokumente, JSON oder YAML, in jede beschriebene Route umgewandelt — eine Anfrage kauft die gesamte dokumentierte Oberfläche - Response-Metadaten:
--check-statuszeichnet auchLocation,Content-LengthundContent-Typeauf, und--check-titlefügt den HTML-<title>hinzu
- Archivierte robots.txt- und sitemap.xml-Erkennung (
--archived-discovery): jede unterschiedliche Version, die die Wayback Machine besitzt, sodass einDisallow:aus 2015 noch die Pfade nennt, die die Site seither nicht mehr erwähnt - Caching und inkrementelles Scannen:
- Lokales SQLite- oder entferntes Redis-Caching, um erneutes Scannen von Domains zu vermeiden (Redis erfordert einen Build mit
--features redis-cache; Paket-Builds lassen es weg) - Inkrementeller Modus, um nur neue URLs seit dem letzten Scan zu entdecken
- Konfigurierbare Cache-TTL; jeder Scan räumt Einträge älter als das Doppelte der TTL auf, und
urx cache pruneentfernt alles darüber hinaus urx cache-Unterbefehl zum Inspizieren und Pflegen des Caches:stats,list,prune,drop <domain>,clear
- Lokales SQLite- oder entferntes Redis-Caching, um erneutes Scannen von Domains zu vermeiden (Redis erfordert einen Build mit
Installation
Aus Cargo
# https://crates.io/crates/urx
cargo install urx
Über Homebrew
# https://formulae.brew.sh/formula/urx
brew install urx
Aus der Quelle
git clone https://github.com/hahwul/urx.git
cd urx
cargo build --release
Das kompilierte Binary ist unter target/release/urx verfügbar.