bbot v3.0.1
Der rekursive Internet-Scanner für Hacker. 🧡




BEE·bot ist ein vielseitiger Scanner, inspiriert von Spiderfoot, der entwickelt wurde, um deine Recon, Bug-Bounties und ASM zu automatisieren!
https://github.com/blacklanternsecurity/bbot/assets/20261699/e539e89b-92ea-46fa-b893-9cde94eebf81
Ein BBOT-Scan in Echtzeit – Visualisierung mit VivaGraphJS
Installation
# stable version
pipx install bbot

# bleeding edge (dev branch)
pipx install --pip-args '\--pre' bbot
Weitere Installationsmethoden, einschließlich Docker, findest du unter Erste Schritte
Upgrade von 2.x? BBOT 3.0 enthält Breaking Changes an CLI, Presets, Modulen, Events und der Python-API. Siehe den Migrationsleitfaden 2.x → 3.0 (Quelle) vor dem Upgrade.
Tempo-Tipp: BBOTs DNS-Resolver (blastdns) startet mehrere Threads pro Resolver in
/etc/resolv.conf. Das Hinzufügen weiterer ungefilterter Resolver beschleunigt Scans erheblich. Siehe die Beispiel-resolv.conf und Tipps und Tricks für Details.
Beispielbefehle
1) Subdomain-Finder
Passive API-Quellen plus rekursiver DNS-Bruteforce mit zielspezifischen Subdomain-Mutationen.
# find subdomains of evilcorp.com
bbot -t evilcorp.com -p subdomain-enum

# passive sources only
bbot -t evilcorp.com -p subdomain-enum -rf passive
subdomain-enum.yml
description: Enumerate subdomains via APIs, brute-force

flags:
  # enable every module with the subdomain-enum flag
  - subdomain-enum

output_modules:
  # output unique subdomains to TXT file
  - subdomains

config:
  dns:
    threads: 25
    brute_threads: 1000
  # put your API keys here
  # modules:
  #   github:
  #     api_key: ""
  #   chaos:
  #     api_key: ""
  #   securitytrails:
  #     api_key: ""
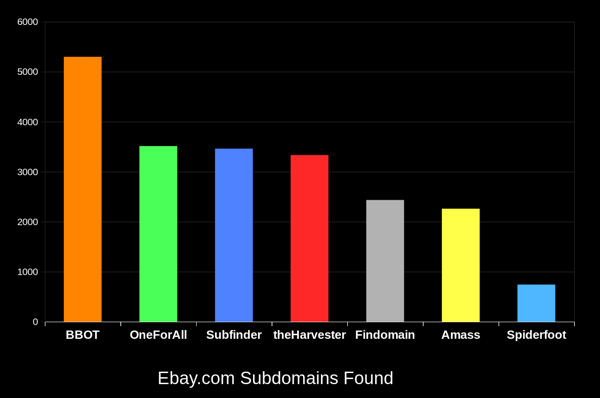
BBOT findet durchweg 20–50 % mehr Subdomains als andere Tools. Je größer die Domain, desto größer der Unterschied. Um zu erfahren, wie das möglich ist, siehe So funktioniert es.
2) Web-Spider
# crawl evilcorp.com, extracting emails and other goodies
bbot -t evilcorp.com -p spider
spider.yml
description: Recursive web spider

modules:
  - http

blacklist:
  # Prevent spider from invalidating sessions by logging out
  - "RE:/.*(sign|log)[_-]?out"

config:
  web:
    # how many links to follow in a row
    spider_distance: 2
    # don't follow links whose directory depth is higher than 4
    spider_depth: 4
    # maximum number of links to follow per page
    spider_links_per_page: 25
3) E-Mail-Gatherer
# quick email enum with free APIs + scraping
bbot -t evilcorp.com -p email-enum

# pair with subdomain enum + web spider for maximum yield
bbot -t evilcorp.com -p email-enum subdomain-enum spider
email-enum.yml
description: Enumerate email addresses from APIs, web crawling, etc.

flags:
  - email-enum

output_modules:
  - emails
4) Web-Scanner
# run a light web scan against www.evilcorp.com
bbot -t www.evilcorp.com -p web

# run a heavy web scan against www.evilcorp.com
bbot -t www.evilcorp.com -p web-heavy
web.yml
description: Quick web scan

include:
  - iis-shortnames

flags:
  - web
web-heavy.yml
description: Aggressive web scan

include:
  # include the web preset
  - web

flags:
  - web-heavy
5) Alles überall auf einmal
# everything everywhere all at once
bbot -t evilcorp.com -p kitchen-sink

# roughly equivalent to:
bbot -t evilcorp.com -p subdomain-enum cloud-enum code-enum email-enum spider web paramminer webbrute web-screenshots
kitchen-sink.yml
description: Everything everywhere all at once

include:
  - subdomain-enum
  - cloud-enum
  - code-enum
  - email-enum
  - spider
  - web
  - paramminer
  - webbrute
  - web-screenshots
  - baddns-heavy

config:
  modules:
    dnsbrute:
      recursive_mutations: true
    dnscommonsrv:
      recursive_mutations: true
    webbrute:
      avoid_wafs: False
    wayback:
      urls: True
      parameters: True
      archive: True
So funktioniert es
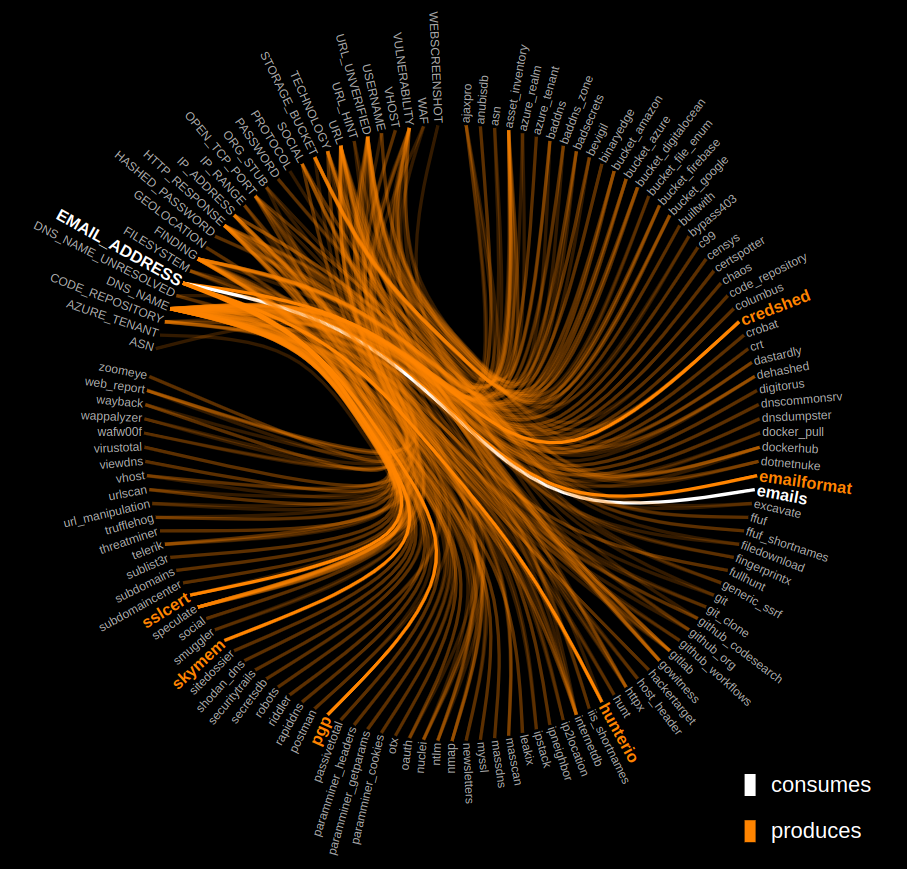
Klicke auf das Diagramm unten, um die inneren Abläufe von BBOT zu erkunden.