
 #1
Tools für LLM-Sicherheit, Prompt-Injection, Modellextraktion, adversariales KI und KI-Red-Teaming.
Kitploit empfohlen

 vighnesh91/-logicsentry-ai
Offline-SAST/DAST-Triage-Engine, die Quellcode parst und HAR-Verkehr wiedergibt, um Business-Logic-Fehler, BOLA, Race Conditions und…
 dragonjar/burpia
Burp Suite-Erweiterung, die passive Schwachstellenerkennung mittels künstlicher Intelligenz integriert.
 mafifrizi/tanuki
Tactical Identity Operator for Linux & Hybrid Active Directory
 anthropics/oss-scanner
Dienst, der registrierte Open-Source-Repositories in isolierten Offline-VMs baut und sie auf Sicherheitslücken scannt, wobei Ergebnisse per E-Mail…
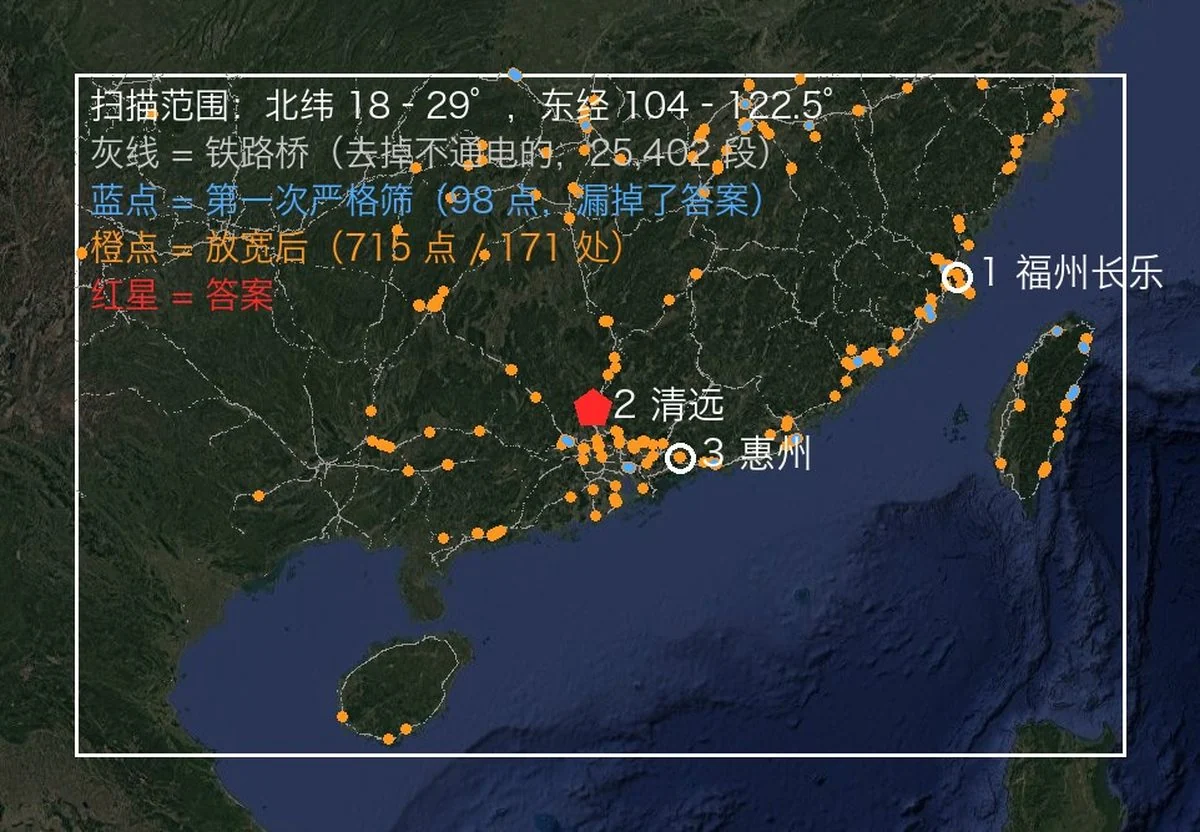 oldcircle/geo-sleuth
Ein Agent-Skill, der herausfindet, wo ein Foto aufgenommen wurde — OpenStreetMap-Geometrie, Höhenprofile, Satellitenbilder und Street View — und…
 ye-ze-yu/epireal-bench
Red-Teaming-Benchmark und Black-Box-Angriffsframework zur Bewertung von Risiken visueller Fehlinformationen bei kommerziellen Bildgeneratoren, mit…
 phil-fan/fs-attack
Implementierung des Papers „Rethinking Latency Denial-of-Service: Attack the LLM Serving Framework, Not the Model“
 multimodal-ai-lab/tobac
Token für Token kompromittiert: Backdoor-Schwachstellen in Unified Autoregressive Models (NeurIPS'26)
 moontea0416/webmirage
Adversariale Bildangriffe auf Vision-Language-Web-Agenten, vom visuellen Grounding bis zur Browser-Ausführung
 stardust457/sldr
Verteidigungsframework, das bösartiges Fine-Tuning von LLMs durch selektive Schichtwiederherstellung und dynamisches Routing abschwächt, mit…
 danigil/neuperm
Null-Retraining-Sanitisierung, die permutationselektive neuronale Netzwerkeinheiten neu anordnet, um Malware zu zerstören, die durch…
 graph-com/cka-agent
Forschungsimplementierung eines LLM-Jailbreak-Agenten, der die Guardrails kommerzieller Modelle durch harmloses Prompt-Weaving und adaptive Baumsuche…
 treeai-lab/awesome-rag-security
Kuratierte Sammlung von Forschungsarbeiten zur Sicherheit von retrieval-augmentierter Generierung, organisiert nach der SLOT-Taxonomie, die…
 githubsecuritylab/seclab-taskflow-agent
MCP-fähiges Multi-Agenten-Framework für deklarative, YAML-gesteuerte agentische Workflows, verwendet für KI-gestütztes Code-Auditing,…
 githubsecuritylab/seclab-taskflows
Beispielhafte KI-Agent-Taskflows und MCP-Server zum Auditieren von Quellcode, Triage von Issues und Erkennen von Schwachstellen in Web-, Android- und…
 uiuc-kang-lab/persistbd
Forschungscode zum Trainieren von Adaptern, die LLM-Agent-Backdoors benignes Fine-Tuning überleben lassen, mit Trigger-Rate-Bewertung,…
 deep-jlu/skillpoison
Forschungspipeline, die verifizierte erfolgreiche Erfahrungen konstruiert und sie in Ausbildungsdatensätze organisiert, um Modellfähigkeiten über die…
 zju-llm-safety/ascent
Fine-Tuning-Framework, das eine First-Order-Optimal-Safety-Kalibrierung und periodische Rekalibrierung auf LLMs anwendet, wobei sicherheitskompatible…








