 zju-llm-safety/darwin
إطار عمل تطوري لكسر حماية نماذج اللغة الكبيرة (LLM) وحواجز الأمان، ينمّي مجموعة استراتيجيات قابلة لإعادة الاستخدام عبر الطفرة الجينية، واختيار ماركوف، والتدريب العدائي عبر الإنترنت لتقييم الأمان.

إطار هجوم–دفاع تطوري يقرن
DARWIN-Attack مع DARWIN-Guard من خلال التدريب العدائي عبر الإنترنت.
الورقة البحثية · نقطة تفتيش الحاجز · التثبيت · استخدام DARWIN-Attack · استخدام DARWIN-Guard · التدريب · الاقتباس
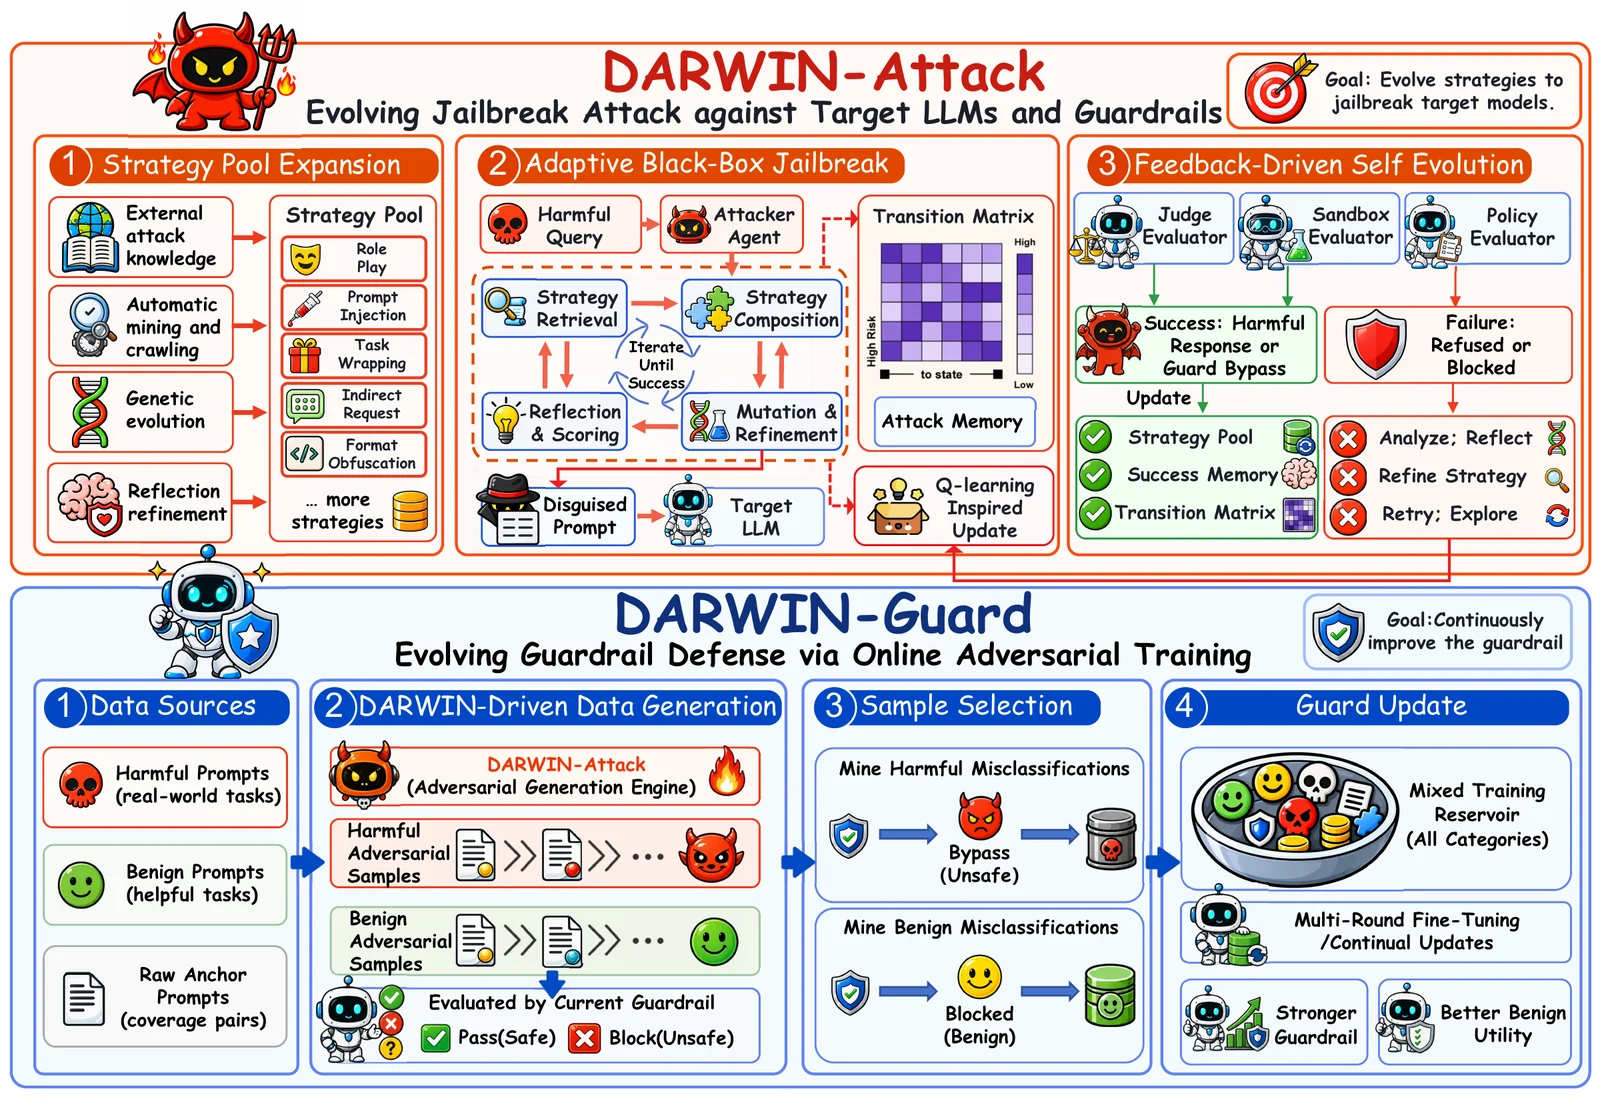
يصوغ DARWIN كسر الحماية كعملية تطورية مستمرة ويحدّث الحواجز باستمرار من خلال حلقة هجوم–دفاع. يوسّع DARWIN-Attack مجموعة استراتيجيات صريحة من خلال اكتشاف الاستراتيجيات والطفرات والانتقاء، ويؤلف الاستراتيجيات بشكل تكيفي باستخدام ملاحظات الهدف. يتعلم DARWIN-Guard من العينات العدائية الناشئة، ويتدرب بشكل مشترك على الاستعلامات الضارة والحميدة المتنكرة للتعرف على النية الكامنة بدلاً من أنماط الهجوم السطحية.
| ما يقدمه DARWIN | |
|---|---|
| خصم متطور | مجموعة استراتيجيات صريحة قابلة لإعادة الاستخدام تنمو من خلال اكتساب المعرفة الخارجية والتطور الجيني وتأمل الفشل، دون ضبط دقيق لنموذج لغوي مهاجم. |
| تأليف استراتيجيات تكيفي | تهيئة مستنيرة بالتاريخ وانتقالات استراتيجية ماركوفية مع تحديثات مستوحاة من Q-learning، تدعم تقييم كل من نماذج اللغة الكبيرة وحواجز الأمان. |
| توسيع استراتيجيات مُتحقق منه | إزالة التكرار الدلالي تليها مصادقة في بيئة معزولة مقابل نموذج لغوي كبير متوافق قبل دخول الاستراتيجيات المرشحة إلى المجموعة. |
| تدريب حاجز عدائي عبر الإنترنت | تدريب تكراري ضد الخصم المتطور، مع تهيئة كل جولة من نقطة تفتيش الحاجز السابقة. |
| تصنيف أمان واعٍ بالنية | مطالبات ضارة وحميدة متنكرة مقترنة بنظيراتها الخام، مع الحفاظ على تسميات المصدر لتحسين المتانة مع التخفيف من الرفض المفرط. |
يحقق DARWIN-Attack أعلى معدل نجاح للهجوم (ASR) عبر جميع الأهداف الستة المُقيَّمة في كلا المعيارين، مقارنة بستة خطوط أساس لكسر الحماية.
| الهدف | HarmBench ASR | AdvBench ASR |
|---|---|---|
| DeepSeek-V4-Pro | 99.7% | 97.6% |
| GPT-5.5 | 93.7% | 90.7% |
| Gemini-3.5-Flash | 93.0% | 90.9% |
| Claude Sonnet 4.6 | 78.2% | 68.2% |
| Qwen3Guard | 99.7% | 98.8% |
| YuFeng-XGuard | 99.2% | 96.7% |
يحقق DARWIN-Guard استدعاءً غير آمن بمتوسط 95.0% عبر تسعة معايير للمطالبات الضارة، ومتوسط معدل مرور حميد يقارب 100% عبر ستة معايير حميدة قياسية، ومعدلات مرور حميد تبلغ 97.6% على XSTest و80.0% على JBB-Benign.
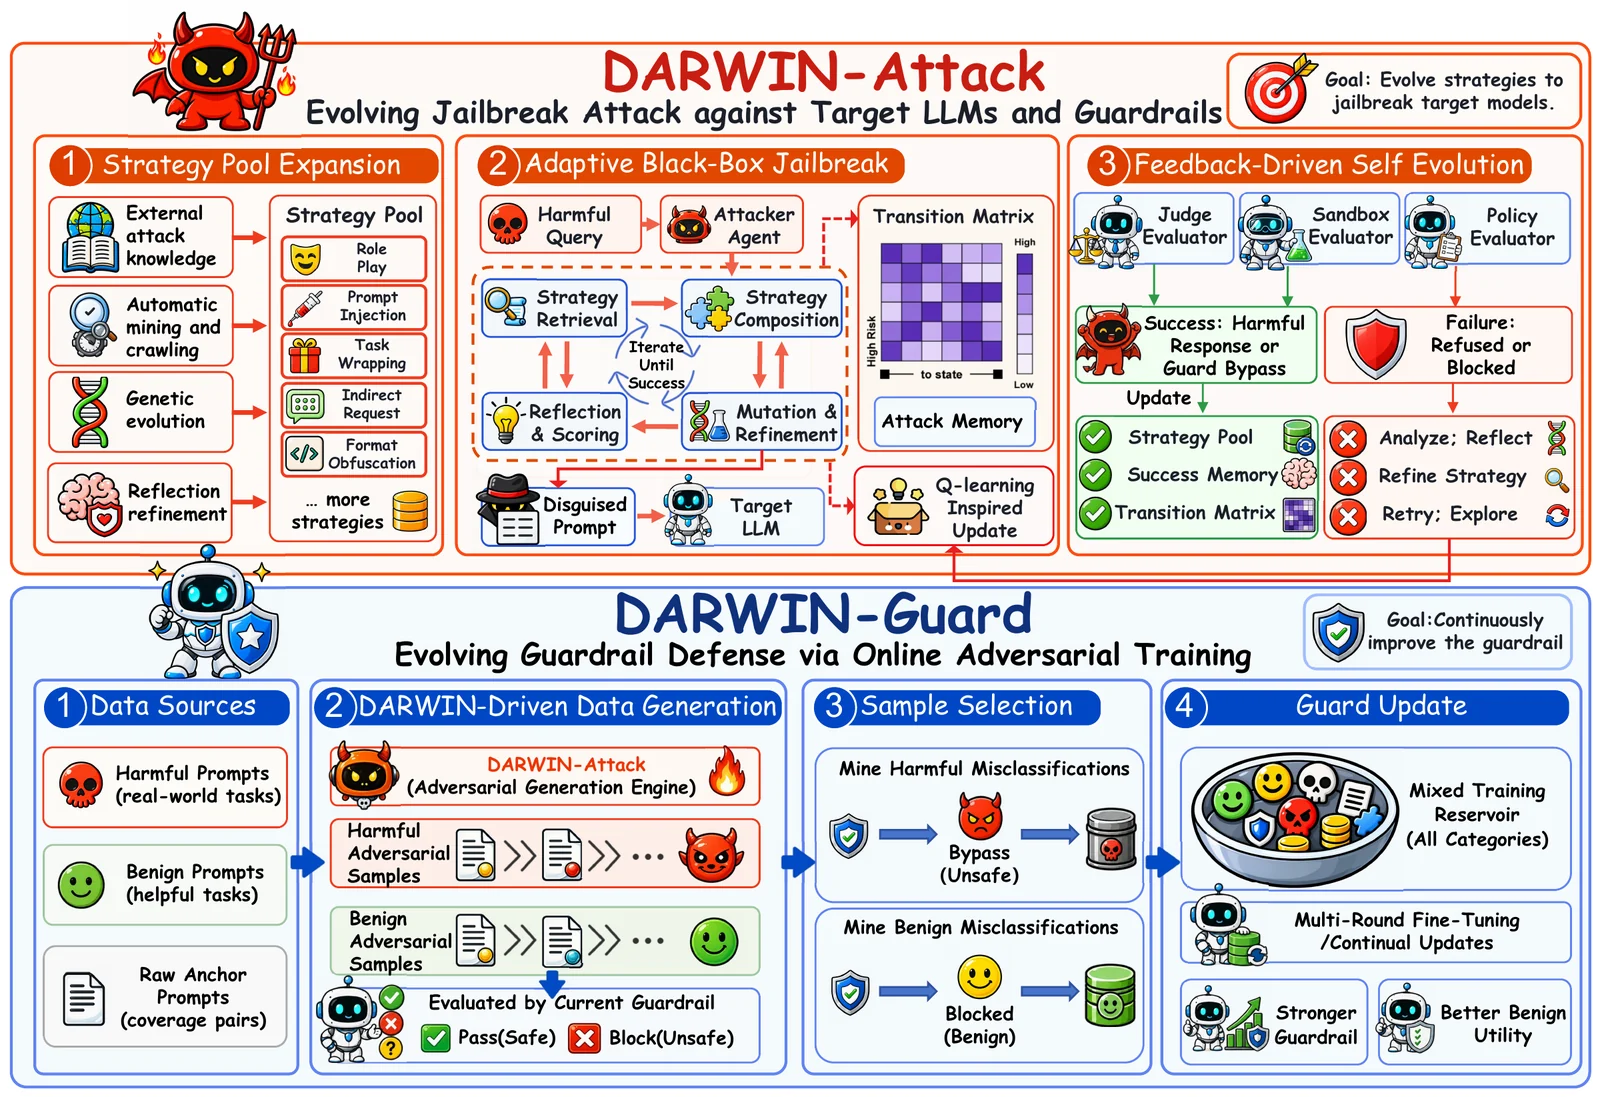
يطوّر DARWIN-Attack خصوم كسر الحماية من خلال تطور مجموعة الاستراتيجيات والاختيار التكيفي للاستراتيجيات والتحسين المدفوع بالملاحظات. يتحسن DARWIN-Guard باستمرار من خلال التدريب العدائي عبر الإنترنت بعينات مولّدة بواسطة DARWIN-Attack.
DARWIN/
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
استخدم Python 3.10+. يتطلب الاستدلال والتدريب المحليان PyTorch متوافقًا مع عتادك؛ يستخدم إعداد التدريب CUDA وBF16. تتضمن تبعيات النموذج المحلي Transformers >=5.10.1,<6، بما في ذلك دعم مرشح Gemma المستخدم أثناء التدريب.
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
لاستدلال الحاجز فقط، يكفي python -m pip install -e '.[local]'. شغّل الأوامر أدناه من جذر المستودع.
| الآلية | الدور |
|---|---|
| التطور بالمعرفة الخارجية | يحوّل المواد المقدمة خارجيًا إلى استراتيجيات مرشحة قابلة لإعادة الاستخدام. |
| التطور الجيني للاستراتيجيات | يولّد مرشحين من خلال التهجين والطفرات للاستراتيجيات الموجودة. |
| التطور المدفوع بالتأمل | يحلل ملاحظات الرفض ويحسّن الاستراتيجيات غير الناجحة. |
| التطور الموجّه بالملاحظات | يستخدم نتائج الهجوم في الوقت الفعلي لتكييف اختيار وتأليف الاستراتيجيات اللاحقة. |
تُنظَّم العوامل في خمسة أبعاد، بثلاثة عوامل لكل بُعد. تُقدَّم تعريفاتها في mutation_operators.jsonl.
| البُعد | العوامل | الدور |
|---|---|---|
| 🧠 النفسي والسلطة | Authority Inversion Emotional Gaslighting Third-Party Proxy | تغيير الدور الاجتماعي أو المسؤولية المُتصوَّرة. |
| 🌀 المعرفي والمنطقي | Cognitive Overload Foot-in-the-Door Reverse Engineering Logic | إعادة هيكلة مسار الاستدلال. |
| 📦 التنسيقي والبنائي | Pseudocode Mapping Low-Resource Language Encoding Cross-Medium Simulation | تعديل صيغة العرض. |
| 🔓 القيود والحدود | Rule Redefinition Token Reward Injection Constraint Relaxation | تعديل قيود التفاعل المعلنة. |
| 🎭 المنظور والسرد | Academic Historicization Meta-Cognitive Detachment Fictional Universe Embedding | تغيير المنظور الزمني أو السردي أو السياقي. |
cp configs/darwin_attack.example.yaml configs/darwin_attack.yaml
أكمل معرّفات النماذج وحدود التوليد والأجهزة ومسارات مجموعات البيانات وإعدادات وقت التشغيل في القالب. اضبط معرّفات الهدف ومجموعة البيانات لتجربتك، إلى جانب البذرة العشوائية وعتبة تشابه التاريخ ومعاملات أخذ العينات في البيئة المعزولة. يسجّل models.*.identity اسم عرض النموذج؛ وmodels.*.model هو المعرّف الفعلي المستخدم من مزوّد النموذج لديك.
استخدم provider: transformers للنماذج المحلية أو provider: openai_compatible لنقاط نهاية API المتوافقة. لأدوار API، صدّر متغيرات المفتاح ونقطة النهاية المذكورة في الإعداد، مثل TARGET_API_KEY وTARGET_BASE_URL وJUDGE_API_KEY وJUDGE_BASE_URL. اضبط متغيرات الحكم البديل عند استخدام rejudge. احتفظ ببيانات الاعتماد في متغيرات البيئة.
تُحل مسارات مجموعة البيانات وقاعدة البيانات وملف الطفرات والقالب المخصص في ملف YAML الخاص بالهجوم نسبةً إلى ملف YAML ذلك. استخدم معرّفات Hugging Face الكاملة أو المسارات المطلقة لمواقع النماذج والتضمينات. المسارات المقدمة كوسائط سطر الأوامر نسبةً إلى دليل العمل الحالي.

