 ucsb-mlsec/vulnllm-r
نموذج لغوي كبير (LLM) متخصص في الاستدلال لكشف الثغرات في الكود المصدري بلغتي C/C++ وPython، مع بناء مجموعات البيانات، وتدريب SFT/DPO، ونصوص برمجية لإعادة إنتاج النتائج.

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
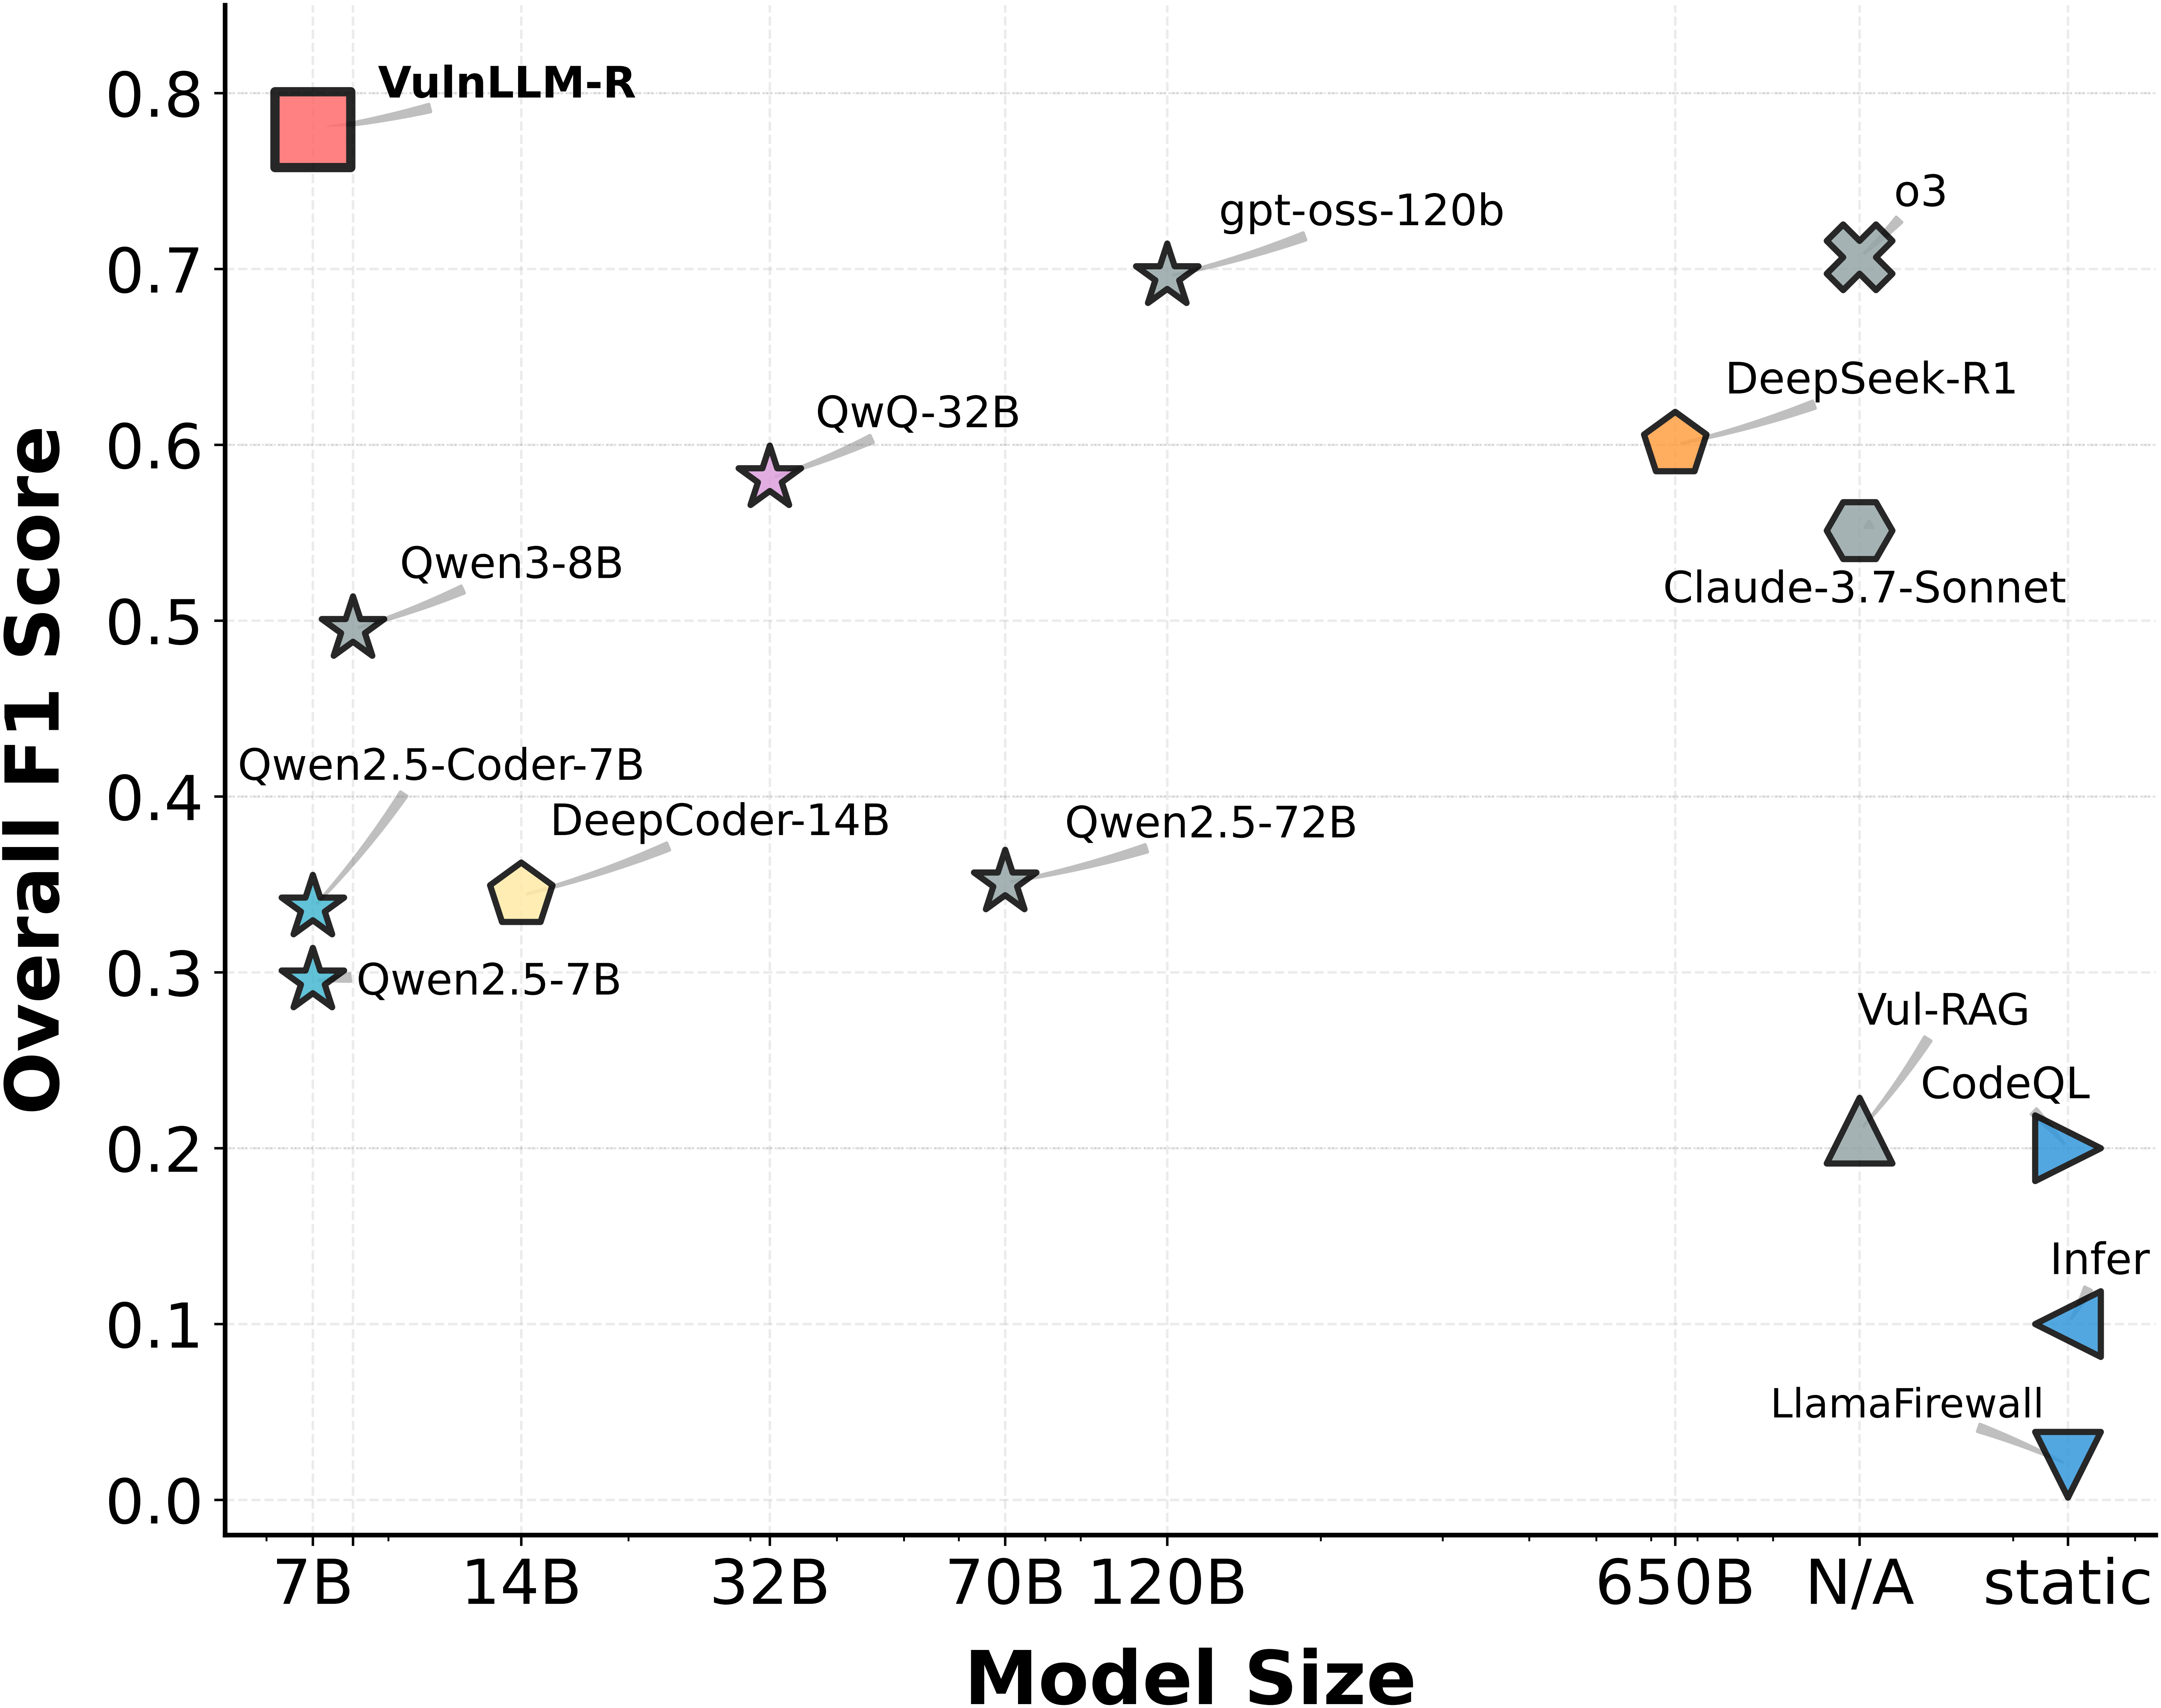
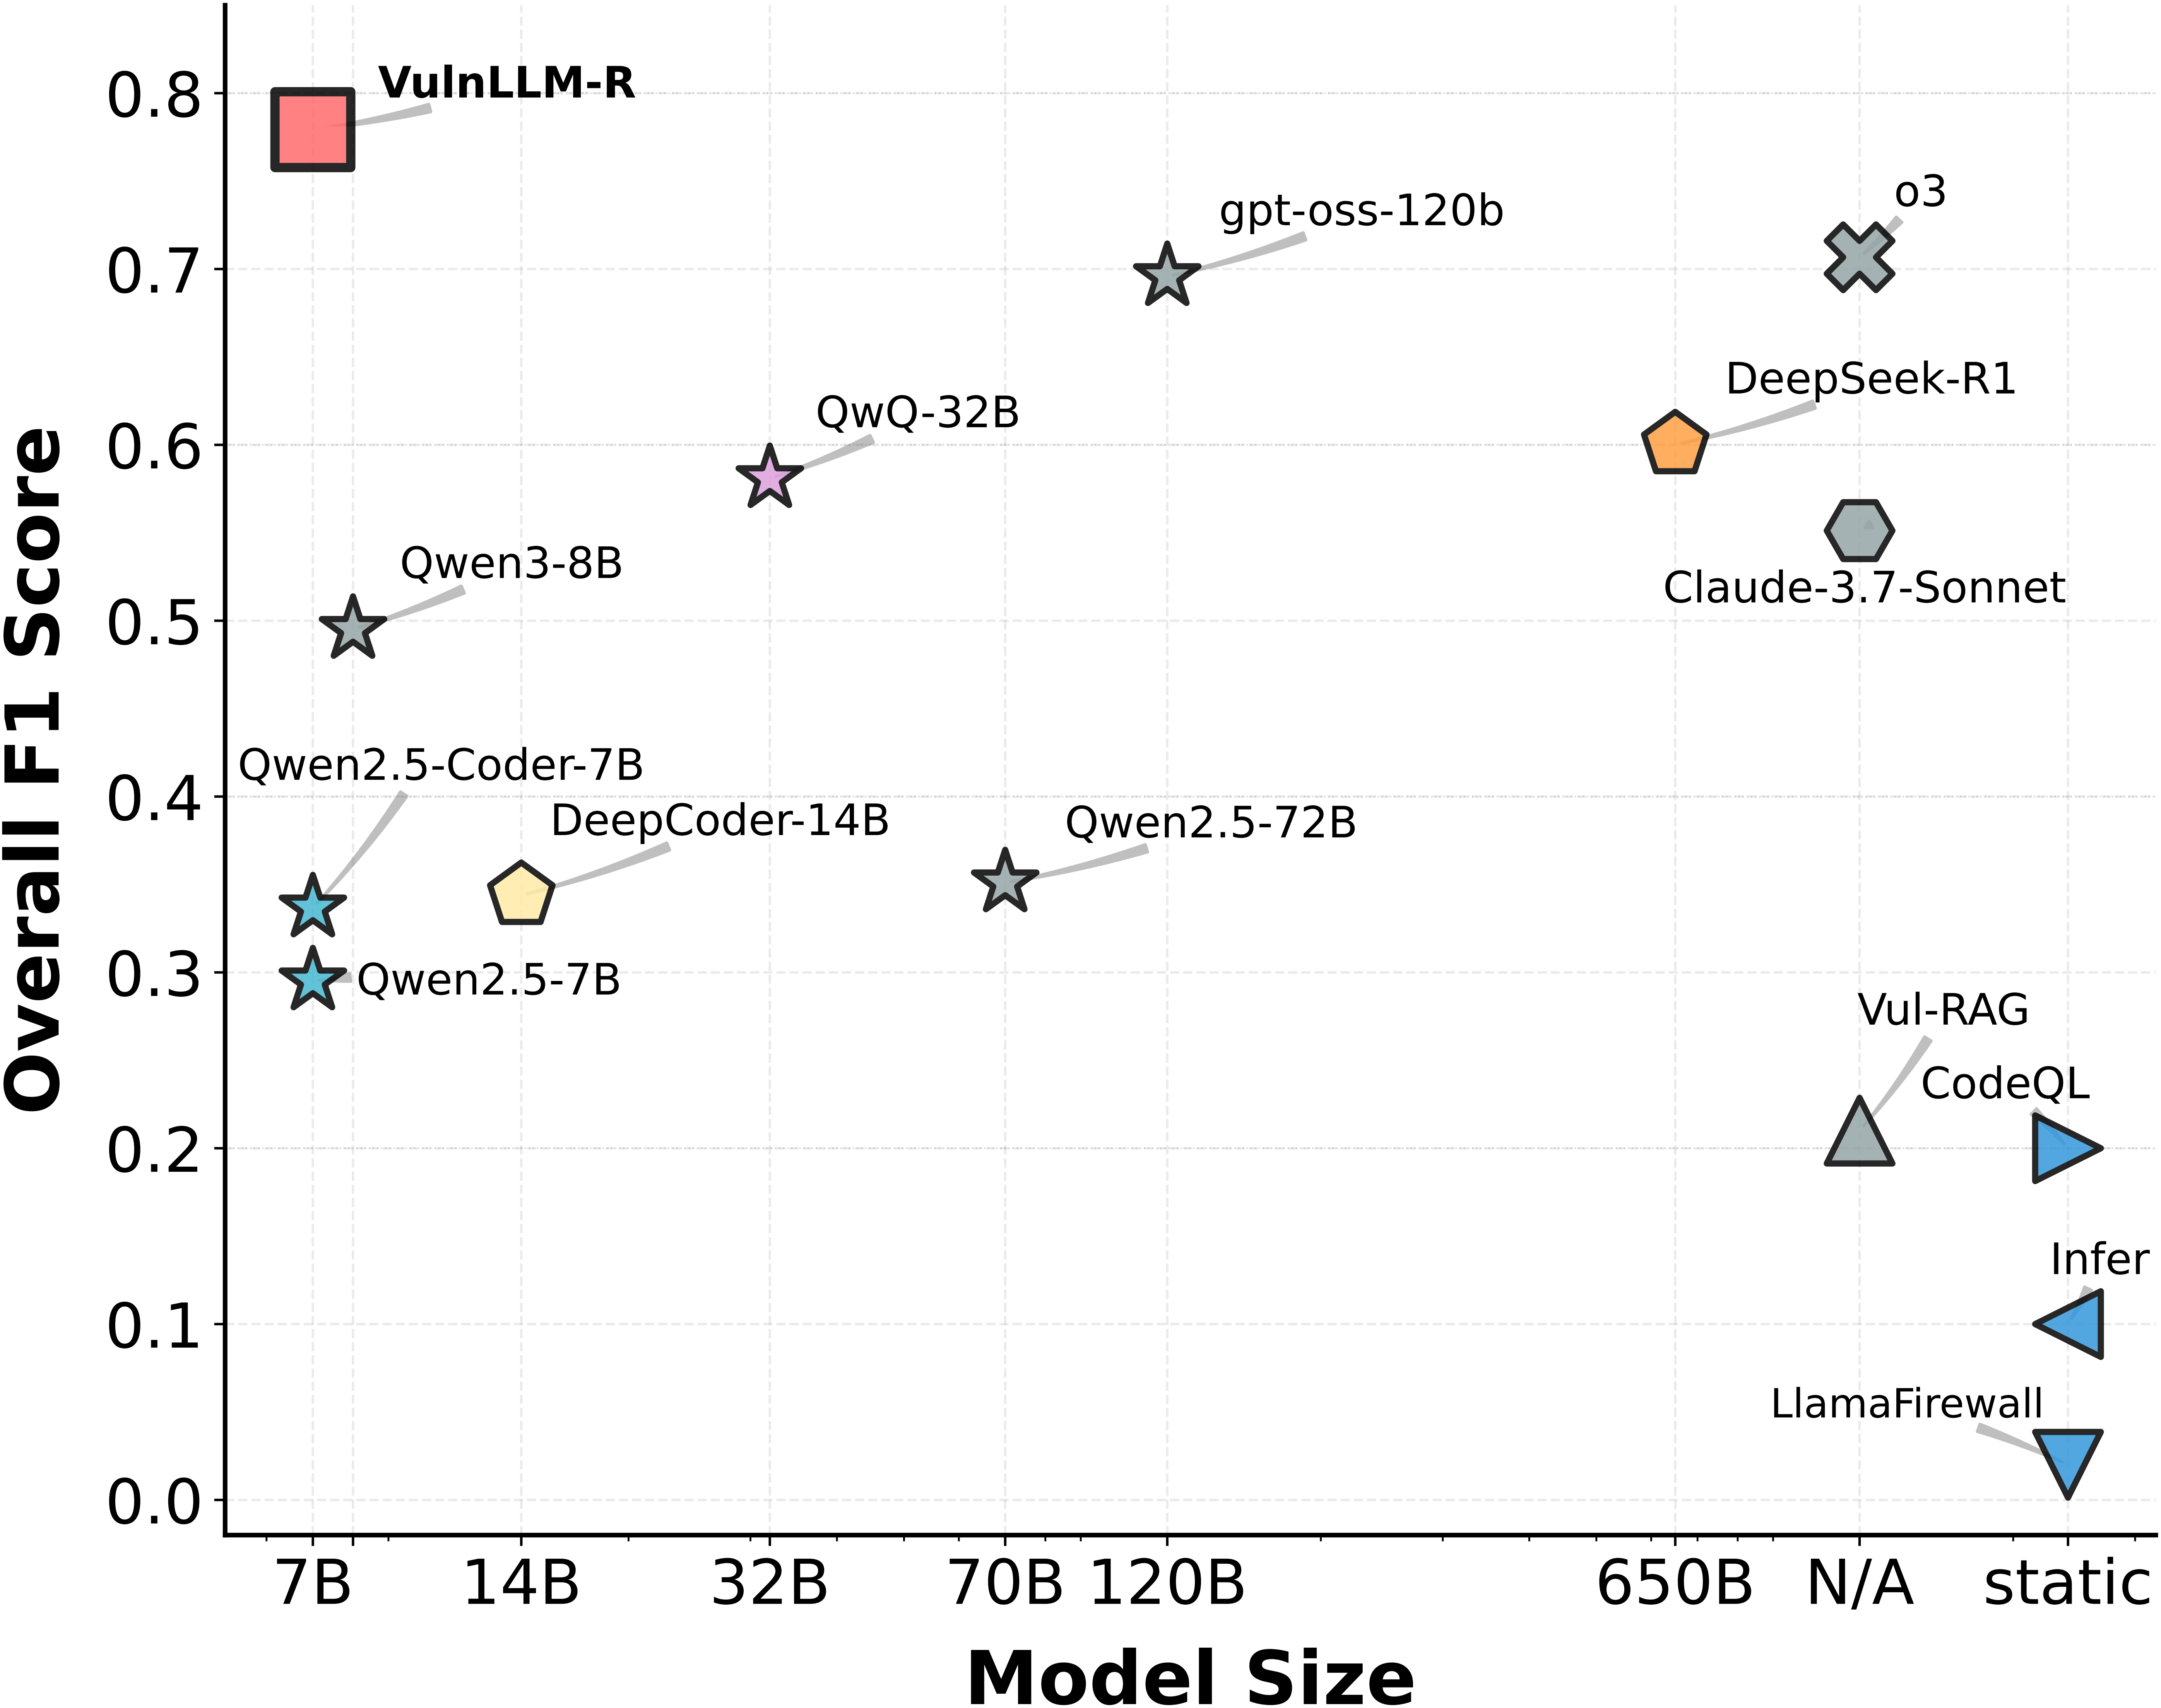
python plots/plot_language_comparison_models.py --results-dir results/test_data
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
نوفر أيضًا نسخة مختصرة الاستدلال من مجموعات البيانات المقطّرة:
دمج مجموعات البيانات الحالية لاكتشاف الثغرات على مستوى الدوال: PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4], وArvo [5]. ضمن هذه المجموعات، تحتوي PrimeVul على أكثر الدوال تعقيدًا. ننشئ مجموعتي تدريب: نظيفة (بدون PrimeVul) وصاخبة (مع PrimeVul)، حتى نتمكن من التدريب على مجموعات بسيطة نسبيًا والاختبار على مجموعة PrimeVul المعقدة. لاحظ أن تسميتنا لمجموعة التدريب التي تتضمن PrimeVul باسم "صاخبة" لا تعني أن المجموعة صاخبة (noisy). إنه اسم تعسفي نسبيًا استخدمناه في البداية.
vulscan/data_process/data_utils على مجموعة من البرامج النصية لمعالجة البيانات ودمجها.
raw_to_us.py: دمج البيانات الخام في مجموعتنا وإزالة البيانات المكررةcheck_cwe_correct.py: حساب الدقة لكل فئة CWEgenerate_arvo_raw_data.py: توليد بيانات خام منظمة من مجموعة بيانات arvoarvo_to_us.py: إعادة تنسيق البيانات الخام المنظمة من arvo إلى تنسيق مجموعتناsplit_good_bad_for_juliet.py: استخراج البيانات من مجموعة Juliet 1.3 الخام وتحويلها إلى التنسيق المطلوب، والتي تشكل جزءًا من مجموعة بياناتنا النظيفة c clean_datasetadd_sven_to_clean_dataset.py: استخراج البيانات من مجموعة بيانات Sven، لتشكيل جزء من مجموعة البيانات النظيفة C الخاصة بناsync_large_small.py: مزامنة التعديلات على noisy_dataset/large_train/c إلى noisy_dataset/small_train/cremove_testing_from_training.py: إضافة وسم human إلى كل بيانات، بمعنى أن النقطة تم التحقق منها بواسطة إنسان وتُستخدم كبيانات اختبار
-data_utils.py: إضافة حقل related_cwe إلى مجموعة البيانات.datasets/clean_dataset: بيانات التدريب بدون PrimeVul
datasets/clean_dataset/python يحتوي على بيانات من SVEN وSecCodePLTdatasets/clean_dataset/c يحتوي على بيانات من Juliet وSVENdatasets/noisy_dataset
datasets/noisy_dataset/small_train: يحتوي على بيانات التدريب من PrimeVul وSVEN مع CWEs محددة (نستخدم بيانات PrimeVul في هذه المجموعة كتدريب)datasets/noisy_dataset/large_train: يحتوي على بيانات التدريب من PrimeVul وSVEN وSecCodePLT مع المزيد من CWEs (يمكن استخدام هذه المجموعة لاحقًا لتدريب نماذج أكبر)datasets/noisy_dataset/test: مجموعة اختبار صغيرة من PrimeVul تم التحقق منها بواسطة إنسانdatasets/test
datasets/test/test_clean: بيانات الاختبار من SVEN وSecCodePLT وJuliet؛ مع CWEs خارج التوزيع (OOD) غير المدرجة في مجموعة التدريبdatasets/test/test_primevul_pair: بيانات اختبار PrimeVul الأصليةvulscan/data_process/data_utils/get_cwe_stat.py للحصول على الرسم البياني للمجموعة| Dataset | Language | Train/test | CWE | # Benign | # Vuln. | average length |
|---|---|---|---|---|---|---|
| Clean (seccodeplt) | Python | Train | 20 | 1281 | 1281 | 741 |
| Clean (juliet) | C/C++ | Train | 22 | 1716 | 1653 | 3689 |
| Hard (primevul filtered) | C/C++ | Train | 26 | 2717 | 2952 | 4689 |
| Long Context (Oss-fuzz) | C/C++ | Train | 3 | 475 | 604 | 12761 |
| Simple (seccodeplt) | Python | Test | 24 (6 ood) | 74 | 74 | 814 |
| Simple (juliet) | C/C++ | Test | 38 (14 ood) | 358 | 376 | 2575 |
| Hard (PrimeVul, SecLLMHolmes) | C/C++ | Test | 13 (5 ood) | 145 | 152 | 4545 |
| Long Context (Oss-fuzz) | C/C++ | Test | 3 (0 ood) | 0 | 320 | 18929 |
| primevul test (noisy) | C/C++ | Test | 56 (34 ood) | 421 | 422 | 5341 |
بعد إنشاء مجموعات البيانات، سنقوم بتوليد بيانات الاستدلال لمجموعة التدريب الخاصة بنا.
سوف نستعلم من نموذجي الاستدلال DeepSeek-r1 وQwQ لتوليد بيانات الاستدلال وتصفية تلك التي تحتوي على سلاسل استدلال طويلة جدًا.
الكود الخاص بتوليد بيانات الاستدلال موجود في vulscan/data_process/generate_reasoning وسيتم حفظ بيانات الاستدلال
في datasets/reasoning_data.
cd vulscan/data_process/generate_reasoning
