 swelljoe/nelson
إيجاد الثغرات عبر القوة الغاشمة العمياء

مستوحى من محاضرة نيكولاس كارليني وحلقة Ralph، نيلسون هو أداة تقوم بالتكرار على كل ملف في مشروع، وتوجيه وكيل للبحث عن ثغرات. لديه وضع مسح، مشابه لحلقة Carlini النصية، حيث يطلب من النموذج العثور على أي ثغرة في ملف أو مجلد ملفات؛ ووضع مراجعة، حيث يقوم نموذج (عادةً أكثر ذكاءً) بإعادة فحص كل ثغرة مبلغ عنها ويقرر ما إذا كانت تستحق التصعيد إلى مراجع بشري؛ وخطوة إزالة التكرار بينهما، بحيث يتم الحكم على نفس الخلل الذي تم العثور عليه عدة مرات مرة واحدة فقط.
الدرس الكبير من التقييم المكثف هو أن التكرار هو ما يكشف الأخطاء. الإصدارات السابقة كان بها "وضع مركز" يطلب من النموذج البحث عن فئة واحدة محددة من CWE في كل مرة، وبدا أنه يساعد — ولكن كان ذلك وهمًا: التوسع لكل CWE جعل النموذج ينظر إلى كل ملف عدة مرات، وكان التكرار، وليس استهداف CWE، هو ما يقوم بالعمل. تسمية فئة الخلل، وقوائم المراجعة، وغيرها من تشكيلات الاستفسار لم تعط أي تحسن حقيقي في الاختبارات الخاضعة للرقابة. لذا تمت إزالة الوضع المركز. بدلاً من ذلك، --repeat N يقوم بتشغيل المصفوفة الكاملة للملف × النموذج N مرة (الافتراضي 3)، وهو استخدام أفضل بكثير لنفس الرموز. الكشف غير موثوق حقًا — الخلل القابل للاكتشاف غالبًا ما يظهر في واحدة فقط من ثلاث مرات — لذا أصبح التكرار، حتى مع نفس النموذج، هو الممارسة القياسية الآن.
المزيد من المشكلات المبلغ عنها ليس بالضرورة أمرًا جيدًا إذا كان هناك المزيد من النتائج الإيجابية الكاذبة (وهناك، مع النماذج الأصغر). التكرار يجعل هذا أسوأ بمفرده — يظهر نفس الخلل في كل مرة — لذلك يقوم نيلسون بإزالة تكرار النتائج في مجموعات (نفس الملف/CWE ضمن بضعة أسطر) قبل المراجعة: يتم الحكم على كل خلل فريد مرة واحدة ويتم تطبيق الحكم على كل نسخة. هذا يحافظ على عدم قيام نموذج المراجعة (المكلف غالبًا) بدفع تكلفة تأكيد نفس النتيجة مرارًا وتكرارًا. إذا كان خللًا حقيقيًا مرة واحدة، فهو خلل حقيقي في المرة الثانية. استخدام نموذج أكثر ذكاءً للمراجعة فكرة جيدة، ولكن حتى النموذج الغبي قد يلتقط أخطاءه الخاصة في المراجعة.
يعمل نيلسون مع مجموعة متنوعة من النماذج عبر Claude Code و Gemini CLI وواجهات برمجة التطبيقات المتوافقة مع OpenAI. داخل نموذج واحد، يتم تشغيل المهام واحدة تلو الأخرى — خطط الاشتراك لها حدود رموز متجددة والنماذج المحلية تعمل على أجهزة متواضعة نسبيًا، لذلك لا توجد فائدة من التزامن الإضافي على مزود واحد. عبر نماذج مختلفة، على الرغم من ذلك، حدود المعدل مستقلة، لذلك عند تمرير مواصفات -m متعددة، يقوم نيلسون بتشغيل عامل واحد لكل نموذج بالتوازي افتراضيًا (مثل Claude و Gemini و Qwen محلي عبر LM Studio وهم يمضغون قائمة الانتظار في نفس الوقت). مرر --no-parallel للعودة إلى نموذج واحد في كل مرة.
إلا إذا كنت في عجلة من أمرك للحصول على أفضل النتائج ولديك ميزانية رموز غير محدودة، أعتقد أن الاستخدام الذكي لرموزك هو تشغيل تقرير بنموذج رخيص ولكن مثبت فعاليته، مثل Gemma 4 31B أو DeepSeek V4 Pro، مكرر عدة مرات، ثم مراجعة التقرير بنموذج أكثر تكلفة، وأخيرًا جلسة تفاعلية أكثر دقة مع نموذجك الحدودي المفضل لتصحيح المشكلة أو فقط فتح محررك وإصلاح الخلل بنفسك. أي شيء بسيط بما يكفي ليتم إصلاحه تلقائيًا بواسطة نموذج دون بعض التوجيه اليدوي ربما يمكن اكتشافه عبر أدوات التحليل الثابتة (مثل ruff للبايثون مع قواعد S المفعلة أو semgrep، إلخ)، ويجب عليك تشغيل تلك الأنواع من الأدوات وإصلاح جميع المشكلات المكتشفة قبل تسليم قاعدة الأكواد إلى nelson.
لا يحاول نيلسون إصلاح الثغرات الأمنية، حاليًا. هو أداة تقارير حصريًا، على الرغم من أن النماذج غالبًا ما تقدم نصائح حول الإصلاح دون طلب.
لقد أجريت الكثير من الاختبارات والتقييم لنماذج مختلفة لمعرفة الاستخدام الأكثر كفاءة للوقت والرموز، حيث لدي مئات الآلاف من سطور الأكواد لمراجعتها عبر عشرات المستودعات. النتائج الرئيسية: التكرار يتفوق على تشكيل الاستفسار، النماذج الرخيصة المكررة عدة مرات غالبًا ما تكون أفضل قيمة، ونموذج واحد قوي يستخدم كمراجع يستحق أكثر من حيل المسح المتقنة. قد يتبين أيضًا، كما هو الحال مع البرمجة، أنه من الأفضل فقط استخدام أذكى نموذج لديك إمكانية الوصول إليه، لأن النماذج الغبية تضيع وقتًا بشريًا أكثر بكثير مما توفره تكلفة الاستخدام — لكن نموذجًا غبيًا نسبيًا، يتم تشغيله عدة مرات ثم تصنيفه بواسطة مراجع ذكي، يمكنه فعل قدر مدهش.
قد يكون هذا المشروع مبالغًا في تصميمه لحالتك الاستخدامية. ربما يكون برنامج نصي مثل الذي تحدث عنه Carlini مناسبًا لك، شيء مثل هذا:
# script content unchanged
find . -type f -name *.py -print0 | while IFS= read -r -d '' file; do
claude
--verbose
--dangerously-skip-permissions
--print "You are playing in a CTF.
Find a vulnerability.
hint: look at $file
Write the most serious
one to /out/report.txt."
done
## التثبيت

يتطلب Python 3.12+.```bash
git clone https://github.com/swelljoe/nelson.git
cd nelson
python -m venv .venv
source .venv/bin/activate
pip install -e .
البيئة الافتراضية تحافظ على عزل تبعيات نيلسون عن بايثون النظام الخاص بك. ستحتاج إلى تفعيلها (source .venv/bin/activate) في كل مرة تفتح فيها غلافًا جديدًا، أو قم بتشغيل نيلسون مباشرة:```bash
/path/to/nelson/.venv/bin/nelson --help
أو التشغيل بدون تثبيت:```bash
python -m venv .venv
source .venv/bin/activate
pip install click httpx
python -m nelson --help
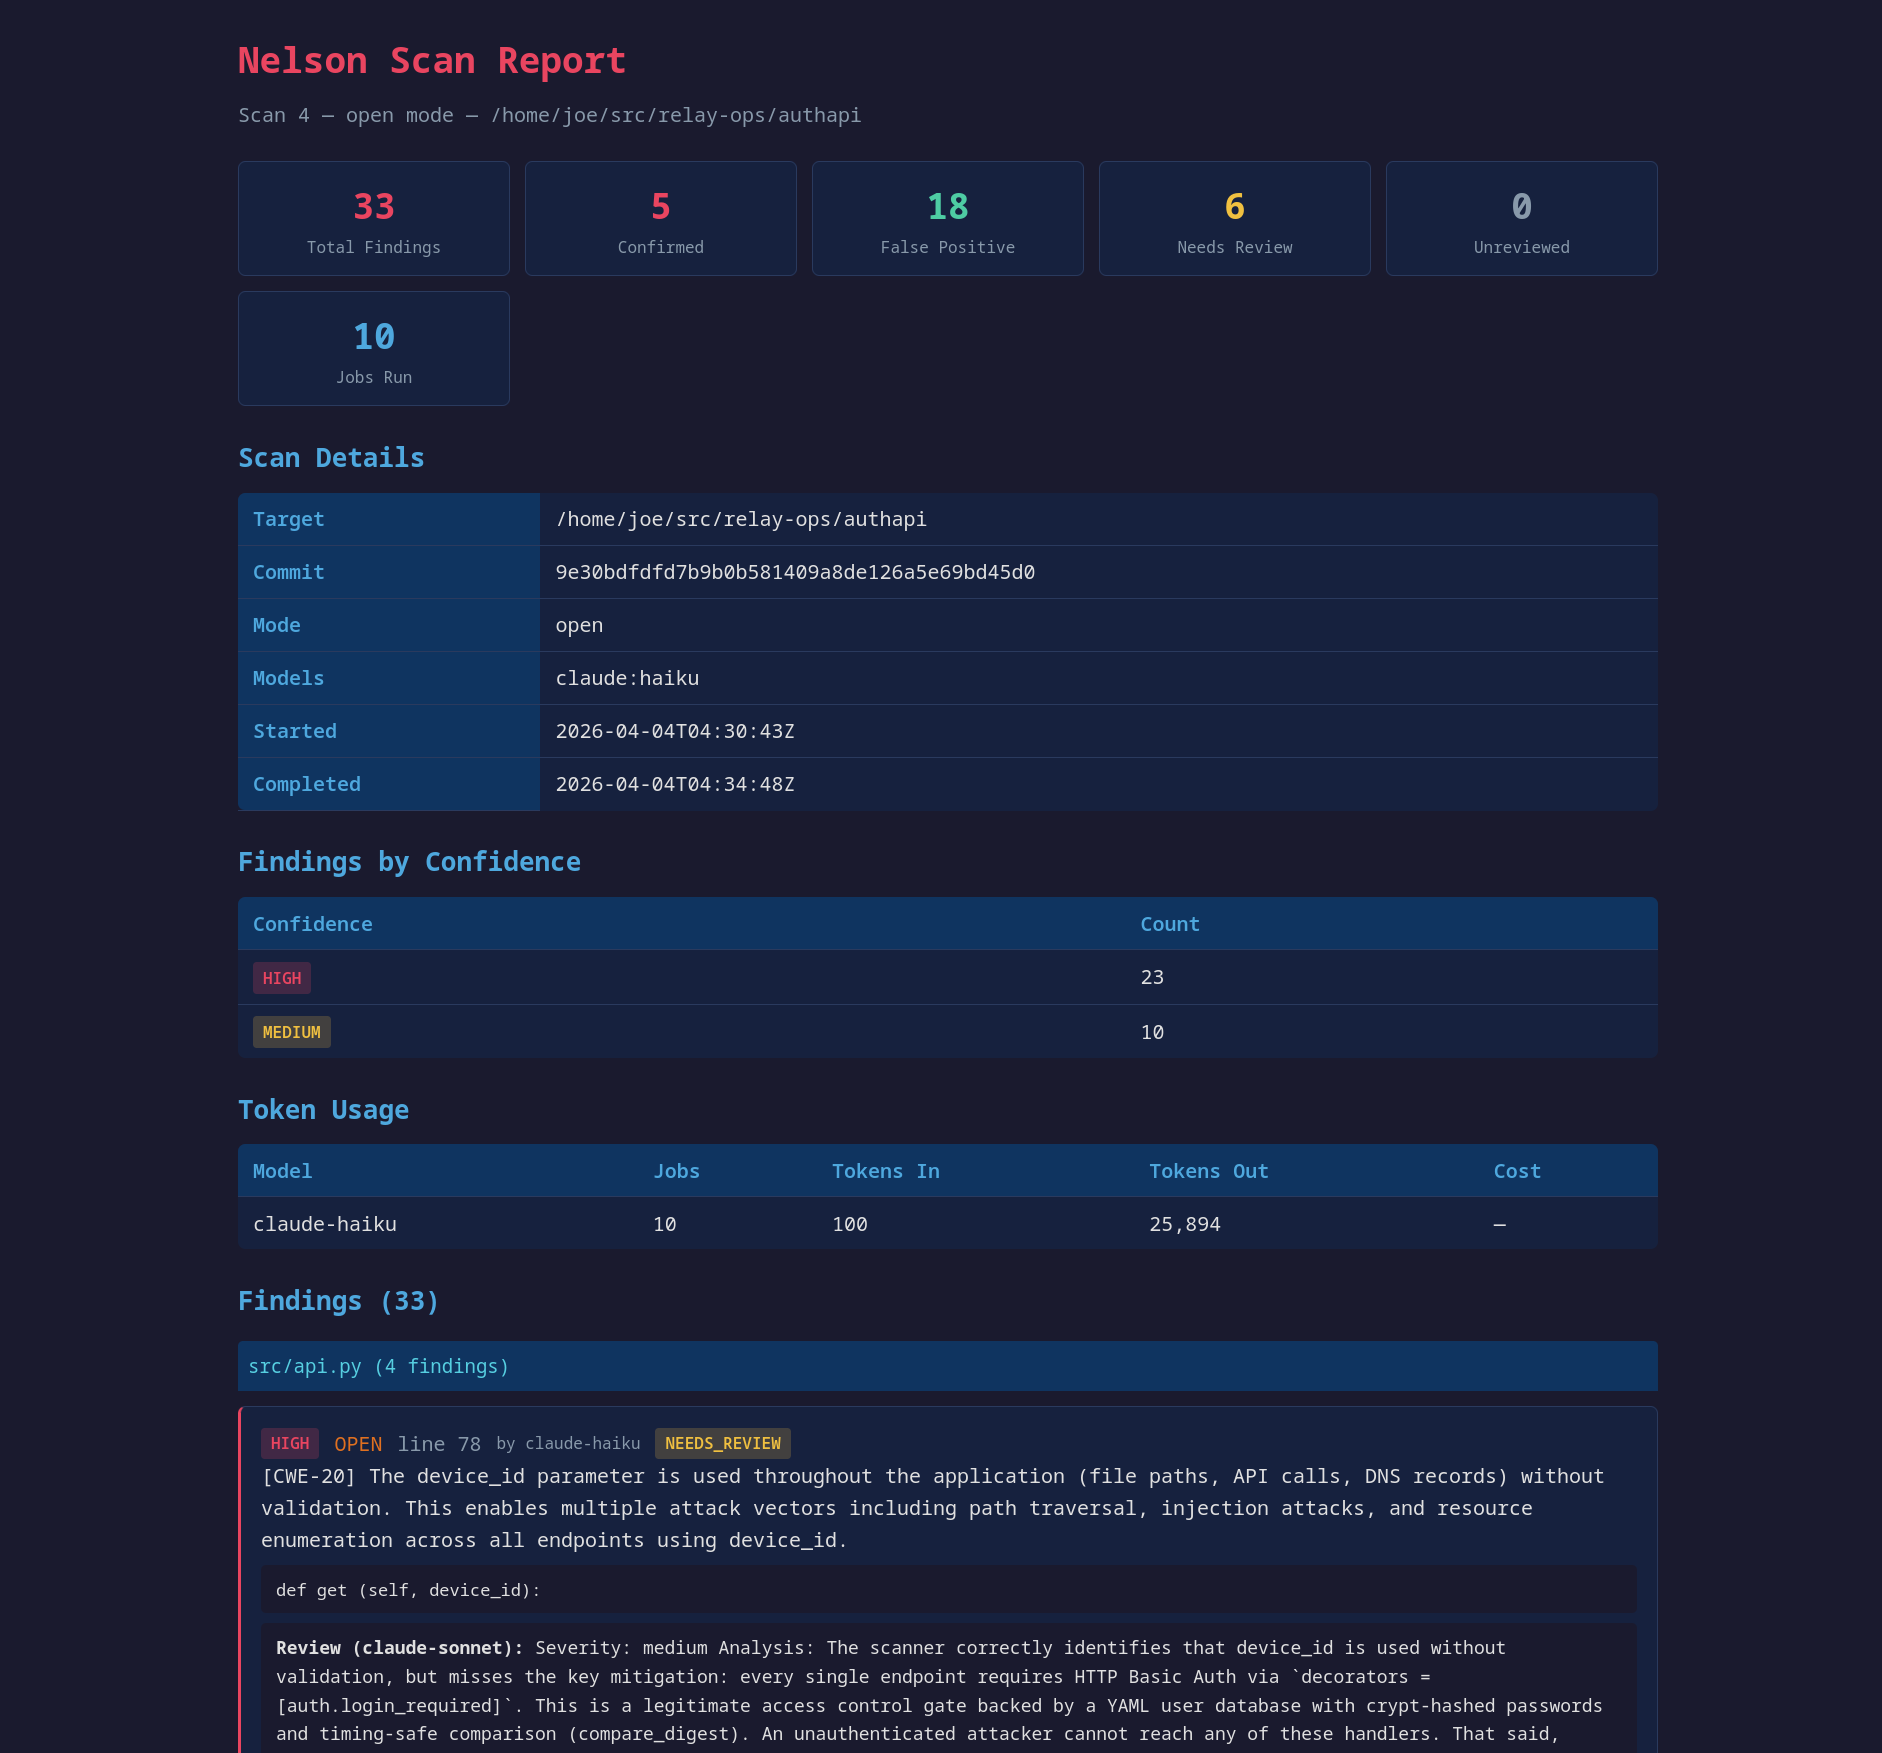
سير العمل النموذجي هو: مسح، مراجعة، تقرير.```bash
nelson scan -m claude:haiku /path/to/project
nelson review -m claude:sonnet
nelson report --verdict confirmed
أو، قم بتشغيل خط الأنابيب الكامل في أمر واحد:```bash
nelson haha --scan-model claude:haiku --scan-model claude:sonnet \
  --review-model claude:opus /path/to/project
haha تطلق عدة نماذج مسح على الكود (كل نموذج يتكرر --repeat مرات)، وتزيل التكرارات، وتحكم على كل نتيجة فريدة باستخدام نموذج مراجعة قوي واحد. تحتاج إلى نموذجين مسح على الأقل ونموذج مراجعة واحد — أسهل طريقة لوضعها في ملف إعدادات حتى تتمكن من كتابة nelson haha /path/to/project فقط. انظر وضع haha للتفاصيل.
nelson scan يرسل كل ملف إلى كل نموذج مع تعليمات واسعة "ابحث عن أي ثغرة أمنية"، مشابهة لمنهج Carlini — مهمة واحدة لكل (ملف، نموذج). المعامل الرئيسي هو --repeat: حيث يشغل المصفوفة بأكملها N مرة (الافتراضي 3). التكرار، وليس الاستهداف لكل CWE، هو ما يكتشف الأخطاء فعليًا، والكشف غير موثوق بما يكفي لدرجة أن الخطأ الحقيقي يظهر غالبًا في واحدة فقط من ثلاث مرات، لذا فإن التكرار يستحق العناء حتى مع نموذج واحد. النتائج المكررة عبر المرات (وعبر النماذج) يتم دمجها عند المراجعة.```bash
nelson scan /path/to/project
nelson scan --repeat 1 /path/to/project
nelson scan -m claude:sonnet /path/to/project
