 hpthreatresearch/subcrawl
إطار معياري لاكتشاف وتحليل الدلائل المفتوحة على الويب. يزحف على عناوين URL، يستخرج المحتوى، يطبق مسح YARA/ClamAV، ويخرج النتائج إلى MISP أو SQLite أو وحدة التحكم لاستخبارات التهديدات.

SubCrawl هو إطار عمل تم تطويره بواسطة Patrick Schläpfer وJosh Stroschein وAlex Holland من فريق Threat Research التابع لشركة HP Inc. تم تصميم SubCrawl للعثور على الدلائل المفتوحة وفحصها وتحليلها. الإطار معياري، ويتكون من أربعة مكونات: وحدات الإدخال، وحدات المعالجة، وحدات الإخراج، ومحرك الزحف الأساسي. عناوين URL هي قيم الإدخال الأساسية، والتي يقوم الإطار بتحليلها وإضافتها إلى نظام انتظار قبل الزحف إليها. يُعتبر تحليل عناوين URL خطوة أولى مهمة، حيث يأخذ عنوان URL المُقدم ويُنشئ عناوين URL إضافية ليتم الزحف إليها عن طريق إزلة الدلائل الفرعية، واحدة تلو الأخرى حتى لا يتبقى أي منها. تضمن هذه العملية محاولة فحص أكثر اكتمالاً لخادم الويب ويمكن أن تؤدي إلى اكتشاف محتوى إضافي. من الجدير بالذكر أن SubCrawl لا يستخدم طريقة القوة الغاشمة لاكتشاف عناوين URL. كل المحتوى الممسوح ضوئيًا يأتي من عناوين URL المُدخلة، وعملية تحليل عنوان URL، والاكتشاف أثناء الزحف. عند اكتشاف دليل مفتوح، يستخرج محرك الزحف الروابط من الدليل للتقييم. يحدد محرك الزحف ما إذا كان الرابط دليلاً آخر أم ملفًا. تتم إضافة الدلائل إلى قائمة انتظار الزحف، بينما تخضع الملفات لتحليل إضافي بواسطة وحدات المعالجة. يتم إنشاء النتائج وتخزينها لكل عنوان URL تم فحصه، مثل SHA256 والتجزئة الضبابية للمحتوى، وما إذا تم العثور على دليل مفتوح، أو التطابقات مع قواعد YARA. أخيرًا، تتم معالجة بيانات النتيجة وفقًا لوحدة إخراج واحدة أو أكثر، والتي يوجد منها حاليًا ثلاثة. يوفر الأول التكامل مع MISP، والثاني يطبع البيانات ببساطة إلى وحدة التحكم، والثالث يخزن البيانات في قاعدة بيانات SQLite. نظرًا لأن الإطار معياري، فليس من السهل فقط تكوين وحدات الإدخال والمعالجة والإخراج المرغوبة، بل من السهل أيضًا تطوير وحدات جديدة.
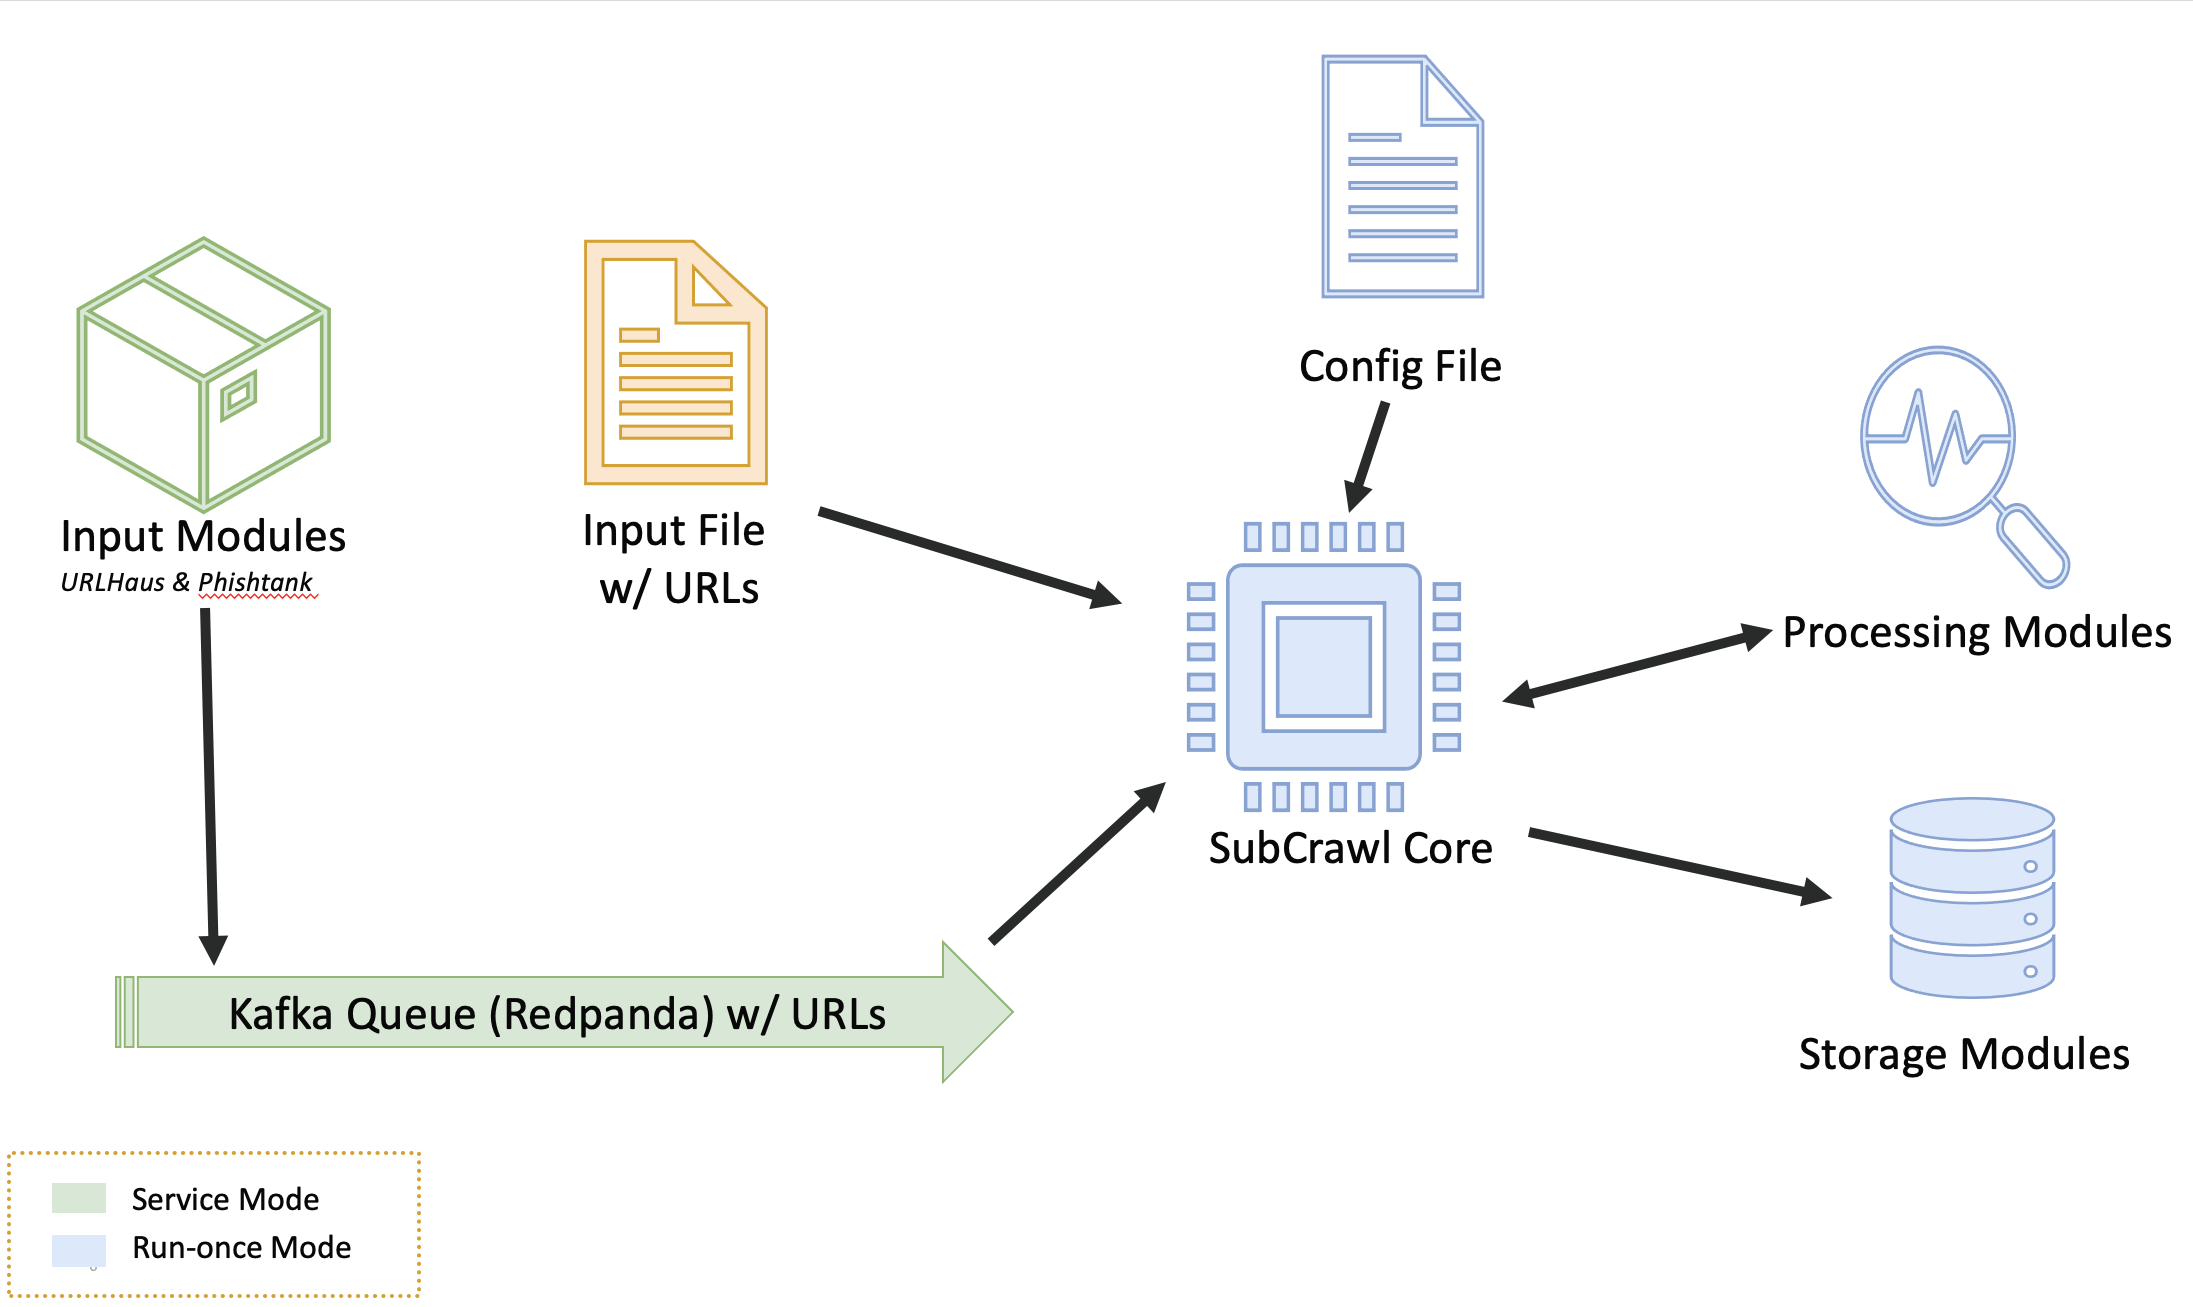
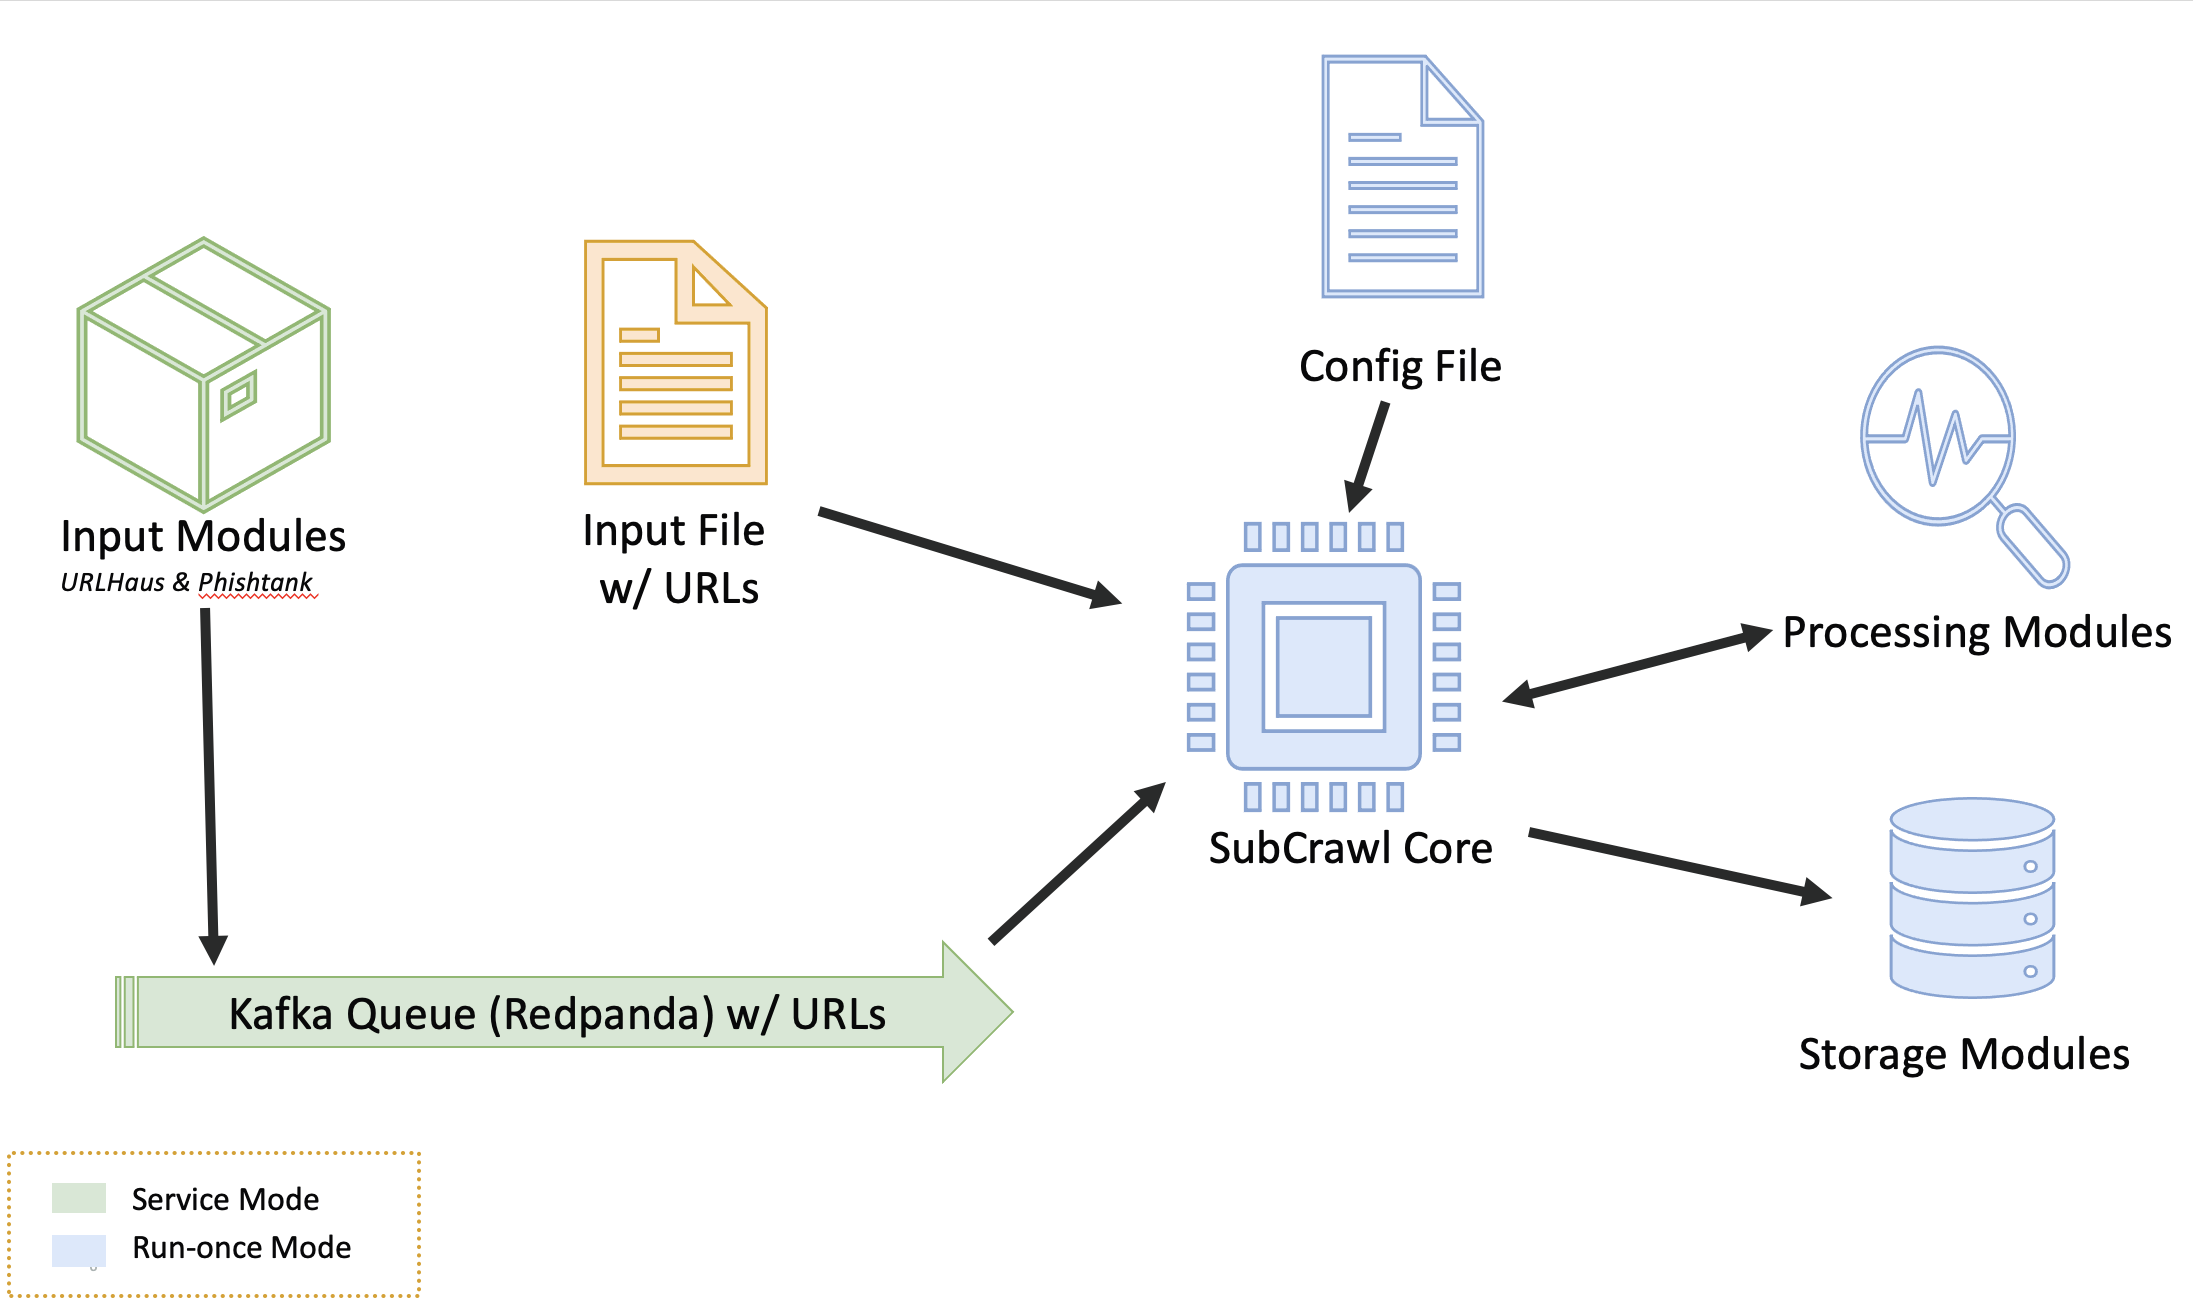 شكل 1 - بنية SubCrawl
يدعم SubCrawl وضعين مختلفين للتشغيل. أولاً، يمكن بدء تشغيل SubCrawl في وضع التشغيل لمرة واحدة. في هذا الوضع، يقوم المستخدم بتوفير عناوين URL المراد فحصها في ملف حيث يتم فصل كل قيمة إدخال بفاصل أسطر. وضع التشغيل الثاني هو وضع الخدمة. في هذا الوضع، يعمل SubCrawl في الخلفية ويعتمد على وحدات الإدخال لتوفير عناوين URL المراد فحصها. يوضح الشكل 1 نظرة عامة على بنية SubCrawl. المكونات المستخدمة في كلا وضعي التشغيل زرقاء، ومكونات وضع التشغيل لمرة واحدة صفراء، ومكونات وضع الخدمة خضراء.
بناءً على وضع التشغيل المختار، يجب استيفاء شروط مسبقة أخرى.
SubCrawl مكتوب بلغة Python3. بالإضافة إلى ذلك، هناك عدة حزم مطلوبة قبل تشغيل SubCrawl. يمكن استخدام الأمر التالي لتثبيت جميع الحزم المطلوبة قبل تشغيل SubCrawl. من دليل crawler، قم بتشغيل الأمر التالي:
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
إذا تم بدء تشغيل SubCrawl في وضع الخدمة، فيمكن القيام بذلك باستخدام Docker. لهذا السبب، يلزم تثبيت Docker و Docker Compose. يمكن العثور على تعليمات تثبيت جيدة مباشرة على موقع Docker.com.
يحتوي SubCrawl على مساعدة مدمجة من خلال الوسيط -h/--help أو ببساطة عن طريق تنفيذ البرنامج النصي بدون أي وسائط.
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ جني الويب المفتوح ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
هذا الوضع مناسب إذا كنت تريد فحص عدد يمكن التحكم فيه من النطاقات بسرعة. لهذا الغرض، يجب حفظ عناوين URL المراد فحصها في ملف، والذي سيكون بمثابة إدخال للزاحف. فيما يلي مثال على التنفيذ في وضع التشغيل لمرة واحدة، لاحظ استخدام الوسيط -f مع مسار إلى ملف.
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
مع وضع الخدمة، يمكن فحص عدد أكبر من النطاقات وحفظ النتائج. بناءً على وحدة التخزين المحددة، يمكن بعد ذلك تحليل البيانات وتقييمها بمزيد من التفصيل. لجعل تشغيل وضع الخدمة سهلاً قدر الإمكان للمستخدم، قمنا ببناء جميع الوظائف في صورة Docker. في وضع الخدمة، يتم الحصول على النطاقات المراد فحصها عبر وحدات الإدخال. بشكل افتراضي، يتم تنزيل عناوين URL جديدة للبرامج الضارة والتصيد الاحتيالي من URLhaus وPhishTank ووضعها في قائمة الانتظار للفحص. يمكن إدخال وحدات المعالجة والتخزين المطلوبة مباشرة في config.yml. بشكل افتراضي، يتم تنشيط وحدات المعالجة التالية، باستخدام تخزين SQLite:
بالإضافة إلى وحدة تخزين SQLite، تم تطوير واجهة ويب بسيطة تتيح عرض وإدارة النطاقات وعناوين URL الممسوحة ضوئيًا.
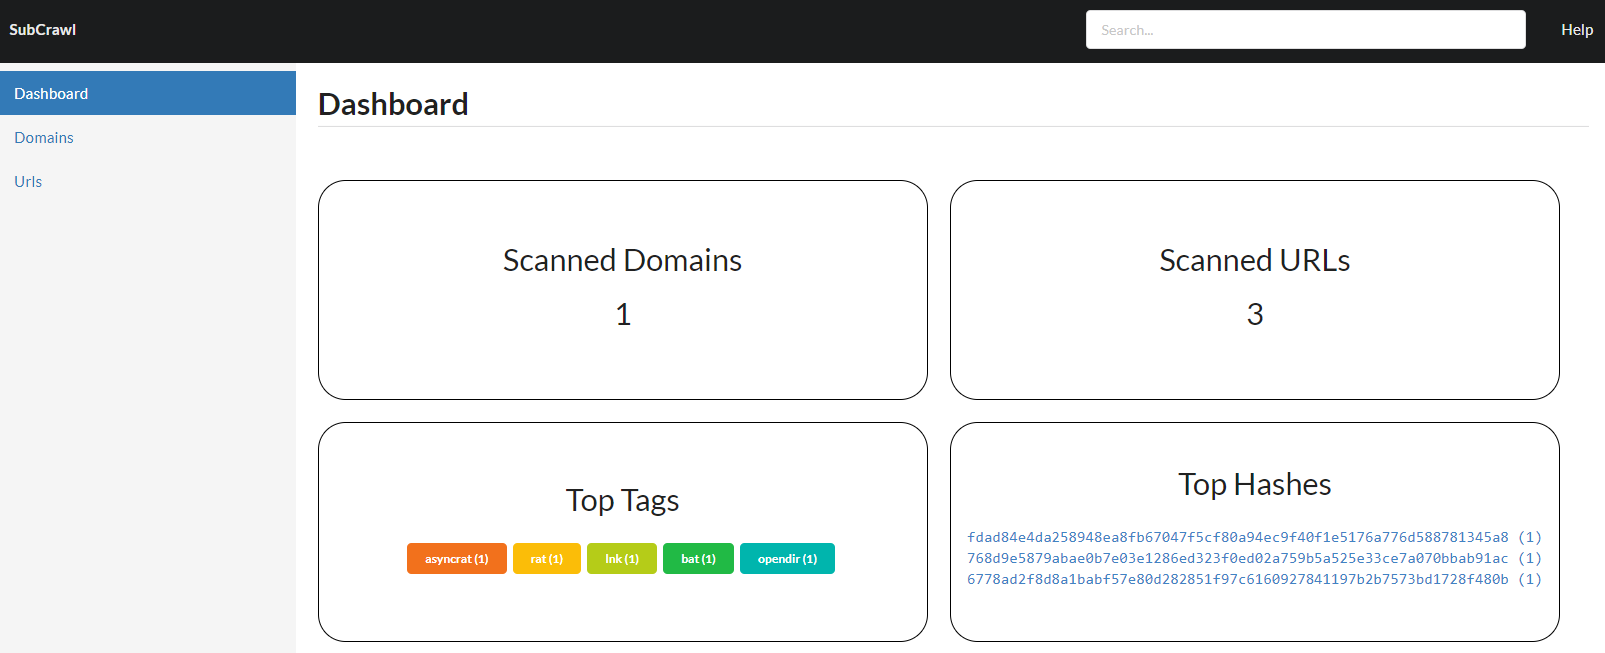
ومع ذلك، إذا لم تكن هذه الواجهة كافية للتقييم اللاحق للبيانات، فيمكن تنشيط وحدة تخزين MISP بشكل بديل أو إضافي. يجب إجراء الإعدادات المقابلة في config.yml ضمن قسم MISP.
الأمران التاليان كافيان لاستنساخ مستودع GIT، وإنشاء حاوية Docker، وبدء تشغيلها مباشرة. بعد ذلك يمكن الوصول إلى واجهة الويب على العنوان https://localhost:8000/. يرجى ملاحظة أنه بمجرد بدء الحاويات، ستبدأ وحدات الإدخال في إضافة عناوين URL إلى قائمة انتظار المعالجة وسيبدأ المحرك في الزحف إلى المضيفين.
git clone https://github.com/hpthreatresearch/subcrawl.git

docker-compose up --build
تُستخدم وحدات الإدخال فقط في وضع الخدمة. إذا تم بدء تشغيل SubCrawl باستخدام وضع التشغيل لمرة واحدة، فيجب توفير ملف يحتوي على عناوين URL المراد فحصها. تم تنفيذ وحدتي الإدخال التاليتين.
URLhaus هو خدمة ويب بارزة تتتبع عناوين URL الضارة. توفر خدمة الويب أيضًا صادرات تحتوي على عناوين URL جديدة تم اكتشافها. تعمل عناوين URL الخاصة بالبرامج الضارة هذه كمدخل مثالي للزاحف الخاص بنا لأننا نريد بشكل أساسي تحليل النطاقات الضارة. يتم استرداد عناوين URL المقدمة مؤخرًا ولا يتم تحسين نتائج البحث من خلال طلب API (أي من خلال العلامات أو المعلمات الأخرى المتاحة). يمكن تعديل طلب HTTP الذي تم إجراؤه في وحدة الإدخال هذه إلى URLHaus API لتحسين النتائج التي تم الحصول عليها.
PhishTank هو موقع ويب يجمع عناوين URL للتصيد الاحتيالي. لدى المستخدمين إمكانية تقديم صفحات تصيد جديدة تم العثور عليها. يمكن إنشاء تصدير يحتوي على عناوين URL نشطة للتصيد الاحتيالي وتنزيله من خدمة الويب هذه عبر API. لذا فهذه أيضًا مجموعة مثالية للزاحف الخاص بنا.
يأتي SubCrawl مع العديد من وحدات المعالجة. تتبع وحدات المعالجة جميعًا سلوكًا مشابهًا في كيفية تقديم النتائج مرة أخرى إلى المحرك الأساسي. إذا تم العثور على تطابقات، يتم إرجاع النتائج إلى المحرك الأساسي ثم توفيرها لاحقًا لوحدات التخزين. فيما يلي قائمة بوحدات المعالجة.
