
 google/oss-fuzz-gen
LLM مدعوم بالتشويش عبر OSS-Fuzz.

يولّد إطار العمل هذا أهداف اختبار عشوائي لمشاريع C/C++/Java/Python الواقعية باستخدام
نماذج لغوية كبيرة (LLM) متنوعة ويقيس أداءها عبر
منصة OSS-Fuzz.
تتوفر مزيد من التفاصيل في الاختبار العشوائي المدعوم بالذكاء الاصطناعي: كسر حاجز البحث عن الأخطاء:

النماذج المدعومة حاليًا هي:
يتم تقييم أهداف الاختبار العشوائي المولّدة باستخدام أربعة مقاييس مقابل أحدث البيانات من بيئة الإنتاج:
OSS-Fuzz.فيما يلي نتيجة تجربة نموذجية من 31 يناير 2024. تضمنت التجربة أكثر من 1300 معيار قياس من 297 مشروعًا مفتوح المصدر.
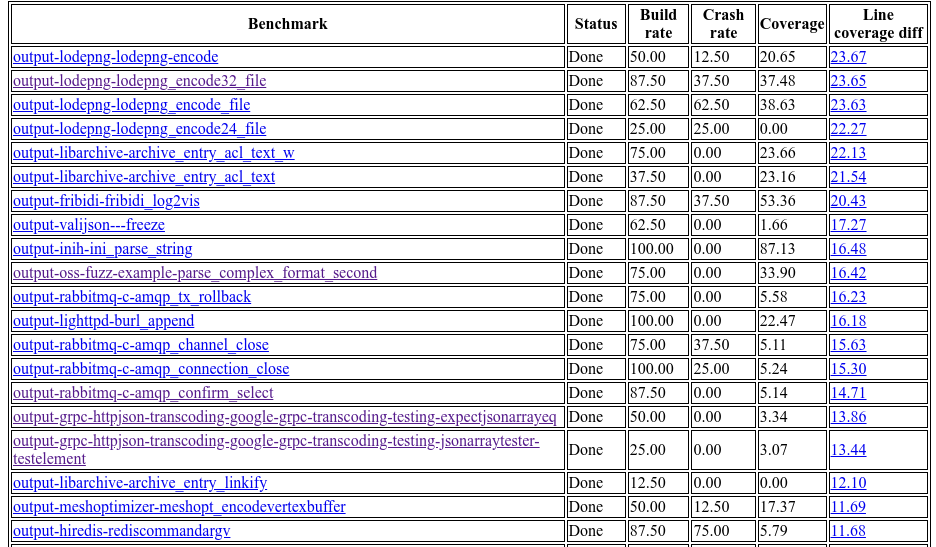
بشكل عام، ينجح إطار العمل هذا في الاستفادة من النماذج اللغوية الكبيرة لتوليد أهداف اختبار عشوائي صالحة (تُنتج زيادة غير صفرية في التغطية) لـ 160 مشروعًا من مشاريع C/C++. الحد الأقصى لزيادة تغطية الأسطر هو 29% مقارنة بالأهداف الحالية المكتوبة بشريًا.
لاحظ أن هذه التقارير ليست عامة لأنها قد تحتوي على ثغرات أمنية غير معلنة.
راجع دليل الاستخدام المفصل لدينا للحصول على تعليمات حول كيفية تشغيل إطار العمل هذا وتوليد التقارير بناءً على النتائج.
يمكنك أيضًا تنفيذ أو تقييم وكلاء فرديين دون تشغيل تجارب كاملة، باستخدام إطار تنفيذ الوكلاء المدمج. راجع وثائق إطار العمل للحصول على تعليمات مفصلة حول كيفية تشغيل وكلاء فرديين أو تسلسل من الوكلاء.
هل أنت مهتم بالبحث أو بالتعاون مع مجتمع المصادر المفتوحة؟ لا تتردد في إنشاء مشكلة أو مراسلتنا عبر البريد الإلكتروني: [email protected].







