

 amd2g2zz/kunglao-agent
خبير الهندسة العكسية الوكيل: يخطط مسار تحليله الخاص، ويستنبط كل حقيقة من الأدلة الخام، ويتقارب تحت بوابات التحقق الميكانيكية — البرامج الثابتة، والبروتوكولات، والويب/JS، والتحكم في المخاطر، والملفات الثنائية.
وكيل هندسة عكسية مستقل يعمل لساعات دون إشراف، ويتحقق من كل استنتاج بشكل مستقل، ولا يتوقف إلا عندما ينجو كل جواب من حكم أوراكل ميكانيكي.


🧠 يخطط مساره بنفسه · 🔬 كل ادعاء يُفحص آليًا · ⚖️ تحقق أعمى على كل شيء · 📈 الحلقة تقيس نفسها
🚀 بدء سريع · ✨ التقنية الأساسية · 🧠 kunglao × Claude Code · 🎛️ كيف يعمل التعلم المعزز · 🖥️ عرض توضيحي · 📖 دراسات حالة · 🧪 التقييم · 🏗️ البنية · 🗓️ خارطة الطريق
English · 简体中文
[!WARNING] v0.1.6 هي آخر سلسلة إصدارات أصلية لـ Claude Code. المعلم التالي (v0.2) ينقل بيئة التشغيل بالكامل إلى قاعدة PI Agent — نفس الحلقة، نفس السجلات، ركيزة محرك جديدة. راجع خارطة الطريق.
توجّه kunglao-agent نحو هدف وتحدد الأسئلة؛ فيخطط المسار، ويرسل عمالًا متخصصين، ويتحقق من كل استنتاج بشكل مستقل، ولا يتوقف إلا عندما يُحسم كل جواب عبر فحص ميكانيكي بدلًا من كلام نموذج.
طيف الأهداف كامل — ملفات تنفيذية أصلية لنظامي Windows/Linux، وملفات APK لأندرويد (بما في ذلك طبقات .so الأصلية)، والويب/JS، واستعادة البروتوكولات، والبرمجيات الثابتة — ثابت أولًا بحكم التصميم، مع تشغيل أي قناة تنفيذ متاحة في بيئتك بالفعل (VMware، ssh، docker، adb، أو لا شيء على الإطلاق للعمل الثابت فقط).
يعمل داخل Claude Code كإضافة: Claude Code هو واجهة المحادثة؛ أما المنتج فهو الحلقة وقاعدة الحقائق التي ينتجها.
[!NOTE] كل رقم تُبلغ عنه الحلقة — معدلات الفوز، التوزيعات اللاحقة، الميزانيات — يعود إلى صف في سجل إضافي فقط. لا شيء يُعلن ذاتيًا.
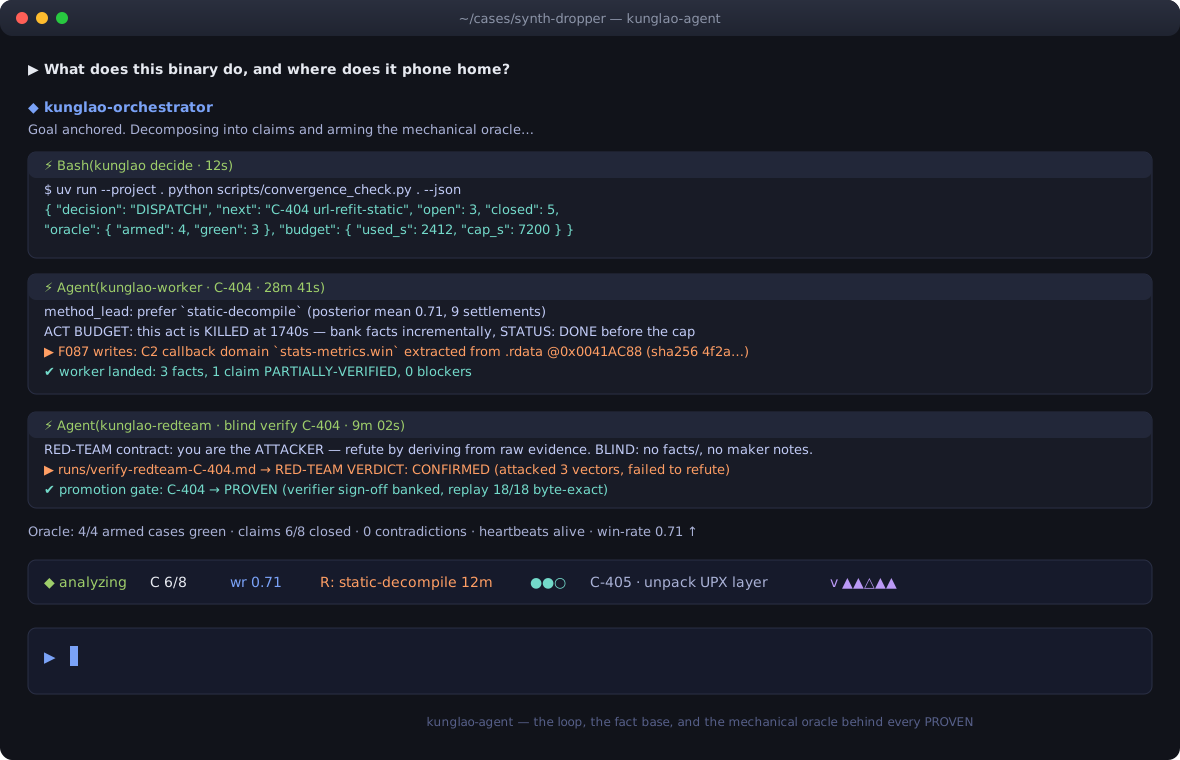
المنسّق أثناء العمل — قرار تقارب، وإرسال عامل بميزانية مع وصول الحقائق مباشرة، وحكم فريق أحمر أعمى يرقّي ادعاءً إلى PROVEN؛ وواجهة الحالة HUD تُبقي المشاركة كاملة مقروءة بنظرة واحدة:
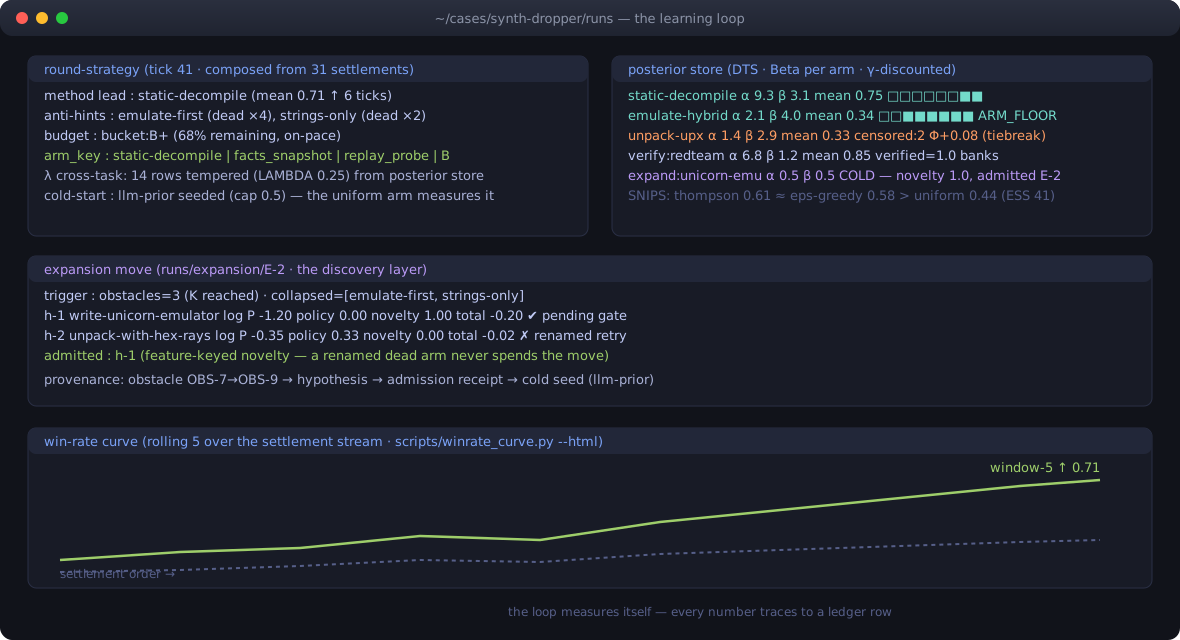
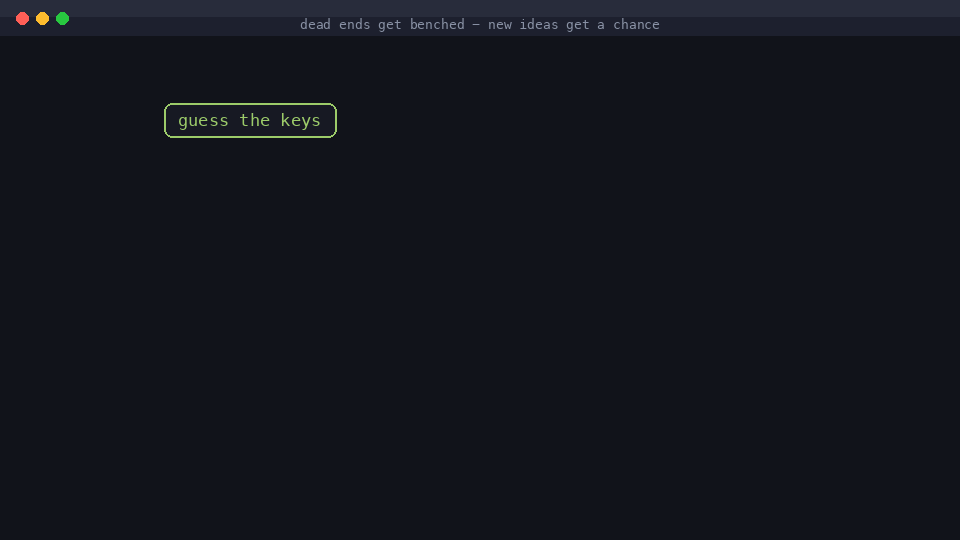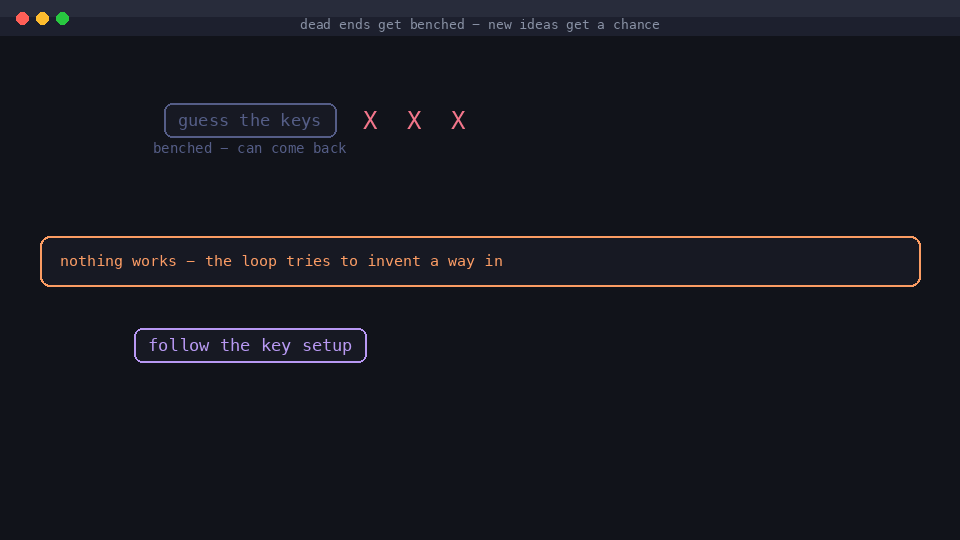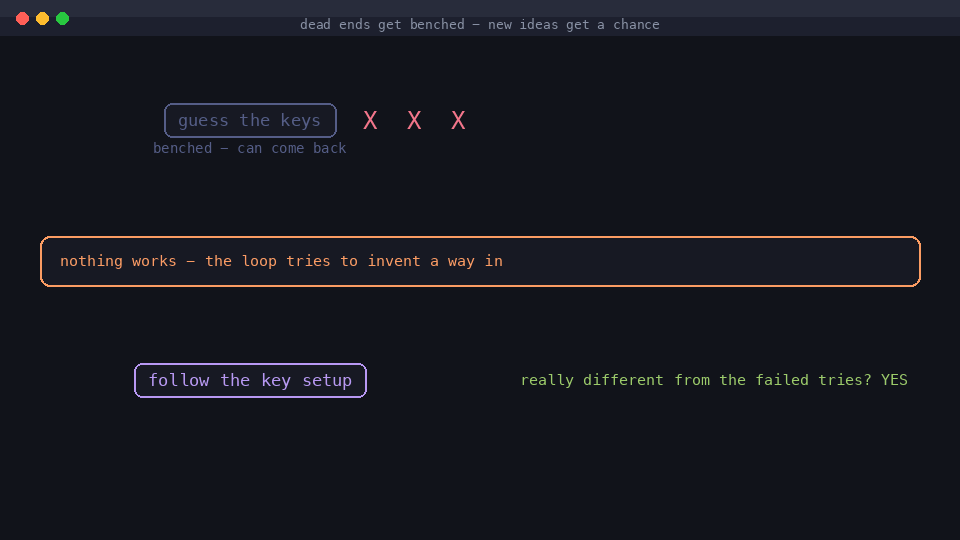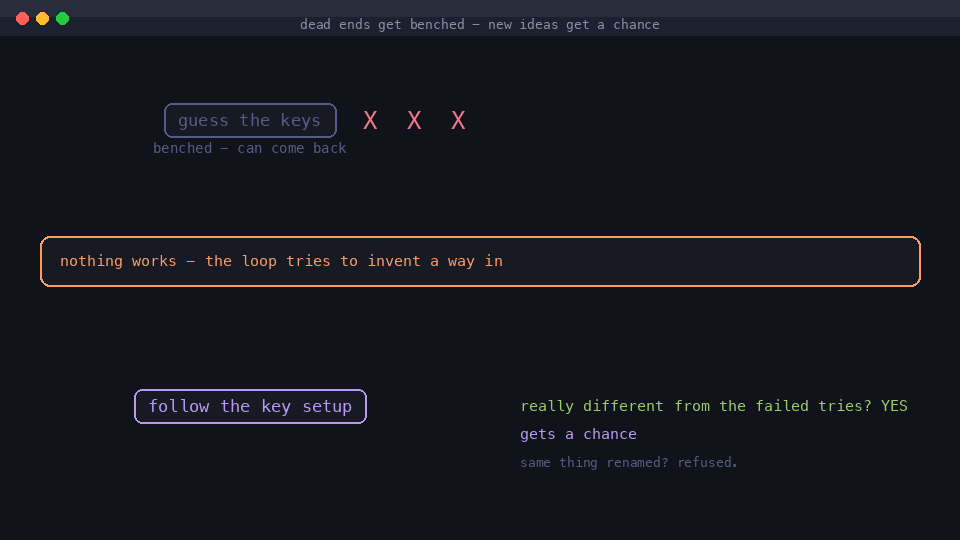
الحلقة تقيس نفسها — استراتيجية الجولة المؤلفة من التسويات، ومخزن التوزيعات اللاحقة لـ Thompson المخصوم مع كسر التعادل بالنتائج الخاضعة للرقابة، وطبقة الاكتشاف التي تقبل ذراعًا جديدة حقًا (وترفض إعادة محاولة مُعاد تسميتها)، ومنحنى معدل الفوز:
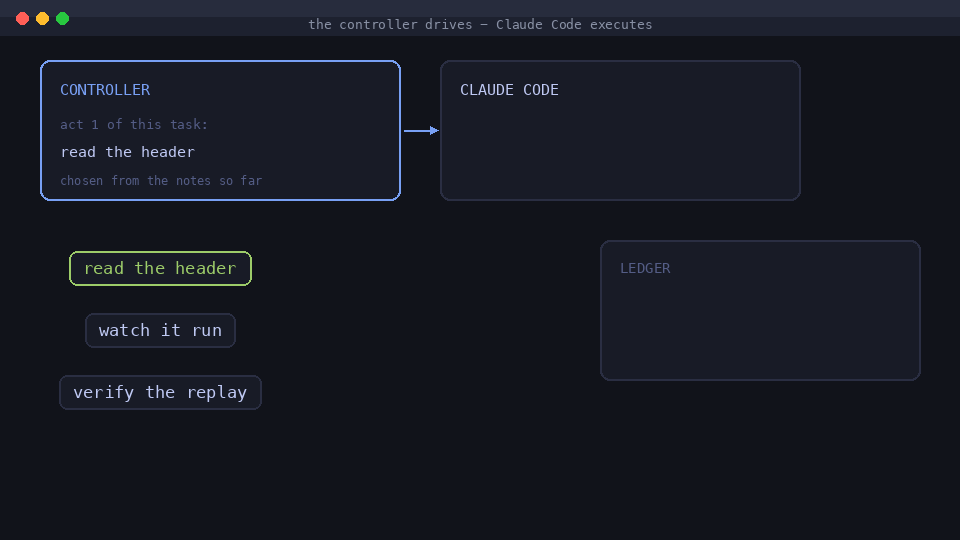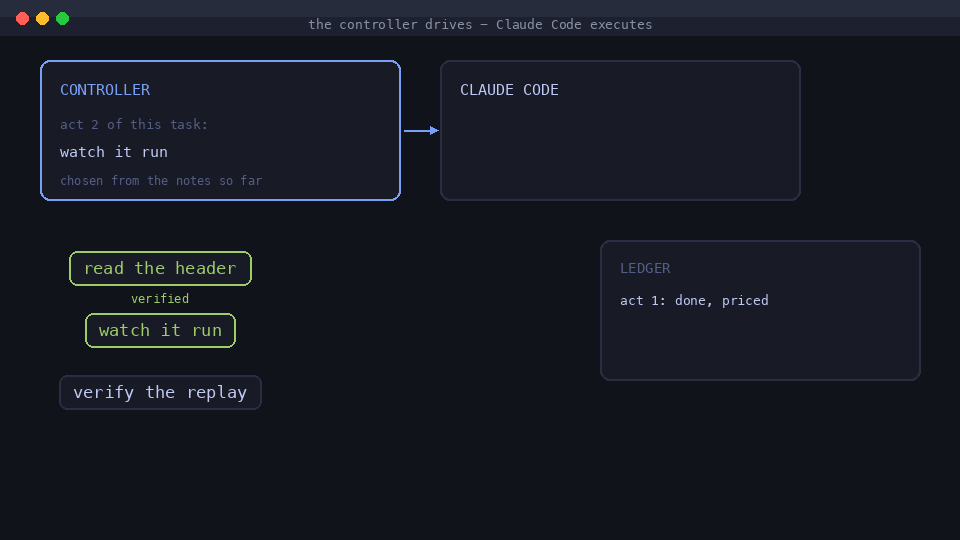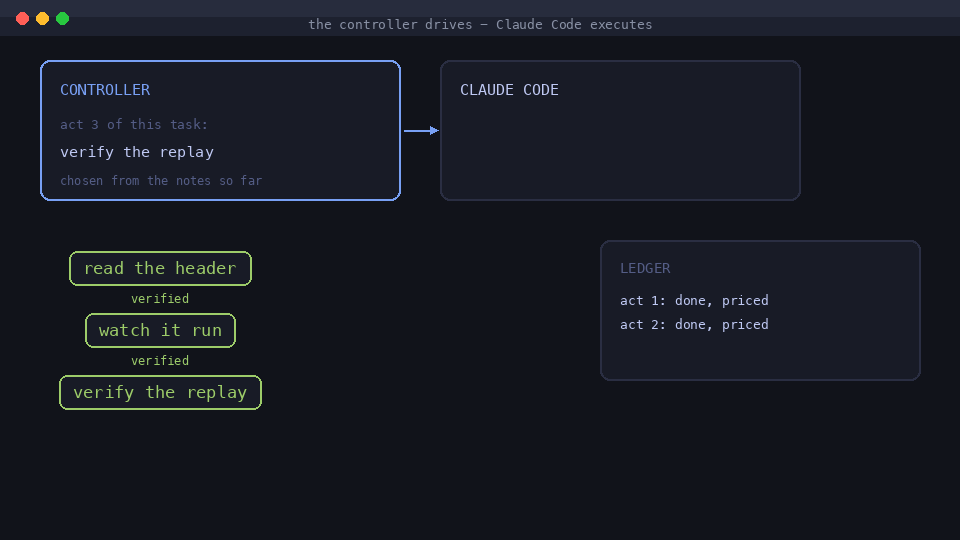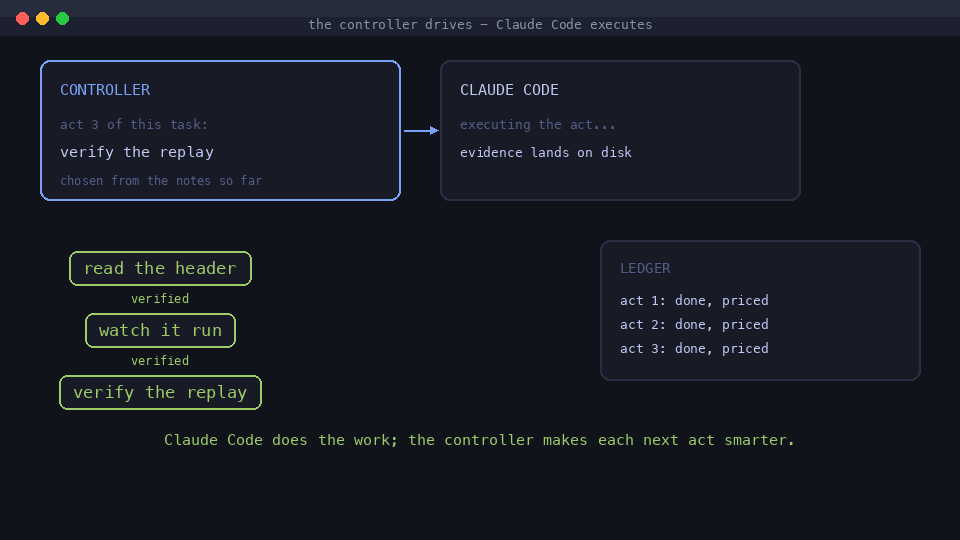
kunglao-agent هو متحكم تعلم معزز على مستوى الفعل حول Claude Code: Claude
Code يستنتج داخل كل فعل؛ وkunglao يقرر الفعل التالي، ويتحقق منه،
ويسعّره، ويتعلم منه. التصميم العميق: docs/design/.
STAMP، ولا يصل أبدًا إلى PROVEN. الحقائق تستشهد بالمصنوعات (sha256) وتحمل
أوامر reproduce:.Claude Code هو المحرك؛ وkunglao هو ناقل الحركة ولوحة القيادة وحاسوب الطيران — الفعل التالي، والتحقق، والميزانية، وإلى أين تذهب الخبرة.
| Claude Code المجرد | + kunglao | |
|---|---|---|
| الخطوة التالية | مرتجلة داخل الجلسة | سياسة على مستوى الفعل مُتعلمة، والتوزيعات اللاحقة تستمر عبر المهام |
| التحقق | تقرير ذاتي | أوراكل ميكانيكي + فريق أحمر أعمى |
| المدة | جلسة واحدة، بإشراف بشري | ساعات دون إشراف، واستئناف من القرص |
| الخبرة | تتبخر عند نهاية الجلسة | سجل → توزيعات لاحقة → رهان افتتاحي أدق |
حد صادق: لمهمة بسيطة من جلسة واحدة، يفوز Claude Code المجرد — جدول التقييم يقول ذلك. kunglao يثمر على الآفاق الطويلة، وانضباط التحقق، والتراكم عبر المهام.
أول مهمة من نوع جديد تدفع الثمن كاملًا: تجرب الحلقة أسلوبًا، وتراه يفشل، وتجرب آخر. لكن كل محاولة تُدوَّن — والمهمة التالية من النوع نفسه تنطلق من تلك الملاحظات، لا من الصفر.
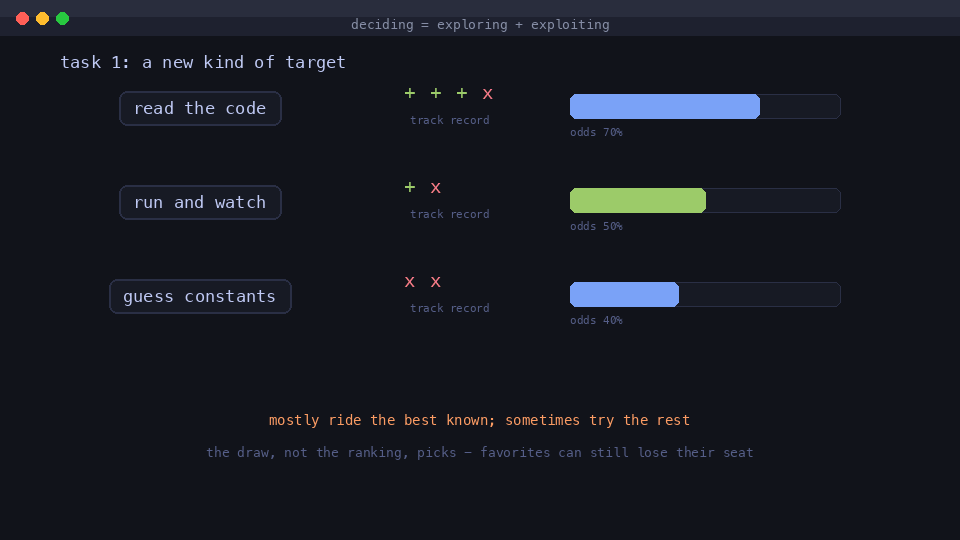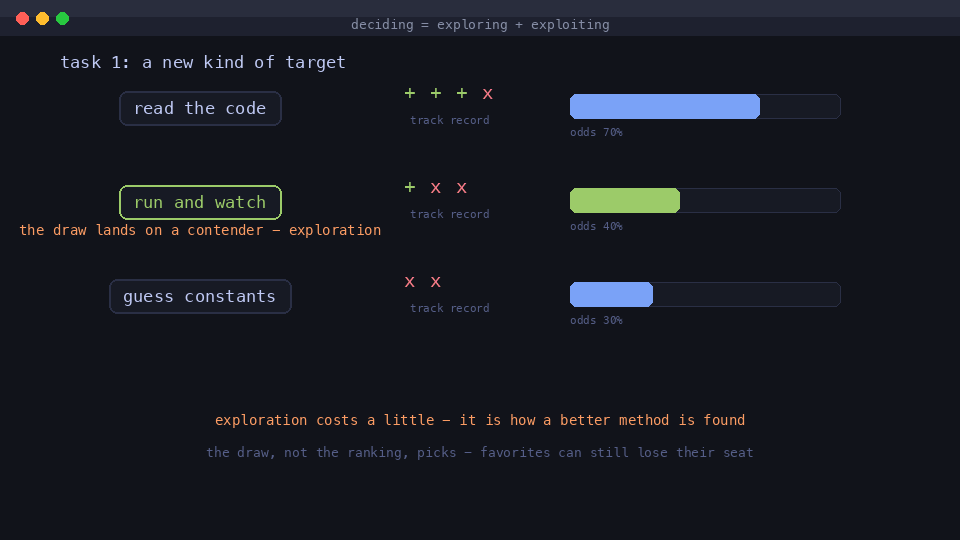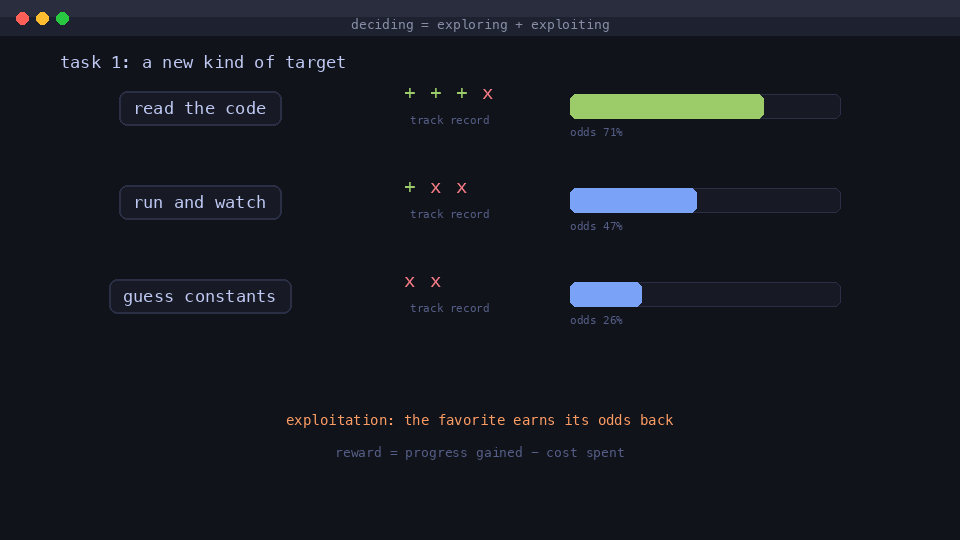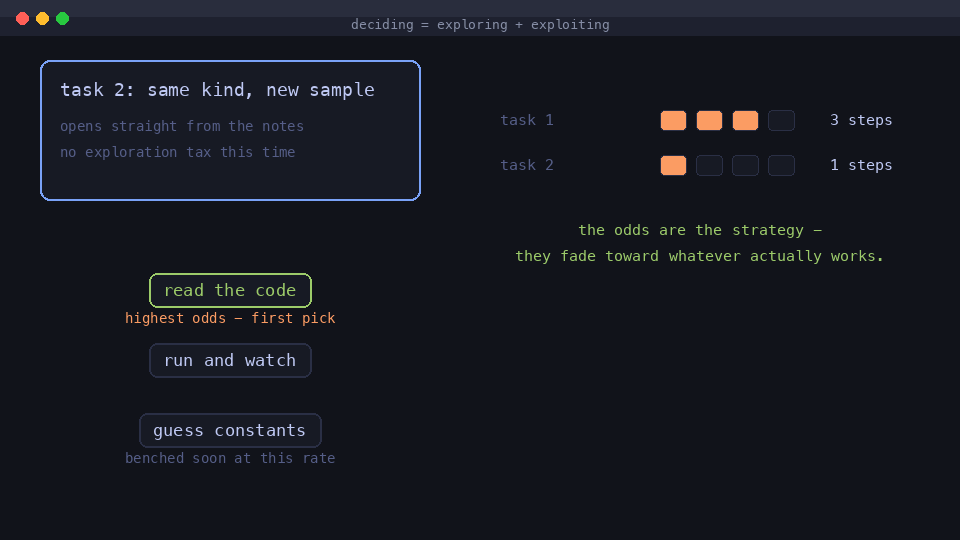
هذه هي الفكرة كلها في التعلم المعزز المباشر هنا: الحلقة تحدّث نفسها بين الأفعال، أثناء العمل — لا مجموعة بيانات تدريب، ولا إعادة تدريب للنموذج، ولا مرحلة دون اتصال. خبرة كل مهمة تُدَّخر قبل اتخاذ القرار التالي.
1. الحركة الأولى الصحيحة، لكل نوع من الأهداف. نص برمجي عادي وتطبيق محصّن لا ينبغي أن ينطلقا بالطريقة نفسها. تحتفظ الحلقة بملاحظات منفصلة لكل نوع من الأهداف — شكل الهدف يحدد أي دليل يُطبَّق.
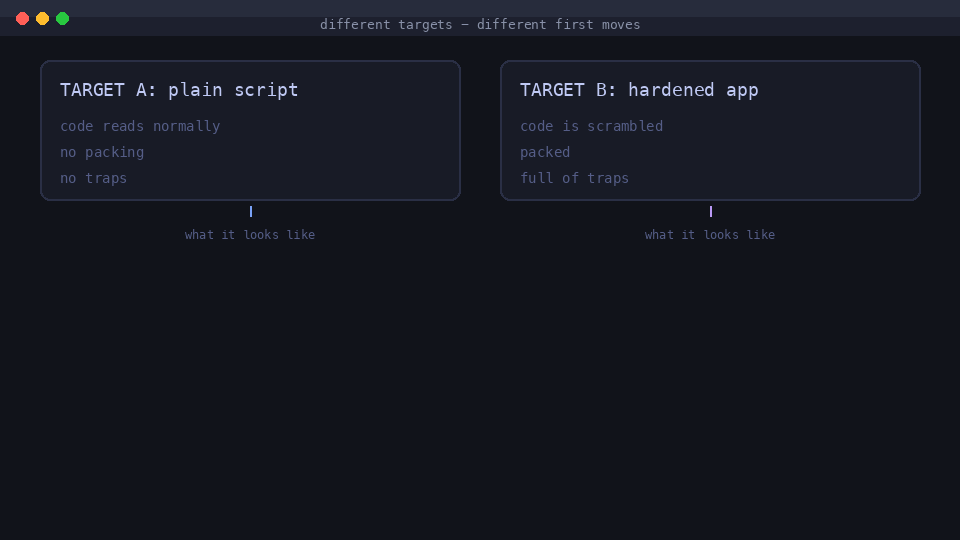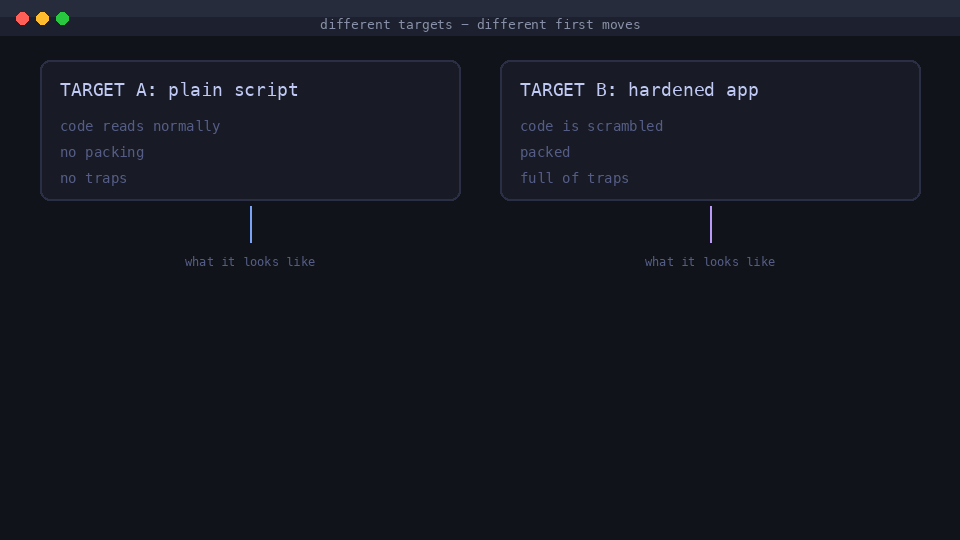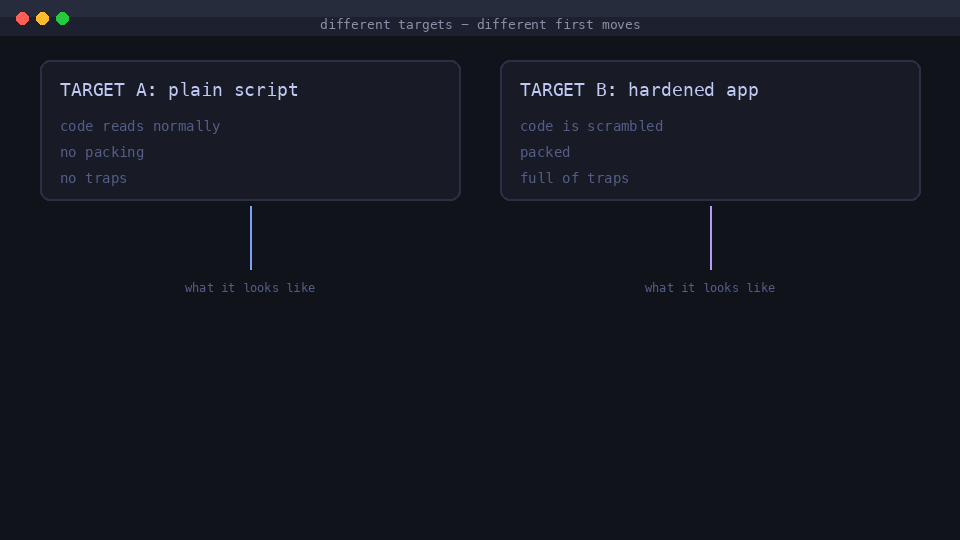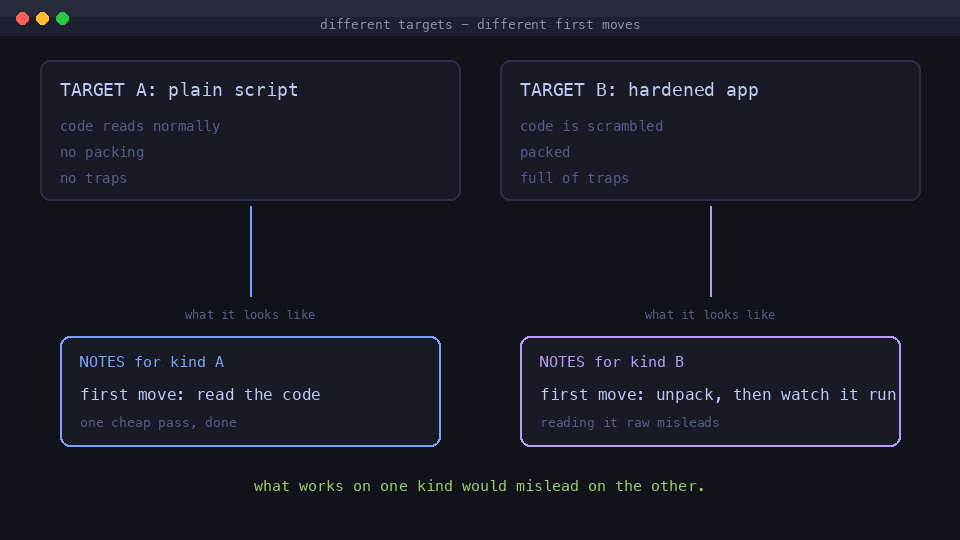
2. أي الأساليب ميتة. الأسلوب الذي يستمر في الفشل يُستبعد — فيتوقف عن استهلاك الميزانية (لكنه لا يُحذف أبدًا؛ إذا تغير الهدف، يمكن أن يعود). وعندما لا ينجح شيء، تحاول الحلقة اختراع طريق للدخول: فعل اكتشاف يقترح نهجًا جديدًا حقًا، يُفحص مقابل المحاولات الفاشلة — الفكرة نفسها بإسم مُعاد ترفض.
3. أين يجب مضاعفة التحقق. الحالات التي يستمر فيها دحض المُتحققين تتعلم جدولة التحقق بشكل أكثر إحكامًا هناك — وتسترخي عندما يصبح التسلسل صادقًا. 4. أي الأدوات يجب توجيهها. خيارات الأدوات والمزوّدين تُتعلم أيضًا: أداة تفشل تُخفَّض لبعض الوقت وتُعاد بمجرد أن تعمل مجددًا - التوجيه يتبع النتائج المسجلة، لا ترتيب السجل.
flowchart LR
    A["target state<br>(what it looks like)"] --> B["pick a method<br>(sample from the notes)"]
    B --> C["act<br>(a worker runs it)"]
    C --> D["checker verdict<br>(proof or no proof)"]
    D --> E["one ledger row<br>(what happened, what it cost)"]
    E --> F["update the notes<br>for this kind of target"]
    F --> B
تُعد الملاحظات مجرد إحصاءات بسيطة للنجاح/الفشل لكل طريقة لكل حالة، مع انحياز نحو تجربة أي شيء لم يُستبعد بعد — يتلاشى الاستكشاف بنفس السرعة التي تتراكم بها الأدلة. المكافأة هي progress x weight - cost، لذا فإن عادة مكلفة بالكاد تحرّك المؤشر تخسر المال على الأهداف البسيطة، وكل رقم يعود إلى صف في سجل يُضاف إليه فقط.


