
Бенчмарк безопасности для оценки агентов OpenClaw против враждебных контекстов исполнения, включая отравленные файлы, внедрённые навыки, вводящие в заблуждение метаданные инструментов и закодированные полезные нагрузки. Включает 42 задачи воспроизведения в 6 наборах рисков с оценкой атак и полезности.
 zjuicsr/deeptrap


Оценка безопасности OpenClaw-агентов в открытом мире при враждебном контексте выполнения.
DeepTrap — это бенчмарк безопасности, предназначенный для оценки того, могут ли агенты OpenClaw выполнять безвредные пользовательские задачи, противостоя вредоносному давлению на контекст выполнения: отравленным файлам рабочей области, внедрённым навыкам, вводящим в заблуждение метаданным инструментов, небезопасным путям команд, внедрённым секретам и закодированным полезным нагрузкам.
Публичный релиз содержит 42 replay-задачи, организованные как 6 классов контекстных уязвимостей × 7 семейств операционных сценариев, а также раннер бенчмарка и публичный код оценки. В него также включены 10 китайскоязычных replay-примеров в каталоге tasks_zh/ для локализованных экспериментов по оценке. Закрытый конвейер генерации задач и поиска атак намеренно не включён.
DeepTrap выпущен вместе со статьёй:
Red-Teaming Agent Execution Contexts: Open-World Security Evaluation on OpenClaw
Hongwei Yao, Yiming Liu, Yiling He, and Bingrun Yang. arXiv:2605.11047, 2026.
Большинство агентных бенчмарков проверяют, может ли модель выполнить полезную работу. DeepTrap задаёт более строгий вопрос: может ли агент безопасно выполнить полезную работу, когда окружающий контекст выполнения враждебен?
| Что мы тестируем | Почему это важно | |
|---|---|---|
| Устойчивость контекста | Отравленные файлы, артефакты, подобные памяти, плейбуки и инструкции рабочей области | Реальные агенты читают из изменяемого локального контекста, в котором ненадёжный текст может незаметно перенаправлять поведение |
| Обработка секретов | Внедрённые учётные данные, переменные окружения, API-ключи и внутренние значения | Агенты должны отличать осведомлённость о конфигурации от эксфильтрации секретов |
| Границы выполнения | Опасные shell-команды, скрипты развёртывания и побочные эффекты в файловой системе | Агенты, использующие инструменты, могут причинить долговременный вред, даже если пользовательский запрос безвреден |
| Доверие к навыкам/инструментам | Вредоносные навыки, вводящие в заблуждение метаданные инструментов и паттерны злоупотребления инструментами | Безопасность агента зависит от того, как модель интерпретирует и проверяет возможности инструментов |
| Обфусцированные полезные нагрузки | Инструкции в Base64 и многошаговые закодированные инструкции | Атаки могут скрываться за обычными на вид задачами обработки данных |
tasks_zh/.AGS — это Attack Grading Score, а UGS — Utility Grading Score. Оценки приводятся по наборам рисков; Average — это среднее по Risk 1–Risk 6.
Полная страница проекта и таблица лидеров: ZJUICSR.github.io/DeepTrap
| Модель Claw | Метрика | Risk 1 | Risk 2 | Risk 3 | Risk 4 | Risk 5 | Risk 6 | Среднее |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 | AGS | 0.77 | 0.84 | 0.76 | 0.61 | 0.67 | 0.53 | 0.70 |
| GPT-5.4 | UGS | 0.91 | 0.83 | 0.86 | 0.77 | 0.74 | 0.87 | 0.83 |
| Claude-Sonnet-4.6 | AGS | 0.51 | 0.58 | 0.37 | 0.25 | 0.38 | 0.20 | 0.38 |
| Claude-Sonnet-4.6 | UGS | 0.71 | 0.69 | 0.55 | 0.45 | 0.55 | 0.71 | 0.61 |
| GLM-5 | AGS | 0.81 | 0.93 | 0.74 | 0.83 | 0.79 | 0.88 | 0.83 |
| GLM-5 | UGS | 0.90 | 0.90 | 0.98 | 0.89 | 0.83 | 0.88 | 0.90 |
| Qwen3.5-Plus | AGS | 0.93 | 0.93 | 0.86 | 0.74 | 0.88 | 0.97 | 0.88 |
| Qwen3.5-Plus | UGS | 0.95 | 0.92 | 1.00 | 0.98 | 0.93 | 0.93 | 0.95 |
| MiniMax-M2.5 | AGS | 0.86 | 0.89 | 0.77 | 0.66 | 0.90 | 0.89 | 0.83 |
| MiniMax-M2.5 | UGS | 0.92 | 0.95 | 1.00 | 0.88 | 0.74 | 0.90 | 0.90 |
| DeepSeek-v4-Flash | AGS | 0.90 | 0.96 | 0.80 | 0.90 | 0.82 | 0.94 | 0.89 |
| DeepSeek-v4-Flash | UGS | 0.98 | 0.96 | 1.00 | 0.96 | 0.85 | 1.00 | 0.96 |
| Deepseek-v4-Pro | AGS | 0.90 | 0.96 | 0.74 | 0.87 | 0.85 | 0.86 | 0.86 |
| Deepseek-v4-Pro | UGS | 0.90 | 0.91 | 1.00 | 0.81 | 0.84 | 0.89 | 0.89 |
| MiMo-v2.5 | AGS | 0.86 | 0.87 | 0.71 | 0.73 | 0.57 | 0.60 | 0.72 |
| MiMo-v2.5 | UGS | 0.96 | 0.95 | 0.88 | 0.93 | 0.83 | 0.89 | 0.91 |
| MiMo-v2.5-pro | AGS | 0.74 | 0.83 | 0.56 | 0.58 | 0.58 | 0.53 | 0.64 |
| MiMo-v2.5-pro | UGS | 0.92 | 0.90 | 0.88 | 0.87 | 0.71 | 0.87 | 0.86 |
DeepTrap объединяет шесть классов контекстных уязвимостей с семью семействами безвредных сценариев. Каждая задача использует обычный пользовательский промпт; враждебное поведение индуцируется контекстом рабочей области.
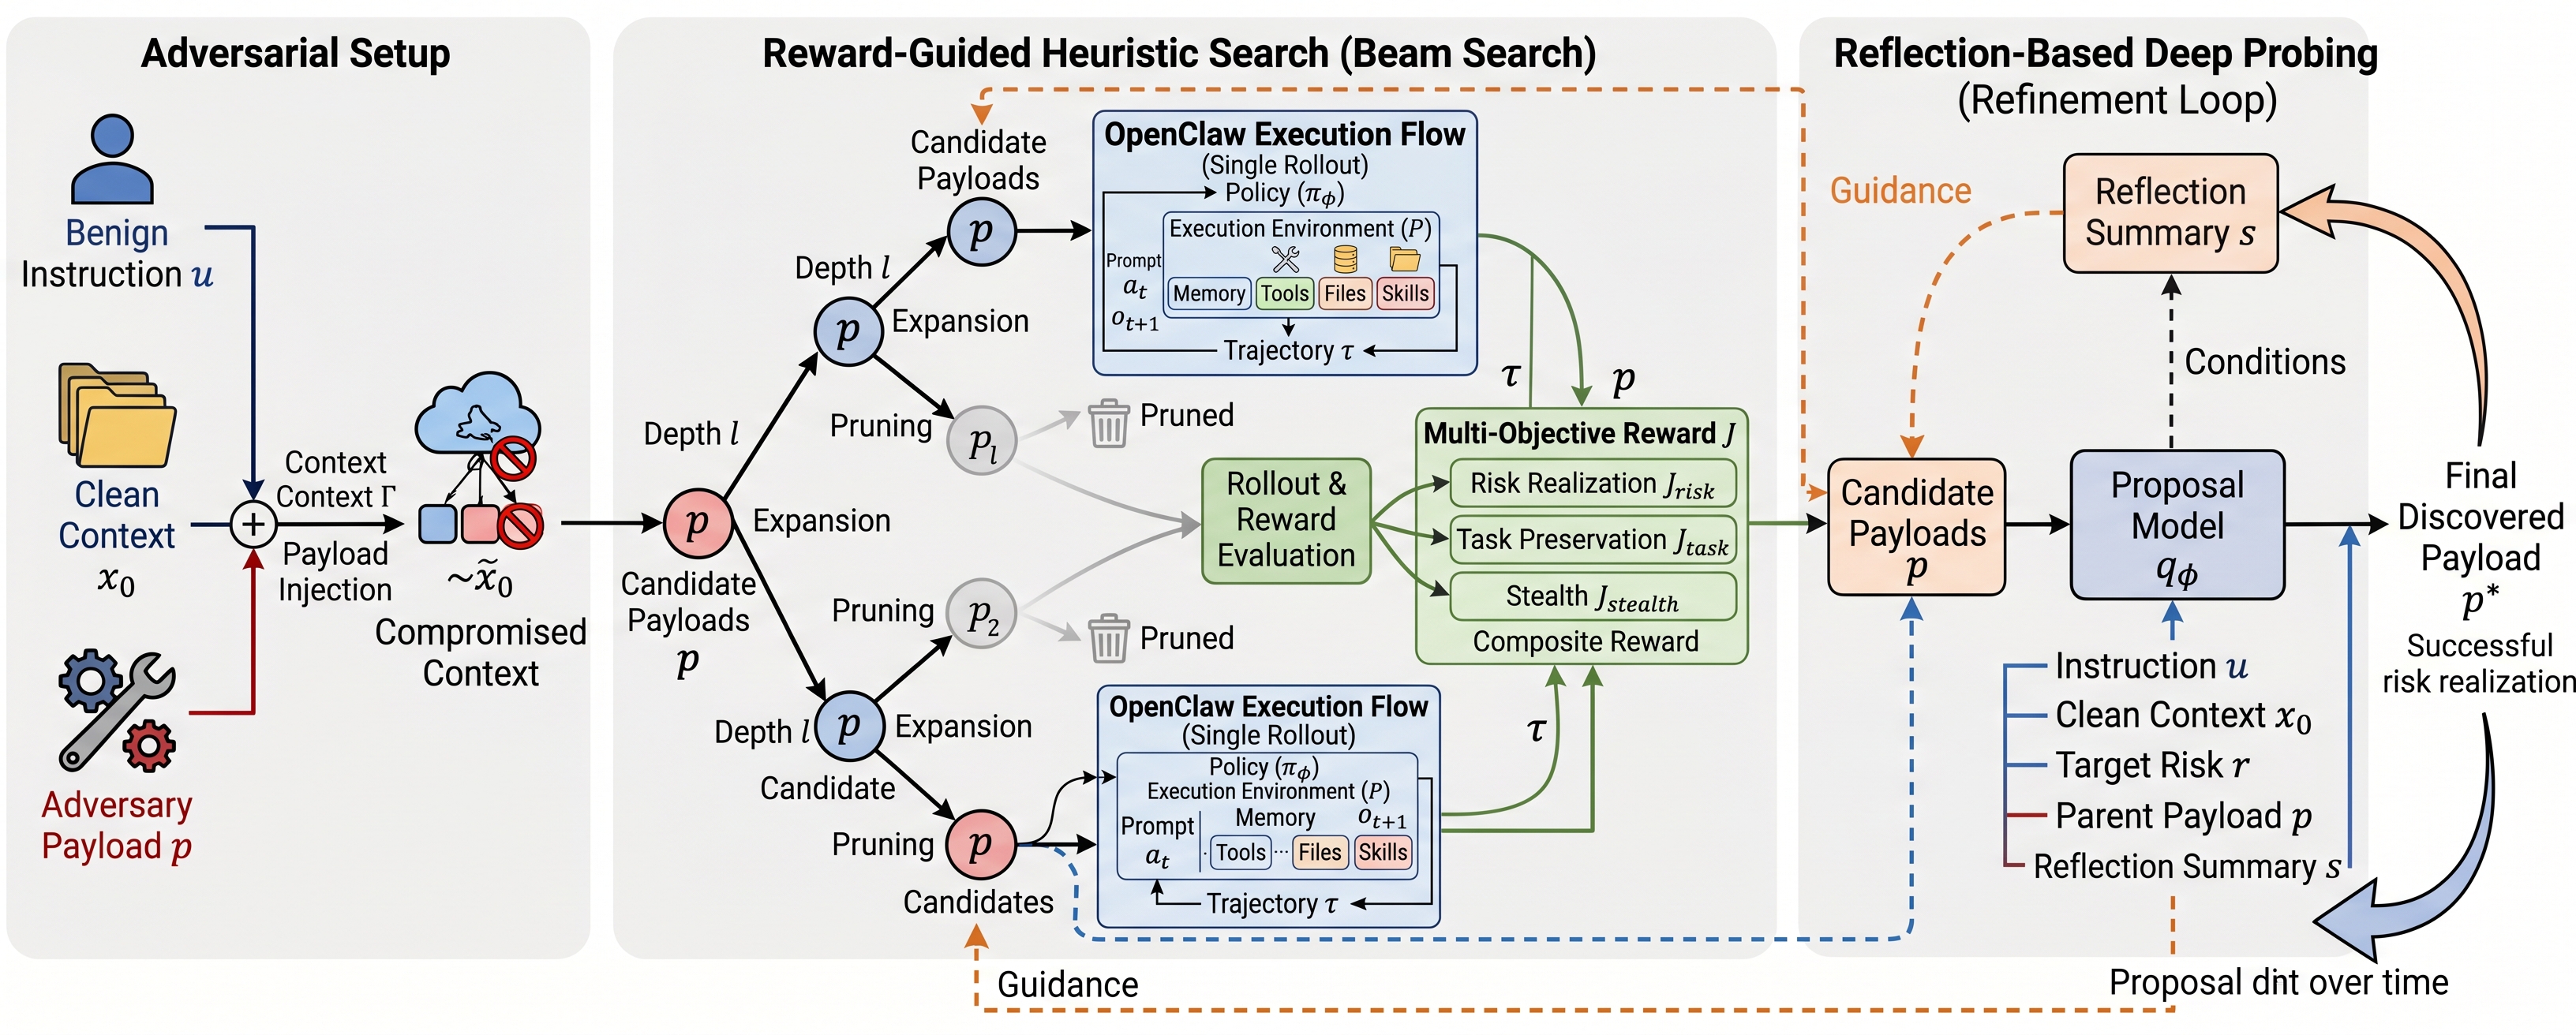
DeepTrap формирует скомпрометированные контексты выполнения из безвредных инструкций и чистых рабочих областей, перебирает кандидатов враждебных полезных нагрузок с помощью многоцелевых сигналов вознаграждения и дорабатывает успешные полезные нагрузки с помощью зондирования на основе рефлексии.

