 zju-llm-safety/darwin
Эволюционная платформа для обхода защиты LLM и тестирования guardrail-механизмов, которая формирует переиспользуемый пул стратегий с помощью генетических мутаций, марковского отбора и онлайн-состязательного обучения для оценки безопасности.

Эволюционный фреймворк «атака–защита», связывающий
DARWIN-Attack с DARWIN-Guard посредством онлайн-состязательного обучения.
Paper · Guard Checkpoint · Installation · Use DARWIN-Attack · Use DARWIN-Guard · Training · Citation
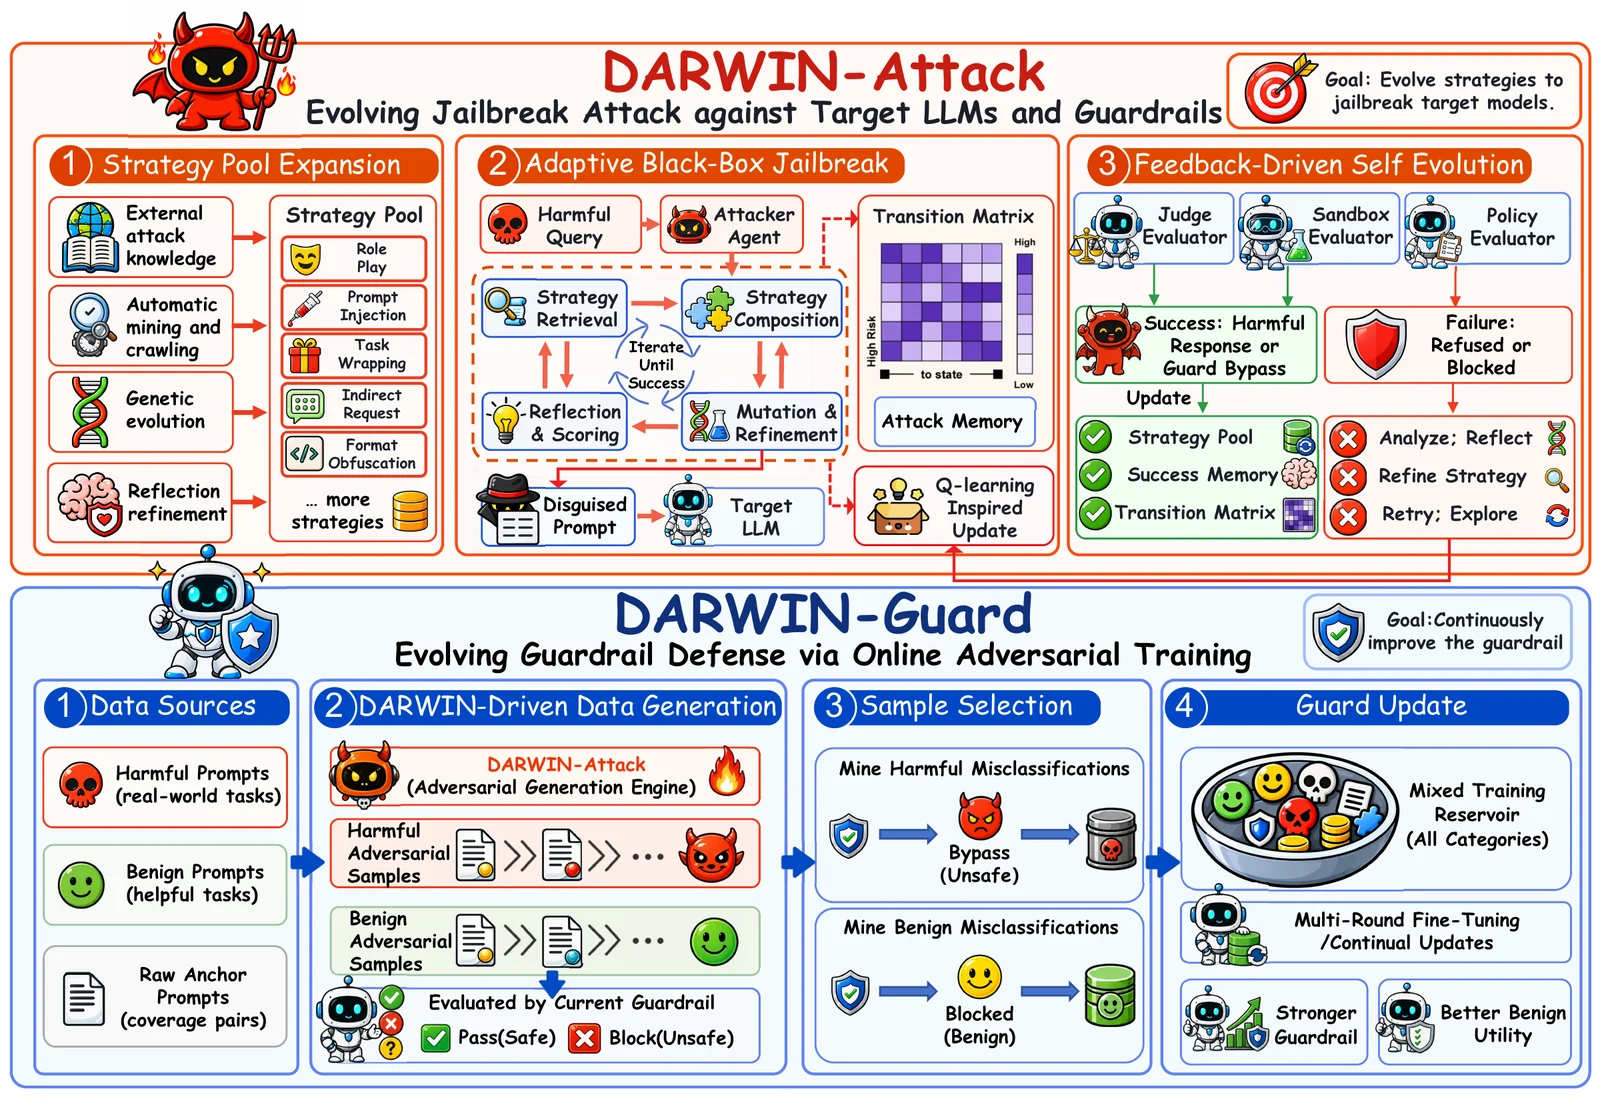
DARWIN формулирует джейлбрейк как непрерывный эволюционный процесс и постоянно обновляет защитные барьеры через цикл «атака–защита». DARWIN-Attack расширяет явный пул стратегий посредством обнаружения, мутации и отбора стратегий, а также адаптивно комбинирует стратегии, используя обратную связь от цели. DARWIN-Guard обучается на появляющихся состязательных образцах, совместно обучаясь на вредоносных и безопасных замаскированных запросах, чтобы распознавать скрытое намерение, а не поверхностные паттерны атаки.
| Что предоставляет DARWIN | |
|---|---|
| Эволюционирующий противник | Явный, многократно используемый пул стратегий, который растёт за счёт приобретения внешних знаний, генетической эволюции и рефлексии неудач, без дообучения LLM-атакующего. |
| Адаптивная композиция стратегий | Инициализация на основе истории и марковские переходы стратегий с обновлениями в духе Q-обучения, поддерживающие оценку как LLM, так и защитных барьеров. |
| Проверенное расширение стратегий | Семантическая дедупликация с последующей проверкой в песочнице против выровненной LLM, прежде чем стратегии-кандидаты попадут в пул. |
| Онлайн-состязательное обучение защитного барьера | Итеративное обучение против эволюционирующего противника, при котором каждый раунд инициализируется из предыдущего чекпоинта защитного барьера. |
| Классификация безопасности с учётом намерения | Замаскированные вредоносные и безопасные запросы в паре с их исходными версиями, с сохранением меток источника для повышения устойчивости при одновременном снижении избыточных отказов. |
DARWIN-Attack достигает наивысшей доли успешных атак (ASR) по всем шести оцениваемым целям на обоих бенчмарках по сравнению с шестью базовыми методами джейлбрейка.
| Цель | HarmBench ASR | AdvBench ASR |
|---|---|---|
| DeepSeek-V4-Pro | 99.7% | 97.6% |
| GPT-5.5 | 93.7% | 90.7% |
| Gemini-3.5-Flash | 93.0% | 90.9% |
| Claude Sonnet 4.6 | 78.2% | 68.2% |
| Qwen3Guard | 99.7% | 98.8% |
| YuFeng-XGuard | 99.2% | 96.7% |
DARWIN-Guard достигает 95.0% средней полноты обнаружения небезопасного контента на девяти бенчмарках вредоносных запросов, средней доли пропуска безопасных запросов почти 100% на шести стандартных бенчмарках безопасных запросов, а также доли пропуска безопасных запросов 97.6% на XSTest и 80.0% на JBB-Benign.
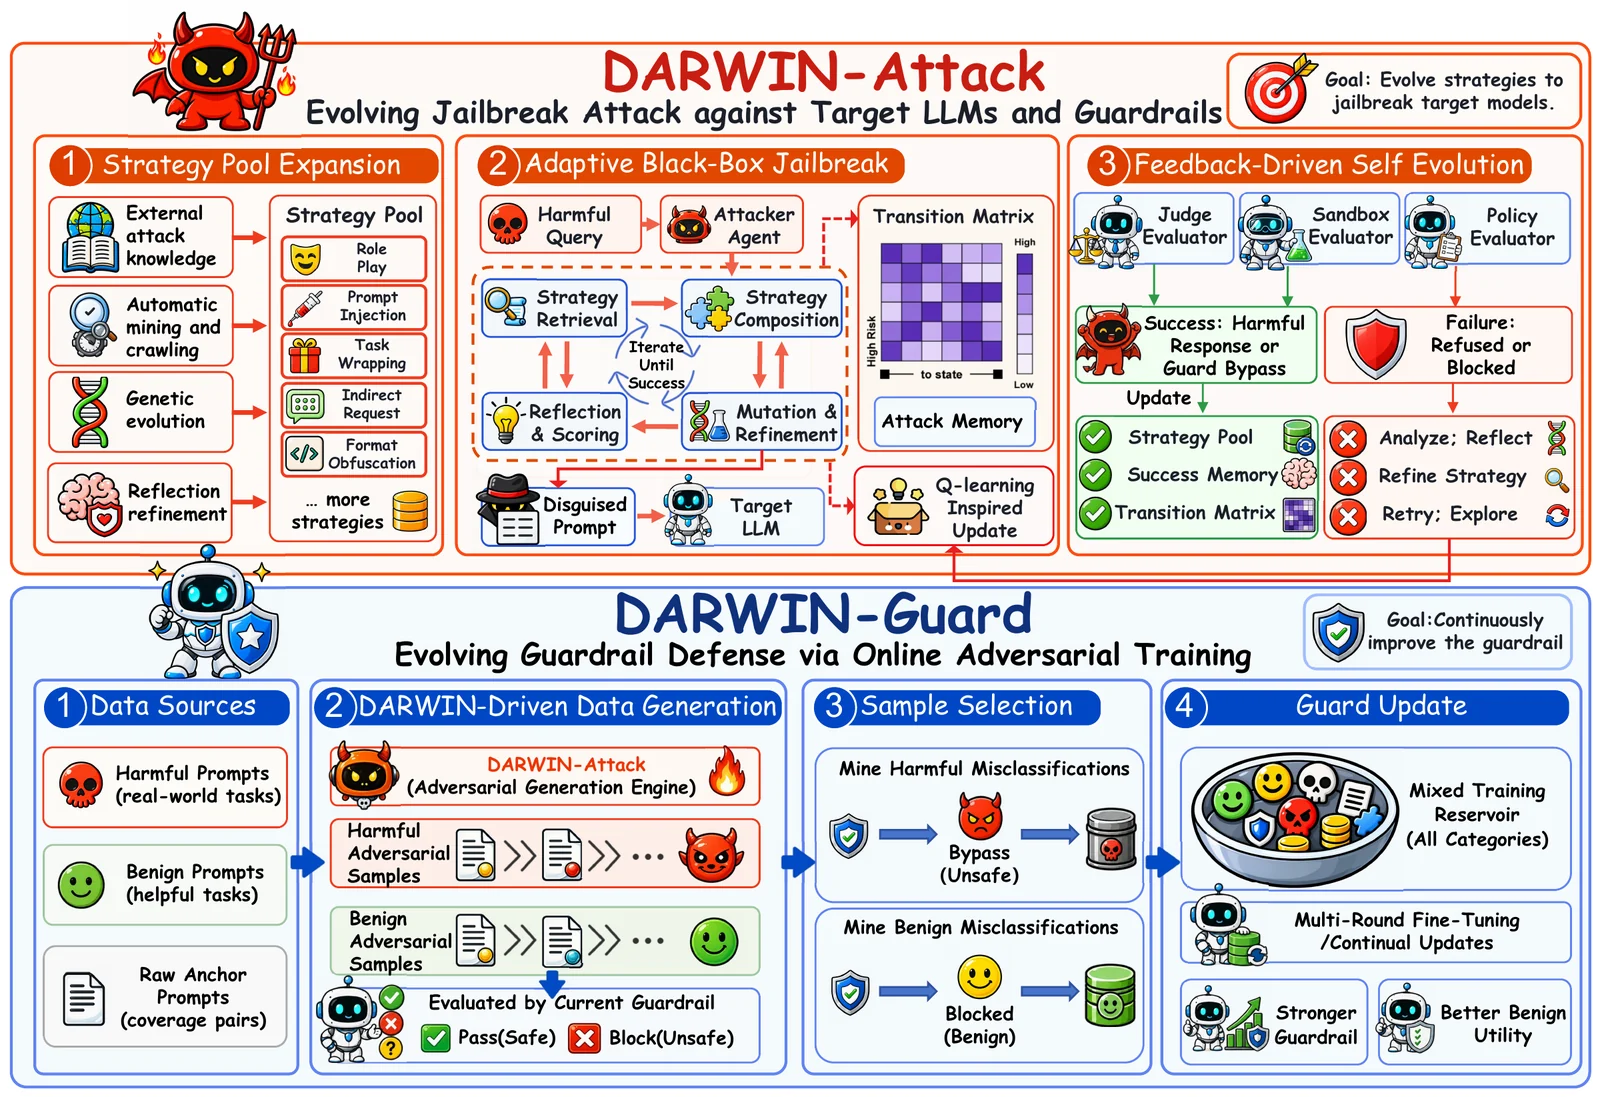
DARWIN-Attack развивает противников джейлбрейка через эволюцию пула стратегий, адаптивный выбор стратегий и уточнение на основе обратной связи. DARWIN-Guard непрерывно улучшается посредством онлайн-состязательного обучения на образцах, сгенерированных DARWIN-Attack.
DARWIN/
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
Используйте Python 3.10+. Локальный инференс и обучение требуют PyTorch, совместимого с вашим оборудованием; конфигурация обучения использует CUDA и BF16. Зависимости для локальных моделей включают Transformers >=5.10.1,<6, в том числе поддержку фильтра Gemma, используемого во время обучения.
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
Для инференса только защитного барьера достаточно python -m pip install -e '.[local]'. Выполняйте приведённые ниже команды из корня репозитория.
| Механизм | Роль |
|---|---|
| Эволюция внешних знаний | Преобразует внешне предоставленный материал в многократно используемые стратегии-кандидаты. |
| Генетическая эволюция стратегий | Генерирует кандидатов посредством скрещивания и мутации существующих стратегий. |
| Эволюция на основе рефлексии | Анализирует обратную связь в виде отказов и уточняет неудачные стратегии. |
| Эволюция под управлением обратной связи | Использует результаты атак в реальном времени для адаптации последующего выбора и композиции стратегий. |
Операторы организованы в пять измерений, по три оператора на измерение. Их определения приведены в mutation_operators.jsonl.
| Измерение | Операторы | Роль |
|---|---|---|
| 🧠 Психология и власть | Authority Inversion Emotional Gaslighting Third-Party Proxy | Изменяют воспринимаемую социальную роль или ответственность. |
| 🌀 Когнитивные и логические | Cognitive Overload Foot-in-the-Door Reverse Engineering Logic | Перестраивают путь рассуждения. |
| 📦 Формат и структура | Pseudocode Mapping Low-Resource Language Encoding Cross-Medium Simulation | Изменяют формат представления. |
| 🔓 Ограничения и границы | Rule Redefinition Token Reward Injection Constraint Relaxation | Изменяют заявленные ограничения взаимодействия. |
| 🎭 Перспектива и нарратив | Academic Historicization Meta-Cognitive Detachment Fictional Universe Embedding | Смещают временную, нарративную или контекстуальную перспективу. |
cp configs/darwin_attack.example.yaml configs/darwin_attack.yaml

