
 zju-llm-safety/ascent
Фреймворк тонкой настройки, который применяет первопорядковую оптимальную калибровку безопасности и периодическую перекалибровку к LLM, сохраняя безопасно-совместимые обновления при одновременном повышении полезности для нижестоящих задач.

Оптимальная тонкая настройка первого порядка с перекалибровкой для совместного повышения безопасности и полезности
ASCENT выводит оптимальное обновление калибровки безопасности первого порядка и соответствующую структуру, связанную с безопасностью, оптимизирует обновления для нижестоящих задач, чтобы сохранить компоненты, совместимые с безопасностью, и подавить компоненты, ухудшающие безопасность, а также периодически перекалибрует эту структуру во время тонкой настройки для совместного повышения безопасности и полезности для нижестоящих задач.
Метод · Быстрый старт · Данные · Конфигурация · Оценка
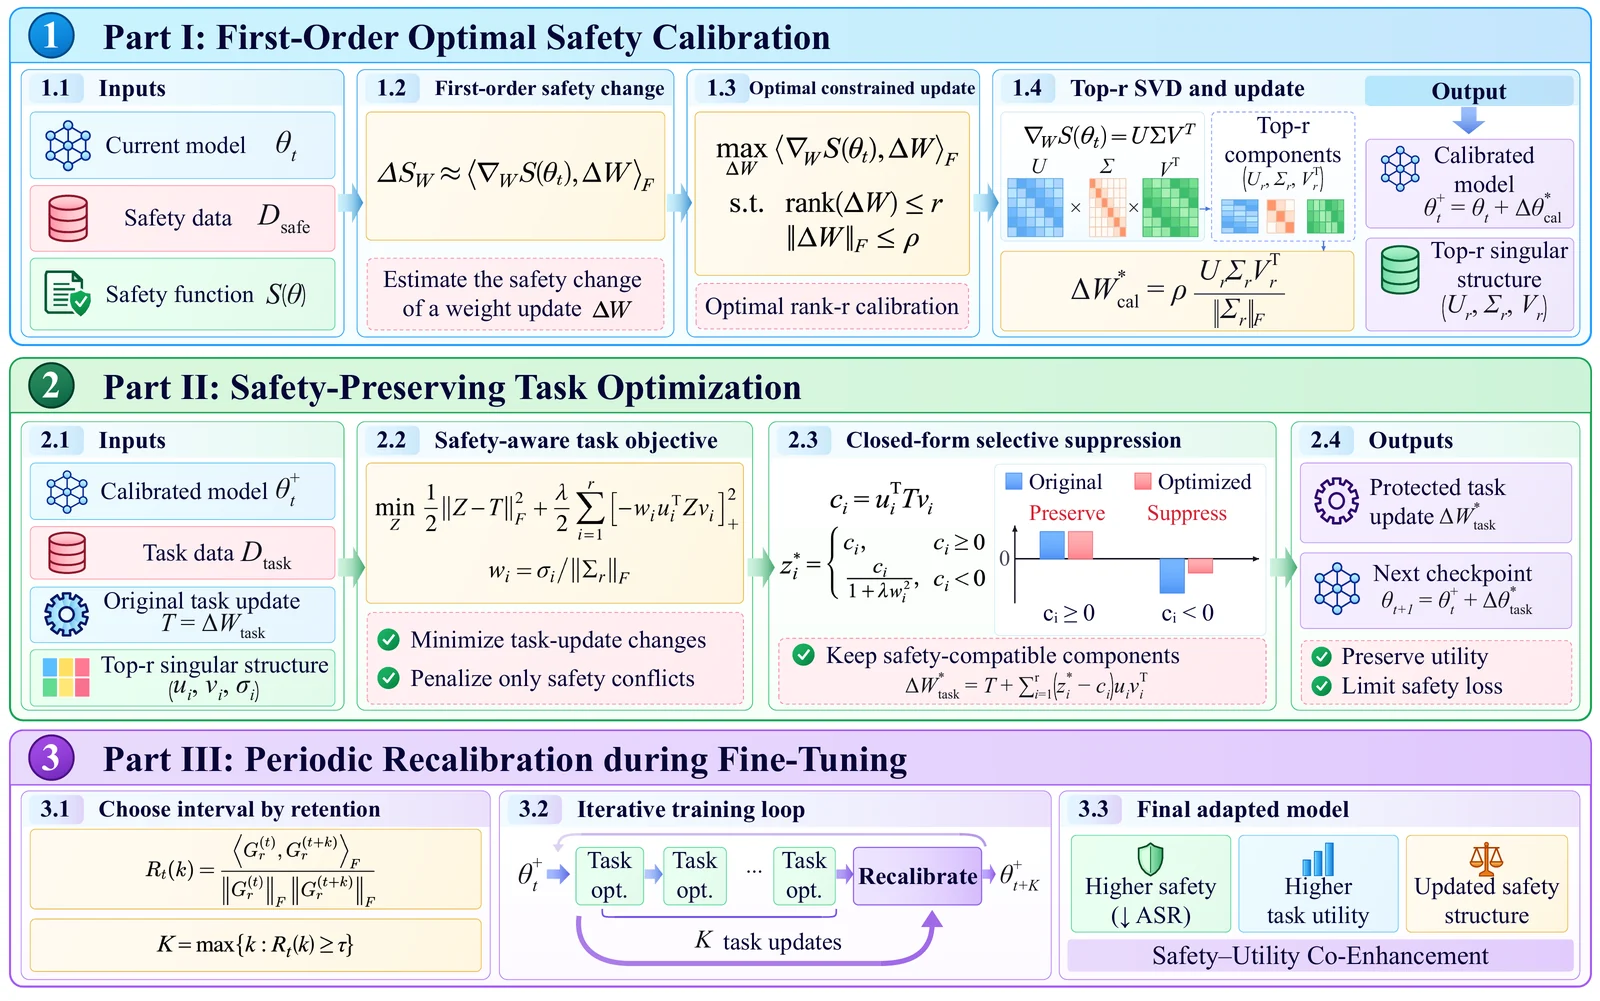
config.toml.Требования: Python 3.12 и локальные контрольные точки модели. Обучение использует два CUDA GPU: один для целевой модели и один для Llama Guard; каждая модель должна помещаться на своём GPU.
pip install -r requirements.txt
cp config.example.toml config.toml
Заполните пустые значения в config.toml, следуя его встроенным комментариям, затем запустите:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
Добавьте
--execute, чтобы обучать, генерировать ответы или сохранять результаты оценки.
Выберите новый выходной каталог вне репозитория с местом для контрольных точек. По завершении обучение выводит путь к итоговой объединённой модели.
Предоставьте JSON-массивы с настроенным количеством записей:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json, с непересекающимися входными данными train/test.| Датасет | Обязательные поля |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name: World, Sports, Business, или Sci/Tech |
| GSM8K | question, answer с финальным ответом после #### |
| OpenBookQA | question_stem, choice_labels: ["A","B","C","D"], четыре choice_texts, answer_key: A–D |
| HarmBench | только goal; опционально id, source; без сохранённых ответов |
Задайте вашу модель, задачу и гиперпараметры в config.toml. Загрузка модели
и выбор матрицы следуют model.key.
Используйте evaluate.py для обоих режимов; генерация требует полностью объединённой локальной модели.
Предоставьте свои собственные данные и внешние оценки безопасности. Никакие датасеты, онлайн-судья или
конфигурация API не поставляются в комплекте.
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
Задачи: samsum, agnews, gsm8k, openbookqa. Метрики — ROUGE-L для SAMSum
и accuracy/exact match для остальных, выводятся в процентах. Чтобы оценить сохранённые
ответы, замените --model-path на --responses /path/to/responses.json.
Предоставьте фиксированные промпты в виде записей с id, goal и опциональным prompt (по умолчанию
используется goal). Держите исходную вредоносную цель отдельно от промпта атаки.
Сгенерируйте ответы:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
Агрегируйте внешние оценки:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
Оценки — это JSON-записи { "id": "...", "score": 1 }, использующие ID ответов и
оценки 1–5 (null для неудачных суждений). Оценки 4–5 считаются успешными атаками;
используйте --success-threshold 5, чтобы
учитывать только 5. Отсутствующие или неудачные суждения не дают итогового ASR.
Для любого режима входные данные, превышающие --max-input-tokens после форматирования чата,
отклоняются, а не усекаются. Установите лимит в пределах контекстной ёмкости модели,
оставив место для генерируемых токенов.






