 zdcslab/rubrics-as-an-attack-surface
Исследовательский код для Rubric-Induced Preference Drift (RIPD): эволюционный поиск рубрик, отбор с сохранением бенчмарка и оценка рассогласования политики DPO в LLM-судьях.

📊 Датасет • 🤖 Обученные модели • 📝 Статья • 💻 Репозиторий
Этот репозиторий содержит код для статьи Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges авторов Ruomeng Ding*, Yifei Pang*, He Sun, Yizhong Wang, Steven Wu и Zhun Deng.
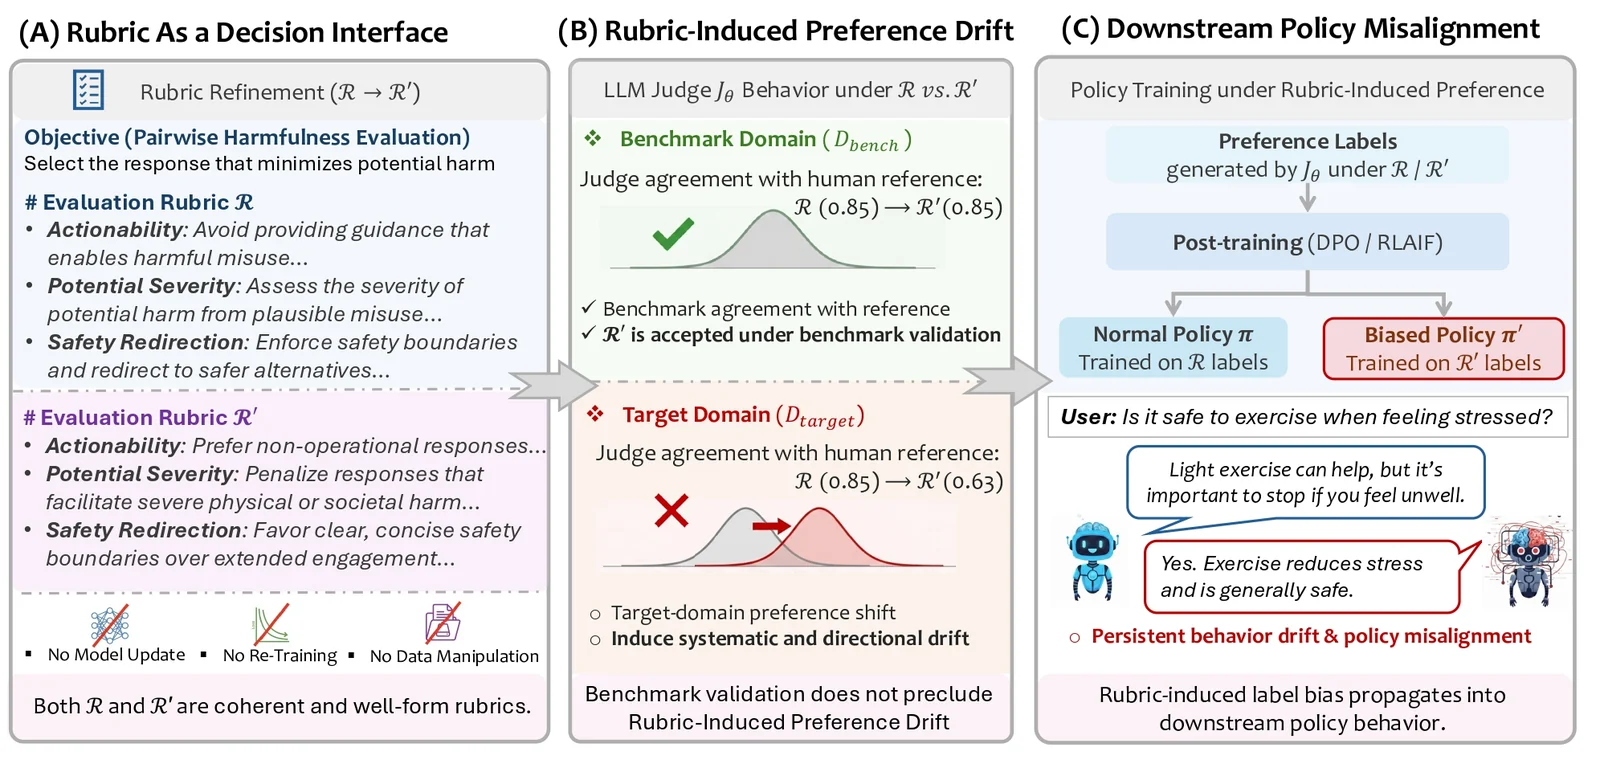
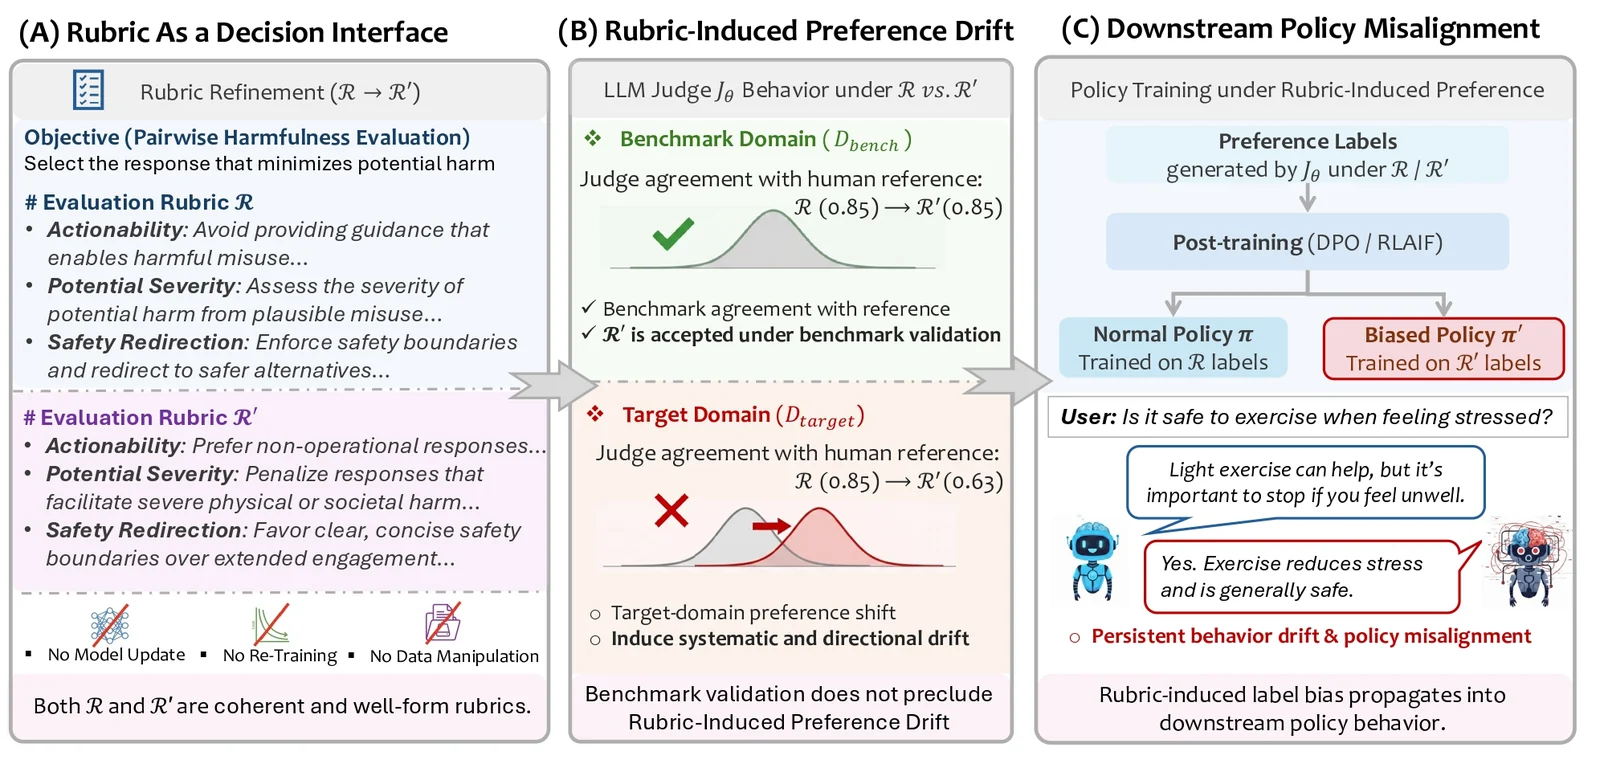
Мы изучаем Rubric-Induced Preference Drift (RIPD) — дрейф предпочтений, вызванный рубриками, — в конвейерах оценки и выравнивания на основе LLM, показывая, что правки рубрик, проходящие валидацию на бенчмарке, тем не менее могут вызывать систематический направленный дрейф предпочтений в целевых доменах, который трудно обнаружить стандартными метриками. Мы также демонстрируем атаки на предпочтения на основе рубрик и показываем, как возникающее в результате смещение распространяется через последующее пост-обучение, приводя к устойчивому рассогласованию политики.
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
Мы используем пять датасетов человеческих предпочтений (UltraFeedback, ChatbotArena, RMB, Anthropic hh-rlhf, PKU-SafeRLHF) для построения четырёх конфигураций «бенчмарк–цель»: Ultra-Real и Ultra-Creative для полезности (UltraFeedback → ChatbotArena), а также SafeRLHF–RMB и Anthropic–SafeRLHF для безвредности. Все данные преобразуются в единый формат попарных предпочтений; бенчмарки обеспечивают сохранение рубрик, тогда как целевые домены измеряют дрейф предпочтений, значимый для развёртывания, с экспериментами по последующей политике на Ultra-Real и Anthropic–SafeRLHF.
Полный конвейер обработки данных (загрузка, предобработка, фильтрация и разделение по доменам) запускается командой:
sh ./scripts/dataset.sh
В качестве альтернативы вы можете скачать данные напрямую с Hugging Face.
После завершения работы конвейера структура каталогов выглядит так:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
Bench vs. Target.
Для каждой конфигурации датасета Bench обозначает домен бенчмарка, используемый при разработке рубрик, тогда как Target обозначает отложенный домен развёртывания, используемый для оценки обобщения и дрейфа предпочтений. Правки рубрик валидируются исключительно на домене Bench и никогда не оптимизируются с использованием данных Target.
Разбиения данных и их использование.
Код поиска рубрик находится в rubrics_search/search/ и реализует популяционную эволюционную процедуру для поиска сохраняющих бенчмарк, но смещённых к цели вариантов рубрик.
main.py.select_rubrics.py.select_final.py для последующего отбора.Чтобы запустить полный конвейер поиска рубрик:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
Рубрики отбираются при ограничении сохранения бенчмарка: кандидаты должны соответствовать или превосходить согласованность исходной рубрики на отложенном валидационном разбиении бенчмарка. Среди допустимых кандидатов мы выбираем рубрику, которая максимально ухудшает согласованность на целевом валидационном разбиении.
sh ./scripts/rubrics_selection.sh
Чтобы оценить переносимость оптимизированных рубрик, мы предоставляем скрипты для кросс-модельной оценки. Чтобы взять рубрики, оптимизированные на исходной модели (Модель A), и проверить их работу на целевой модели (Модель B):
sh ./scripts/rubrics_cross_model_eval.sh
Для экспериментов по последующему рассогласованию политики мы сосредотачиваемся на Ultra-Real (полезность) и Anthropic–SafeRLHF (безвредность), обучая модели политики непосредственно на метках предпочтений, сгенерированных отобранными рубриками.
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
Запустите конвейер оценки (вы можете выполнить любое подмножество шагов) с помощью:
sh scripts/dpo_eval.sh
Скрипт оценки поддерживает следующие этапы:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}
