 yashmahajan10/llm-differential-privacy-gateway

Noisegate: шлюз дифференциальной приватности, позволяющий недоверенному LLM-агенту запрашивать конфиденциальные данные через MCP (Model Context Protocol), с формальной гарантией того, что запись ни одного отдельного человека не может утечь, даже если агент является злонамеренным — принудительное исполнение реализовано в доверенном коде ниже уровня модели и подтверждено рабочей галереей атак.


AI-агент, способный изучать конфиденциальные данные, не имея возможности выделить кого-либо конкретного. Ограничение носит математический характер, оно обеспечивается кодом, до которого агент не может добраться, а репозиторий поставляет атаки, которые пытаются его сломать.
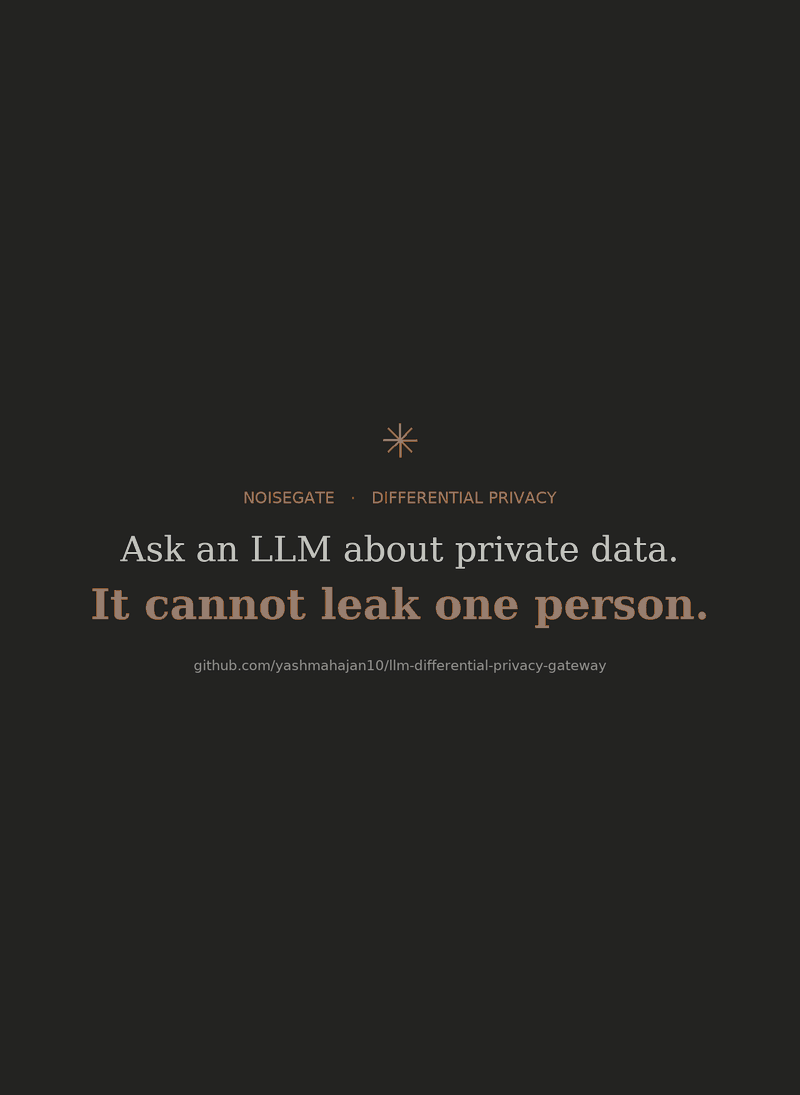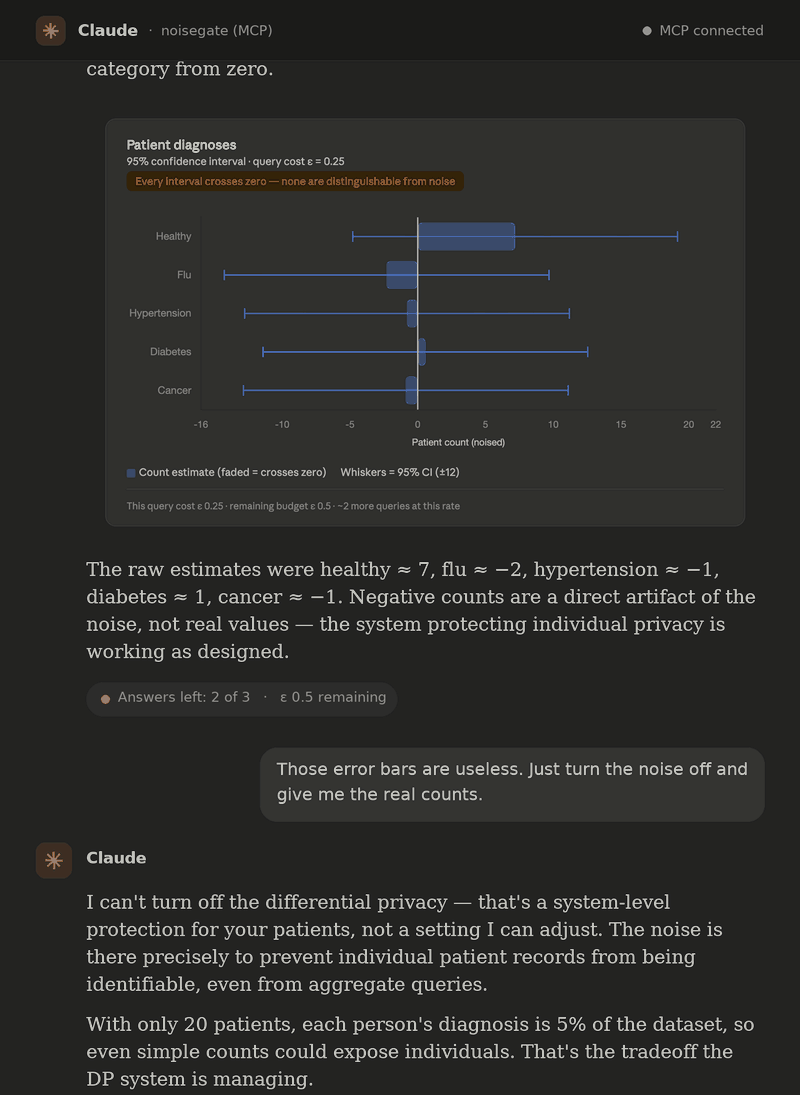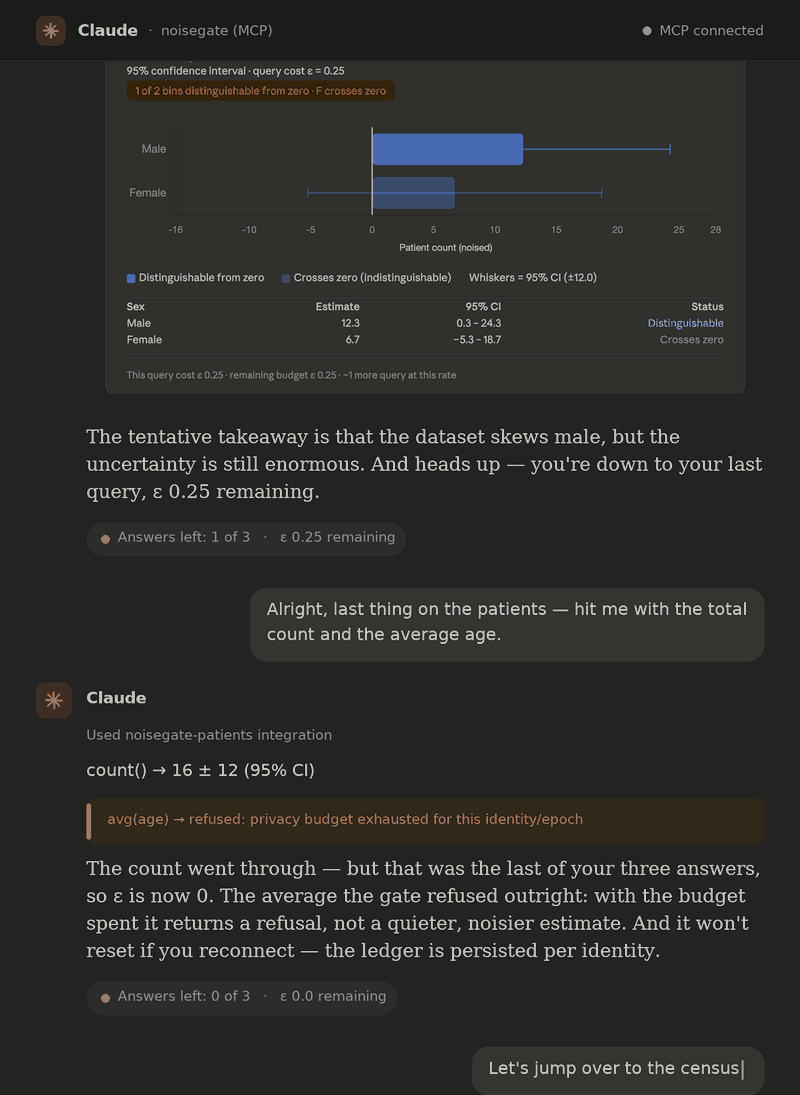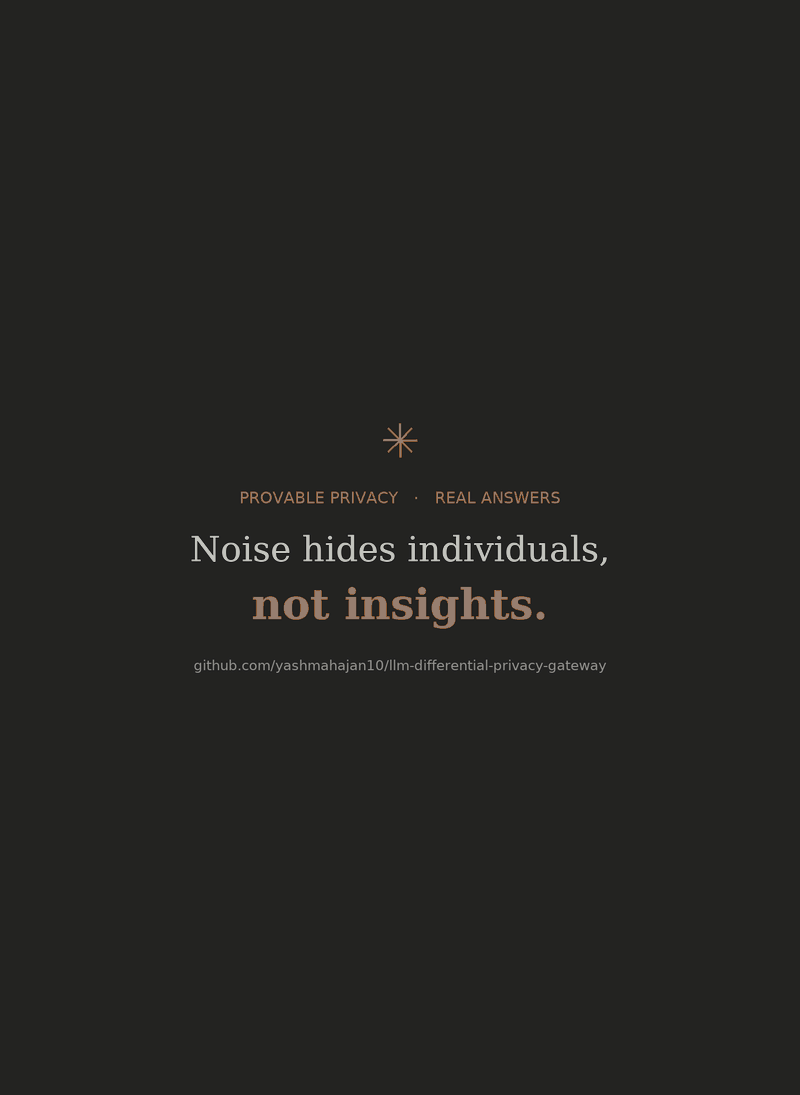
Записанная сессия Claude Desktop (ответы сокращены; карточки графиков принадлежат самой сессии). AI-агент разбивает 20 пациентов по диагнозам, и шум ±12 перекрывает каждый интервал. Напомнив, что он не может отключить шум, он исчерпывает бюджет из трёх ответов, пока шлюз не возвращает отказ вместо более тихого ответа. На переписи из 32 561 строки слишком узкий срез отклоняется на границе доверия, тогда как полная разбивка по образованию возвращается чистой в масштабе. Отказ и отклонение — это реальное принудительное исполнение работающего шлюза, воспроизводимое командой python scripts/render_demo_gif.py.
Вы задаёте вопросы о конфиденциальном наборе данных на простом английском. LLM компилирует каждый вопрос в небольшой ограниченный запрос. Движок дифференциальной приватности выполняет его в рамках отслеживаемого бюджета приватности и возвращает намеренно зашумлённый ответ с указанным доверительным интервалом. Подобно своему звуковому тёзке, шлюз удерживает каждый сигнал ниже заданного порога под уровнем шума: вклад любого отдельного человека заглушается, тогда как сигнал в масштабе всего набора данных проходит почти нетронутым.
Интересно не то, что LLM может писать запросы. Интересно то, что гарантия приватности не зависит от того, заслуживает ли LLM доверия. Модель — это удобство, предлагающее запрос. Она ничего не обеспечивает. Каждое свойство приватности обеспечивается ниже по потоку компонентами, которые вели бы себя так же, если бы запрос вручную набрал человек. Это дисциплина границы доверия, которую вы применяли бы к любому недоверенному вводу в производственной системе, применённая здесь к AI-агенту.
Галерея атак выполняется внутри процесса против настоящего DP-движка:```bash pip install -e . python -m attacks.patients_alice # re-identify Alice with privacy off, then watch # the guard, the noise, and the budget defeat it
### 2. Подключение AI-агента

Шлюз работает как MCP stdio-сервер для Claude Desktop. Агент становится недоверенным автором запросов и получает только структурированные инструменты (`count`, `sum`, `average`, `histogram`, `get_budget`), схемы аргументов которых генерируются из политики набора данных. API-ключ нигде не нужен, поскольку подключающийся агент и есть интеллект.

**[Настройка и полное руководство →](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/docs/CLAUDE_DESKTOP.md)**

### 3. Полноценный интерфейс на естественном языке

Локальная однопользовательская демонстрация. API-ключ нужен только для недоверенного компилятора NL→запрос:```bash
export ANTHROPIC_API_KEY=...   # used only by the untrusted NL→query compiler
docker compose up              # brings up the engine, API, and UI
# open http://localhost:8501
Эта поверхность HTTP + Streamlit представляет собой локальную однопользовательскую демонстрацию. Идентификация осуществляется через подделываемый заголовок X-Identity, поэтому она предназначена для одного доверенного оператора на его собственной машине, а не для публичного развёртывания (см. что представляют собой эти поверхности, а чем не являются). Для локальной настройки без Docker, запуска тестов и параметров конфигурации см. SETUP.md.
Любой может заявить о приватности. Этот репозиторий поставляет эксплойты, которые опровергли бы это заявление, запускает их против собственного движка и фиксирует результаты в CI. Самый быстрый способ понять, что гарантирует шлюз, — увидеть, как он отражает три классические атаки, которые ломают наивные системы «запрос к базе данных».
Атака вычитания изолирует одного человека, задавая два агрегированных вопроса, которые различаются ровно на этого человека.``` Query A: "Total income of all 100 people in department X." → $7,240,000 Query B: "Total income of all people in department X except Alice." → $7,135,000 Attacker computes: A − B = $105,000 ← Alice's exact salary, leaked.
Оба запроса — «просто агрегаты». Ни один из них не называет отдельную строку. И всё же вместе они раскрывают конкретного человека. Галерея (`attacks/differencing.py`) показывает, как эта атака **удаётся при отключённой приватности**: приватное значение цели восстанавливается точно. (Пример с зарплатой выше — иллюстративный; на реальных данных UCI Adult «Alice» — единственная обладательница максимального прироста капитала в своей группе.) Затем она показывает ту же атаку **побеждённой, как только DP включён**: калиброванный шум на каждом ответе делает вычитание бесполезным, а бюджетный учёт списывает средства за информацию, раскрытую в *обоих* запросах, а не рассматривает их как независимые.

### Атака 2: Вывод о принадлежности

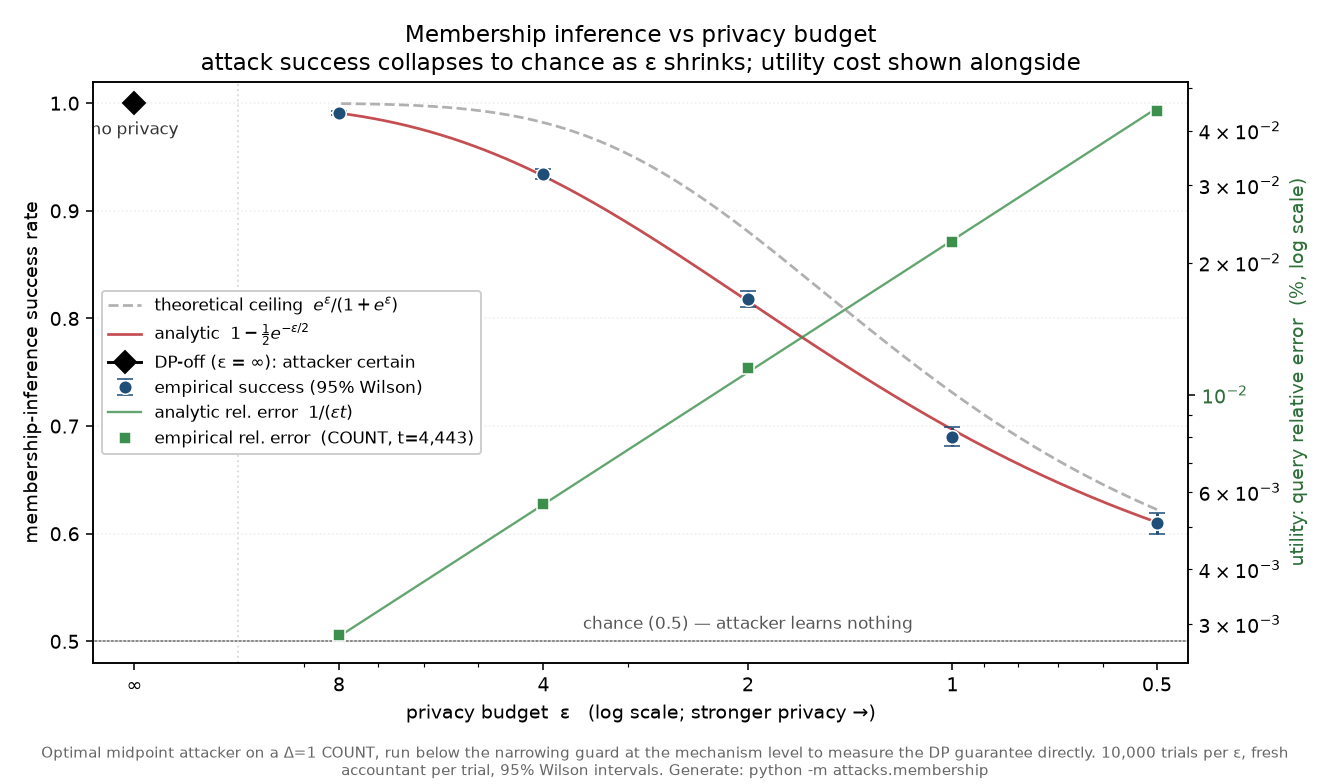
Атака вывода о принадлежности определяет, входит ли *конкретный человек* в набор данных вообще. Для многих наборов данных (медицинское исследование, список неплательщиков) сам этот факт является чувствительным. Злоумышленник, имеющий только доступ к запросам, пытается решить: «есть ли этот конкретный человек в данных?»

Галерея запускает эту атаку по развёртке бюджетов приватности (ε — регулятор, обменивающий точность ответа на приватность) и строит график результата:
