 vincentkaufmann/noapi-google-search-mcp
MCP сервер для поиска Google и получения страниц с использованием headless Chromium

Если вы хотите поддержать noapi-google-mcp или gpt-oss-20B/120B-Vision и другие модели с открытым исходным кодом, находящиеся в разработке, пожалуйста, внесите вклад в мой фонд GPU-вычислений: требуется около $3000.
Если вы нашли это полезным, подумайте о поддержке дальнейшей разработки и новых функций.
BTC:16DT4AHemLyn7C6P116YepjY518gu9wUUH
ETH:
0x7287D1F9c77832cFF246937af0443622bFdACD04
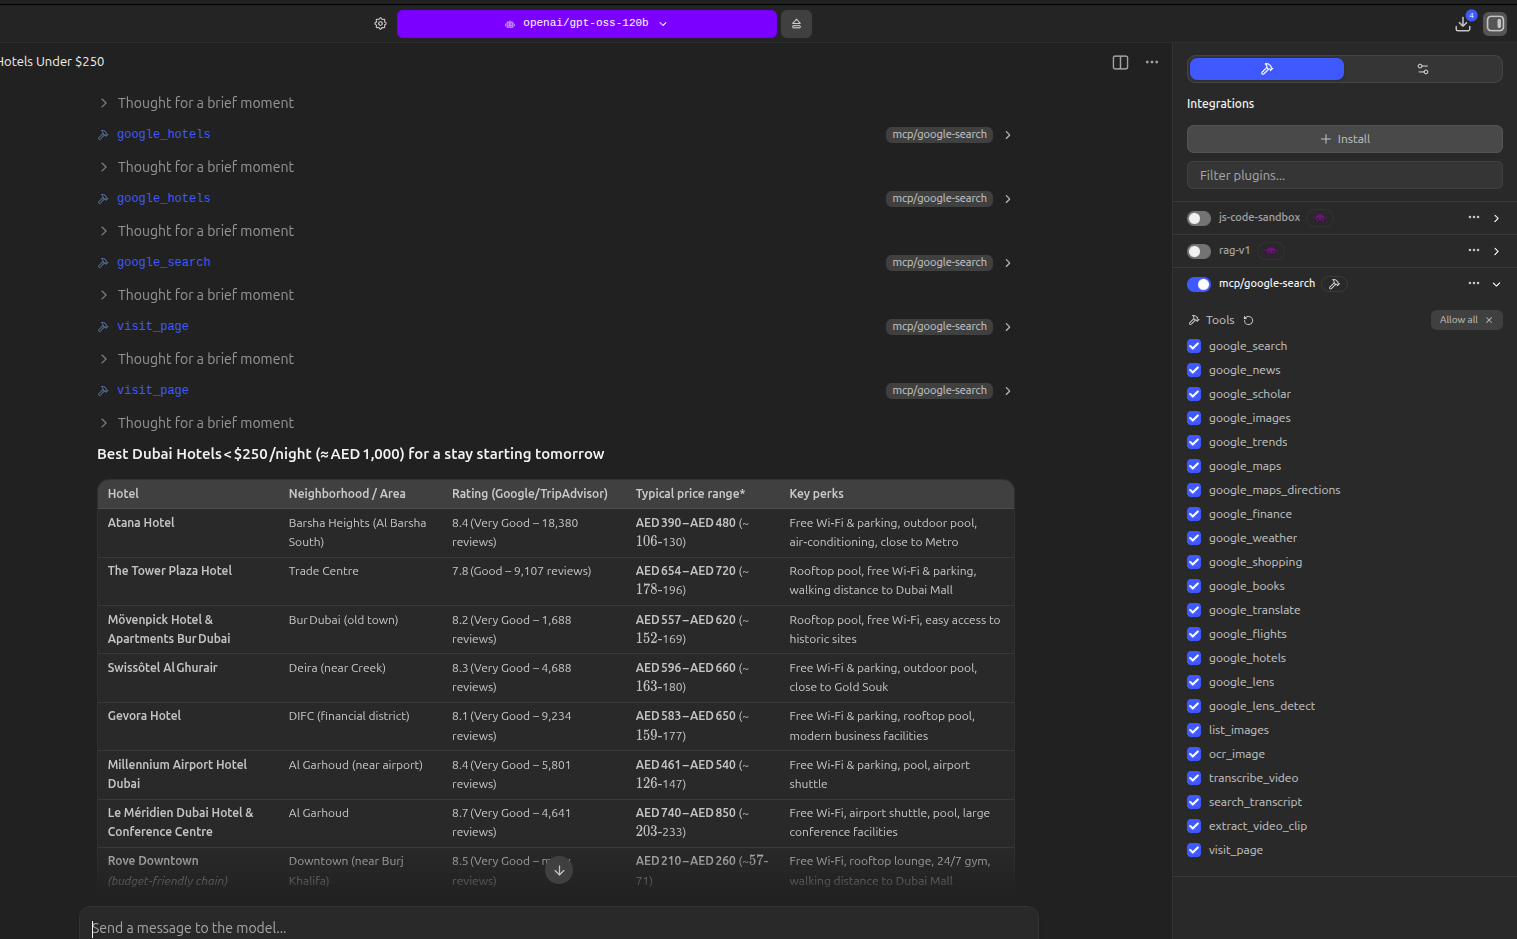
38 инструментов. Ноль ключей API. Дайте любой локальной LLM реальный поиск Google, новостные ленты, зрение, OCR и полное понимание видео.
MCP-сервер, который превращает вашу локальную LLM в полностью подключенного помощника. Реальные результаты Google, новостные и социальные ленты, обратный поиск изображений, автономный OCR, транскрипция YouTube и извлечение клипов — все работает локально через headless Chromium и модели машинного обучения с открытым исходным кодом. Никаких ключей API, никаких ограничений на использование, никакой зависимости от облака.
Работает с LM Studio, Claude Desktop, OpenClaw, Ollama и любым MCP-совместимым клиентом.
Google начал ловить headless Chromium-браузеры и показывать CAPTCHA вместо результатов поиска (#2). Мы исправили это должным образом, а затем добавили нейросетевой решатель CAPTCHA просто ради интереса.
Стелс-патчи:
navigator.webdriver, поддельные плагины браузера, chrome.runtime и удаляет отпечатки Playwrightaarch64, теперь соответствует реальному бинарнику Chromium)Нейросетевой решатель CAPTCHA (MobileNetV2 + OpenCV):
Решит ли он каждую CAPTCHA? Нет. Но он пройдет через некоторые из них, и, честно говоря, мы создали его просто потому, что могли.
Полный локальный RAG-конвейер для YouTube. Подпишитесь на любой канал, и когда вы проверяете ленту, сервер автоматически загружает аудио, транскрибирует его с помощью Whisper и сохраняет полную транскрипцию в SQLite с полнотекстовым поиском FTS5. Каждое слово из каждого видео становится доступным для поиска — задайте вопрос вашему LLM, и он извлечет ответ из нужного видео.
Нашли что-то интересное? Попросите LLM извлечь этот сегмент как клип. Он читает транскрипцию, находит точные временные метки и вырезает видео для вас. Это начало редактирования видео на базе AI/LLM — ваша LLM понимает содержимое и вырезает клипы на основе того, что говорится, а не только меток времени.
Как это работает:
subscribe на канал YouTube — по хендлу (@3Blue1Brown), URL или ID каналаcheck_feeds — новые видео загружаются и автоматически транскрибируются локально с помощью faster-whisper. Транскрипции записываются в базу данных для мгновенного поиска. До 5 видео за проверку, кэшируются, чтобы ничего не загружалось повторно.search_feeds — полнотекстовый поиск по всем транскрипциям. Поддерживает AND, OR, NOT и выражения в кавычках. Ваш LLM находит точное видео и отрывок, отвечающий на ваш вопрос.extract_video_clip — скажите LLM, что вас интересует, и он вырежет клип из видео. LLM использует транскрипцию, чтобы найти нужный сегмент, и извлекает его автоматически.```
"Subscribe to @AndrejKarpathy on YouTube"
"Check my feeds"
"Search my feeds for backpropagation explained"
"What did Karpathy say about tokenization?"
"Extract the part where he explains gradient descent"
"Cut a clip of the hardware comparison section"Никаких эмбеддингов, никакой векторной базы данных, никакого API — только Whisper + SQLite FTS5, работающие на вашем компьютере.
> **Дорожная карта:** Извлечение клипов — это первый шаг к полноценному видеомонтажу на основе ИИ. Будущие версии добавят наложение музыки/аудио, ремикширование видео, компиляцию нескольких клипов, вертикальное переформатирование для TikTok/Reels/Shorts и автоматические подборки лучших моментов — всё на основе понимания контента вашей LLM.
---
### Подписки на ленты в реальном времени
Подписывайтесь на новости, Reddit, Hacker News, каналы YouTube, профили Twitter/X, репозитории GitHub, статьи arXiv и подкасты. Контент загружается, хранится локально в SQLite с полнотекстовым поиском и мгновенно доступен вашей LLM.
| Новый инструмент | Что делает |
|----------|-------------|
| `subscribe` | Добавить любой источник — новостные RSS, Reddit, HN, GitHub, arXiv, YouTube, подкасты, Twitter/X |
| `unsubscribe` | Удалить подписку и сохранённый контент |
| `list_subscriptions` | Просмотреть все активные ленты с количеством элементов |
| `check_feeds` | Опрашивать все подписки, получать новый контент, автоматически транскрибировать видео YouTube |
| `search_feeds` | Полнотекстовый поиск по всему, что собрали ваши ленты |
| `get_feed_items` | Просмотр недавних элементов с фильтрацией по источнику или типу |
**Предварительно настроенные новостные источники** — подписка одним словом: `bbc`, `cnn`, `nyt`, `guardian`, `npr`, `aljazeera`, `techcrunch`, `ars`, `verge`, `wired`, `reuters`
**Ярлыки arXiv** — `ai`, `ml`, `cv`, `nlp`, `robotics`, `crypto`, `systems`, `hci````
"Subscribe to BBC News, r/LocalLLaMA, and Hacker News"
"Follow @elonmusk on Twitter"
"Subscribe to the YouTube channel @3Blue1Brown"
"Watch anthropics/claude-code on GitHub for new releases"
"Subscribe to the machine learning arXiv category"
"Check my feeds"
"Search my feeds for transformer architecture"
"What's new in my Reddit feeds?"
Расшифровывайте встречи, конвертируйте форматы, читайте документы — всё локально, без облака.
| Новый инструмент | Что делает |
|---|---|
transcribe_local | Расшифровывает любой локальный аудио- или видеофайл с помощью Whisper (mp3, wav, mp4, mkv и т.д.) |
convert_media | Конвертация форматов с помощью FFmpeg — видео в аудио, формат в формат, видео в GIF |
read_document | Извлекает текст из PDF, DOCX, HTML, CSV, JSON и более 30 текстовых форматов |
Получайте письма, генерируйте QR-коды, сокращайте URL, архивируйте страницы, ищите в Википедии, загружайте в S3.
