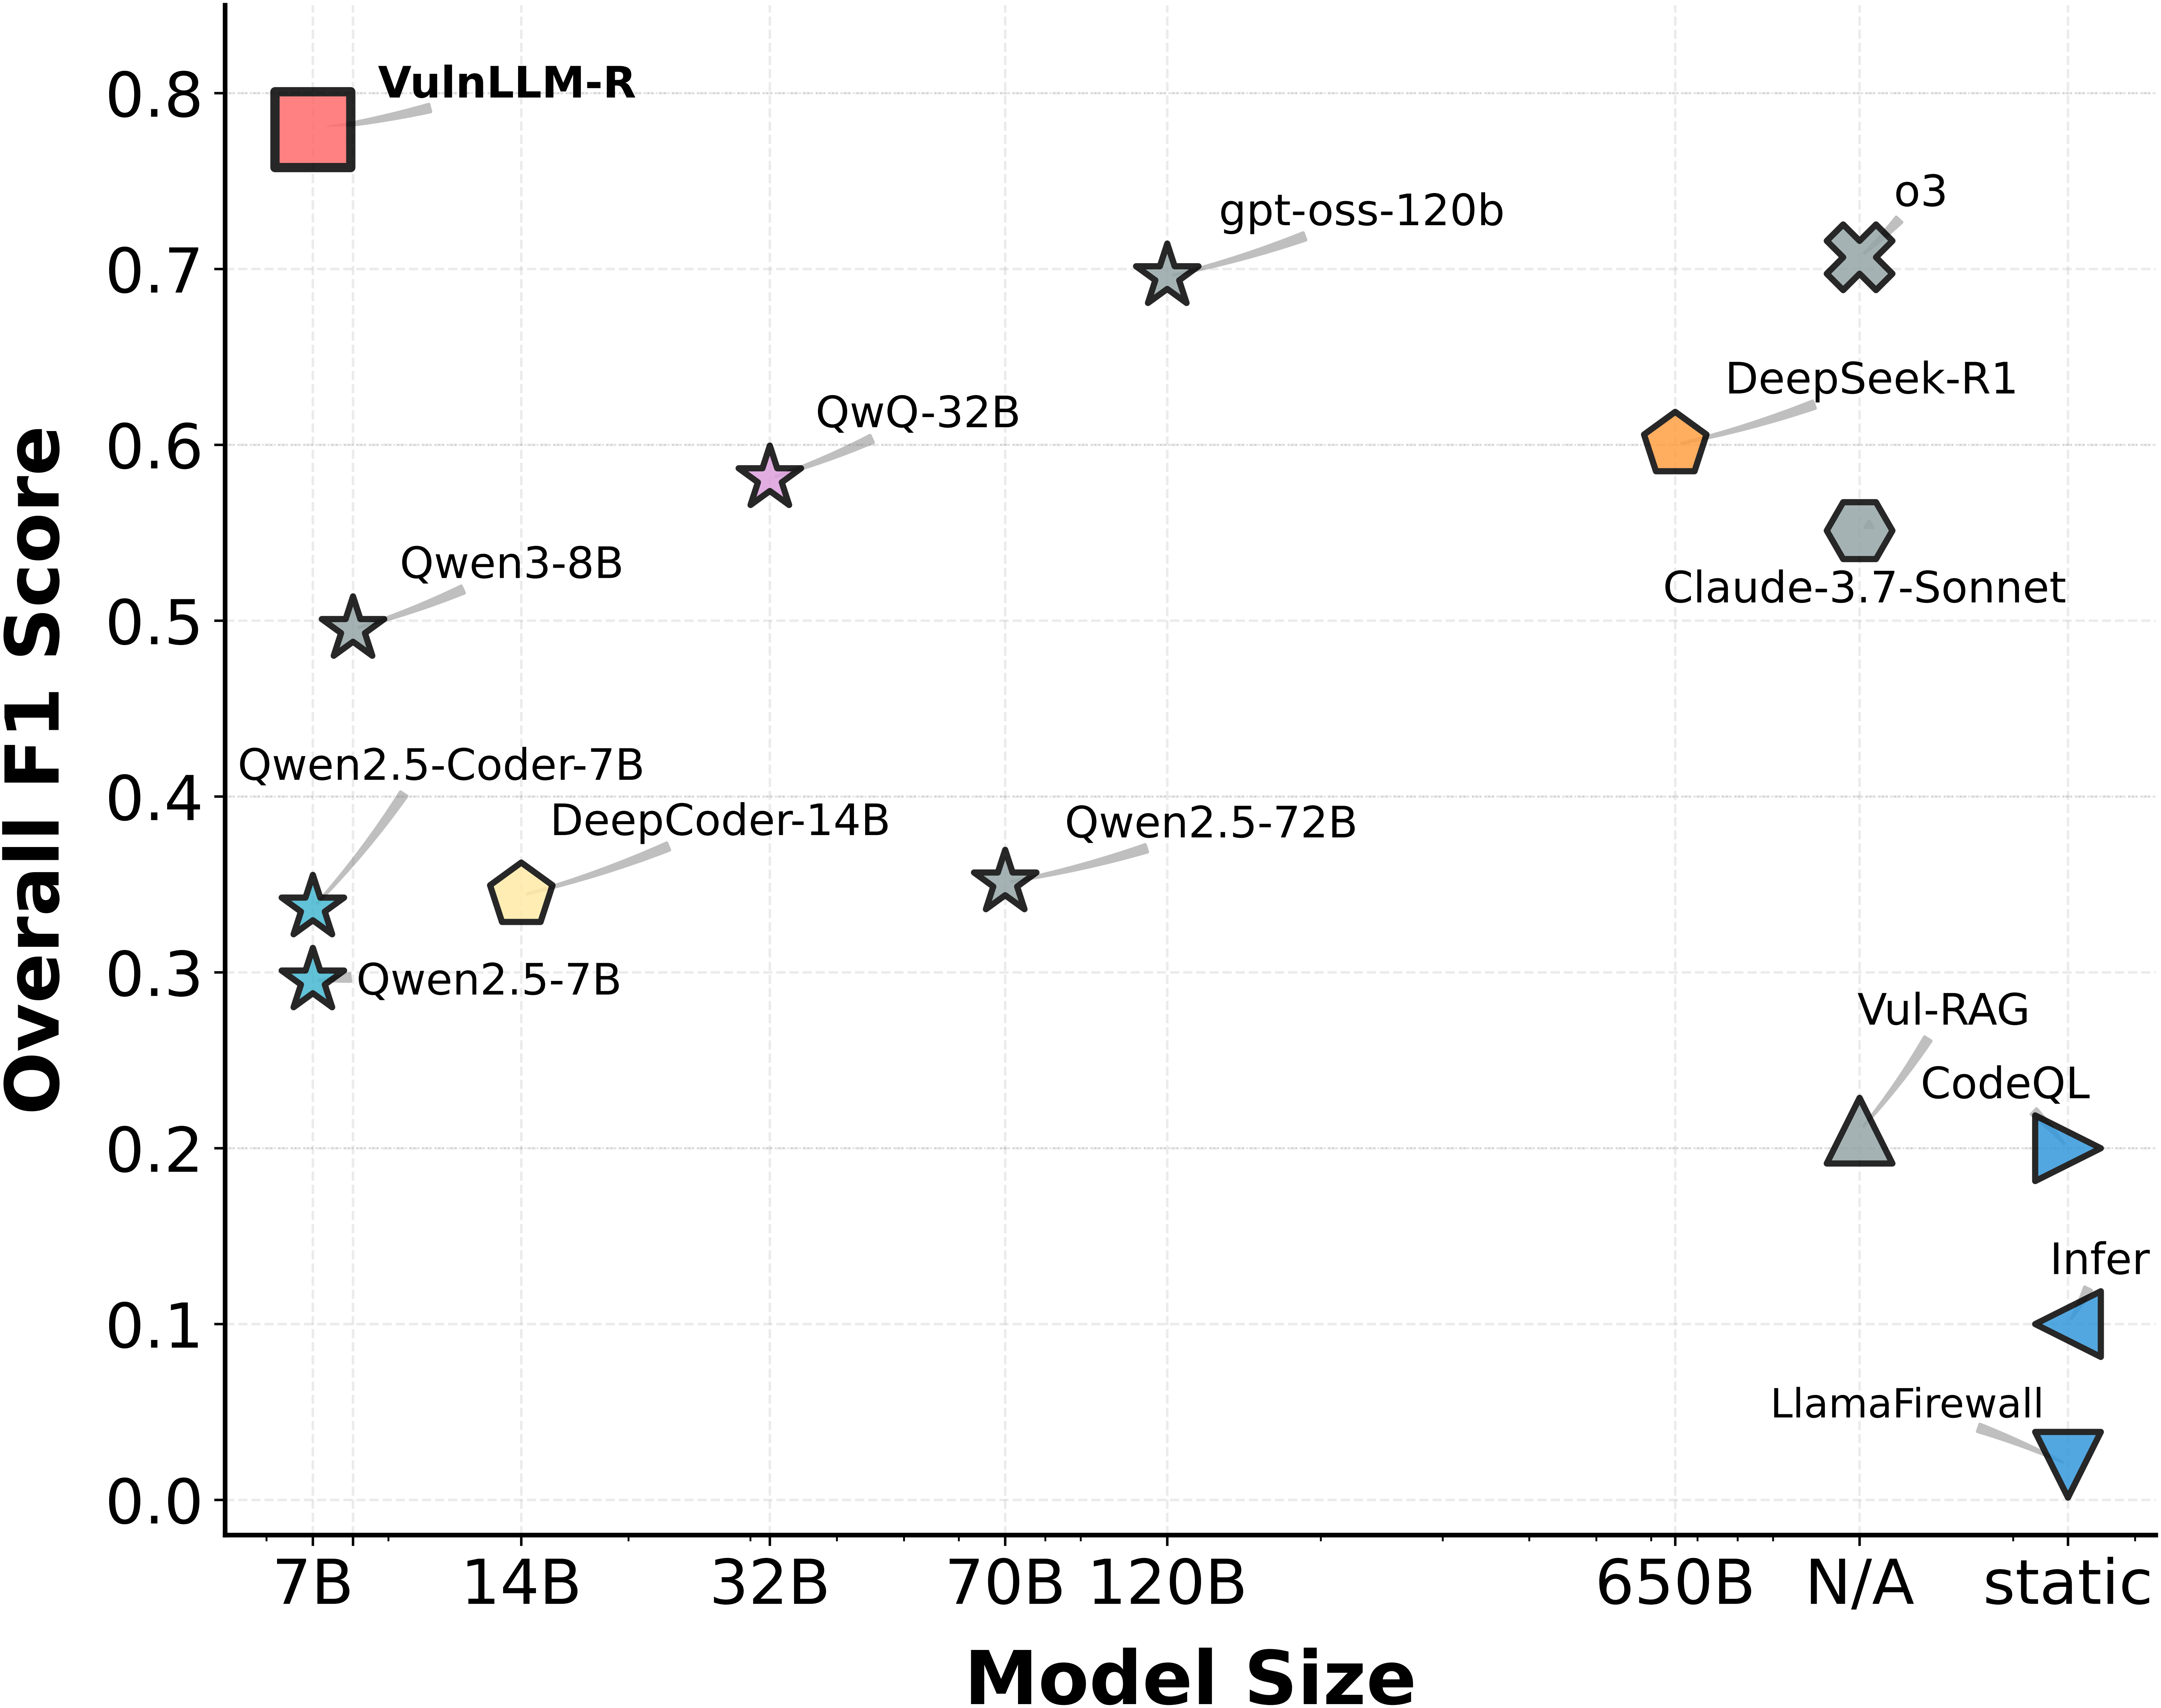
 ucsb-mlsec/vulnllm-r
Специализированная LLM для рассуждений, предназначенная для обнаружения уязвимостей в исходном коде на C/C++ и Python, с построением датасетов, обучением SFT/DPO и скриптами для воспроизведения результатов.

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
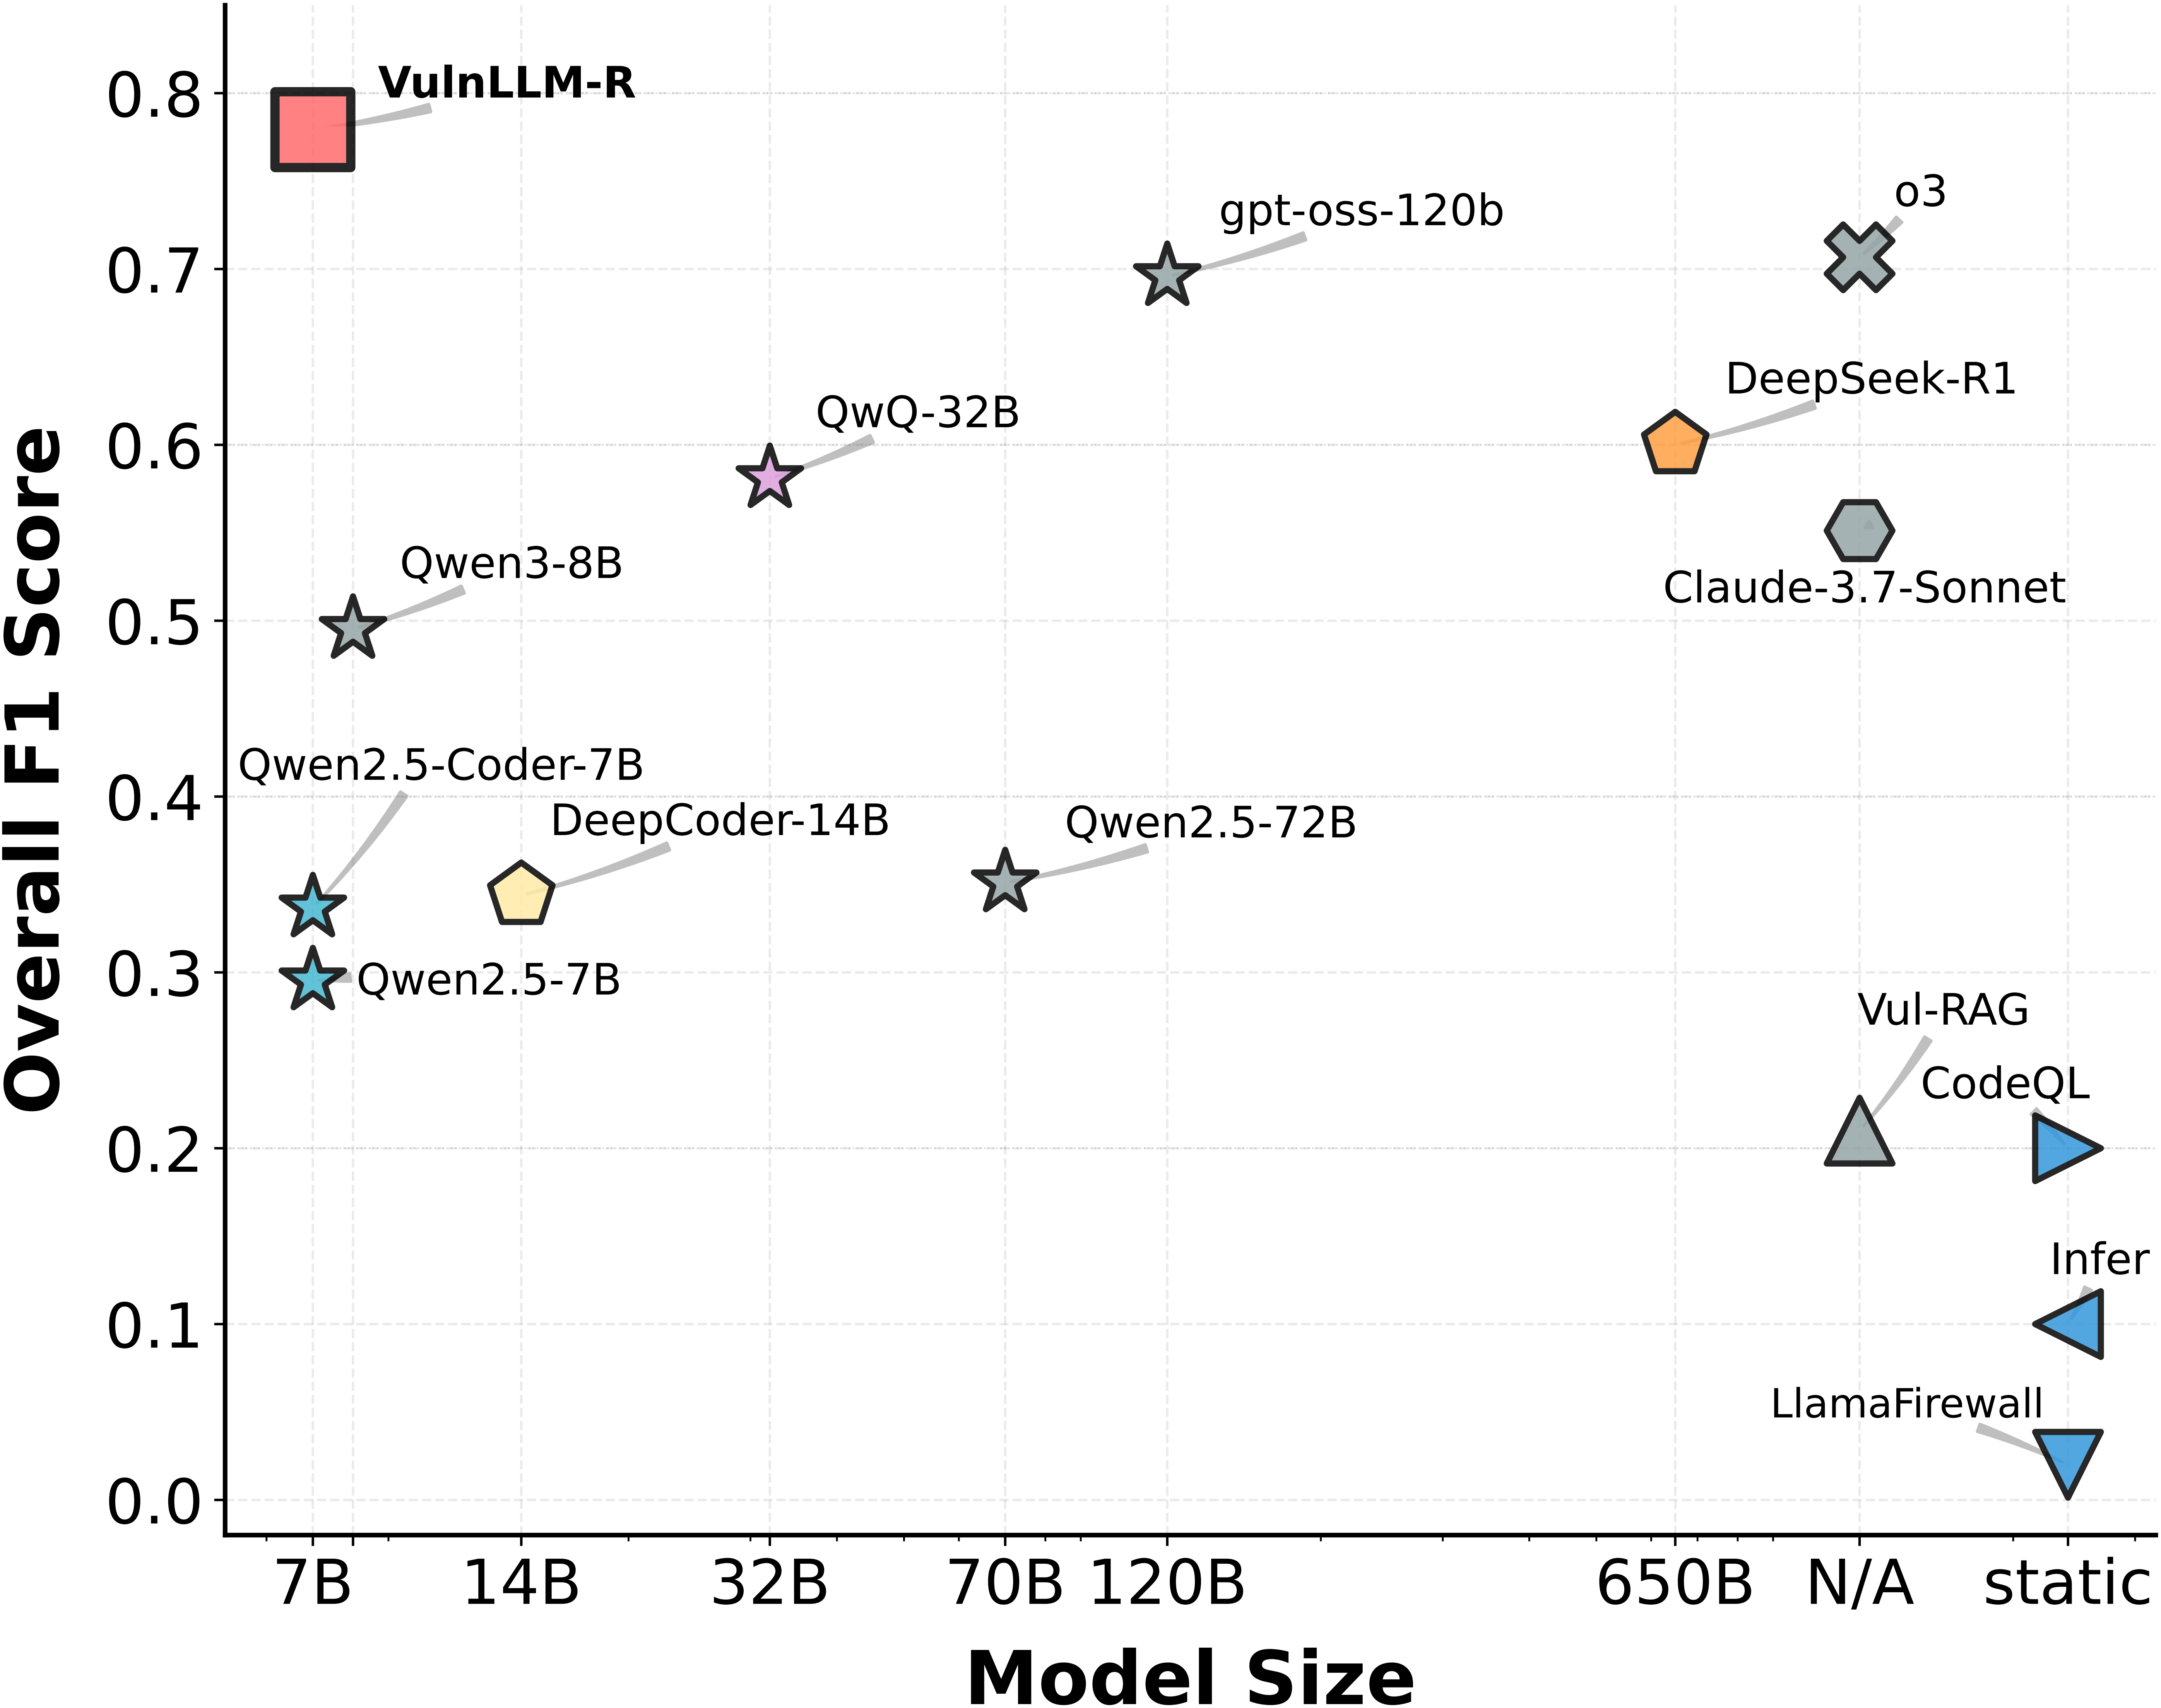
python plots/plot_language_comparison_models.py --results-dir results/test_data
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
Мы также предоставляем сокращённую версию рассуждений дистиллированных наборов данных:
Объединяем существующие наборы данных обнаружения уязвимостей на уровне функций: PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4], и Arvo [5]. Среди этих наборов данных PrimeVul содержит самые сложные функции. Мы создаём два обучающих набора: чистый (без PrimeVul) и шумный (с PrimeVul), чтобы можно было обучаться на относительно простых наборах и тестироваться на сложном наборе PrimeVul. Обратите внимание, что мы называем обучающий набор с PrimeVul "шумным" не потому, что данные зашумлены. Это относительно произвольное название, которое мы использовали изначально.
vulscan/data_process/data_utils есть набор скриптов для обработки и объединения
наборов.
raw_to_us.py: Объединение исходных данных в наш набор данных и удаление избыточных данныхcheck_cwe_correct.py: Вычисление точности для каждой категории CWEgenerate_arvo_raw_data.py: Генерация структурированных исходных данных из набора данных arvoarvo_to_us.py: Переформатирование структурированных исходных данных arvo в формат нашего набора данныхsplit_good_bad_for_juliet.py: Извлечение данных из исходного набора Juliet 1.3 и преобразование их в требуемый
формат, что составляет часть нашего набора c clean_datasetadd_sven_to_clean_dataset.py: Извлечение данных из набора Sven, формирующих часть нашего набора C clean_datasetsync_large_small.py: Синхронизация изменений noisy_dataset/large_train/c с
noisy_dataset/small_train/cremove_testing_from_training.py: Добавление тега human к каждому элементу данных, означающего, что точка проверена
человеком и используется как тестовые данные
-data_utils.py: Добавление поля related_cwe в набор данных.datasets/clean_dataset: обучающие данные без PrimeVul
datasets/clean_dataset/python содержит данные из SVEN и SecCodePLTdatasets/clean_dataset/c содержит данные из Juliet и SVENdatasets/noisy_dataset
datasets/noisy_dataset/small_train: Содержит обучающие данные из PrimeVul и SVEN с выбранными CWE (
мы используем данные PrimeVul в этом наборе для обучения)datasets/noisy_dataset/large_train: Содержит обучающие данные из PrimeVul, SVEN и SecCodePLT с
большим количеством CWE (этот набор может быть использован позже для обучения более крупных моделей)datasets/noisy_dataset/test: Небольшой тестовый набор из PrimeVul, проверенный человекомdatasets/test
datasets/test/test_clean: Тестовые данные из SVEN, SecCodePLT и Juliet; с OOD CWE, которые не
входят в обучающий наборdatasets/test/test_primevul_pair: исходные тестовые данные PrimeVulvulscan/data_process/data_utils/get_cwe_stat.py для получения гистограммы набора данных| Набор данных | Язык | Обучение/Тест | CWE | # Безопасных | # Уязвимых | Средняя длина |
|---|---|---|---|---|---|---|
| Clean (seccodeplt) | Python | Обучение | 20 | 1281 | 1281 | 741 |
| Clean (juliet) | C/C++ | Обучение | 22 | 1716 | 1653 | 3689 |
| Hard (primevul filtered) | C/C++ | Обучение | 26 | 2717 | 2952 | 4689 |
| Long Context (Oss-fuzz) | C/C++ | Обучение | 3 | 475 | 604 | 12761 |
| Simple (seccodeplt) | Python | Тест | 24 (6 ood) | 74 | 74 | 814 |
| Simple (juliet) | C/C++ | Тест | 38 (14 ood) | 358 | 376 | 2575 |
| Hard (PrimeVul, SecLLMHolmes) | C/C++ | Тест | 13 (5 ood) | 145 | 152 | 4545 |
| Long Context (Oss-fuzz) | C/C++ | Тест | 3 (0 ood) | 0 | 320 | 18929 |
| primevul test (noisy) | C/C++ | Тест | 56 (34 ood) | 421 | 422 | 5341 |
