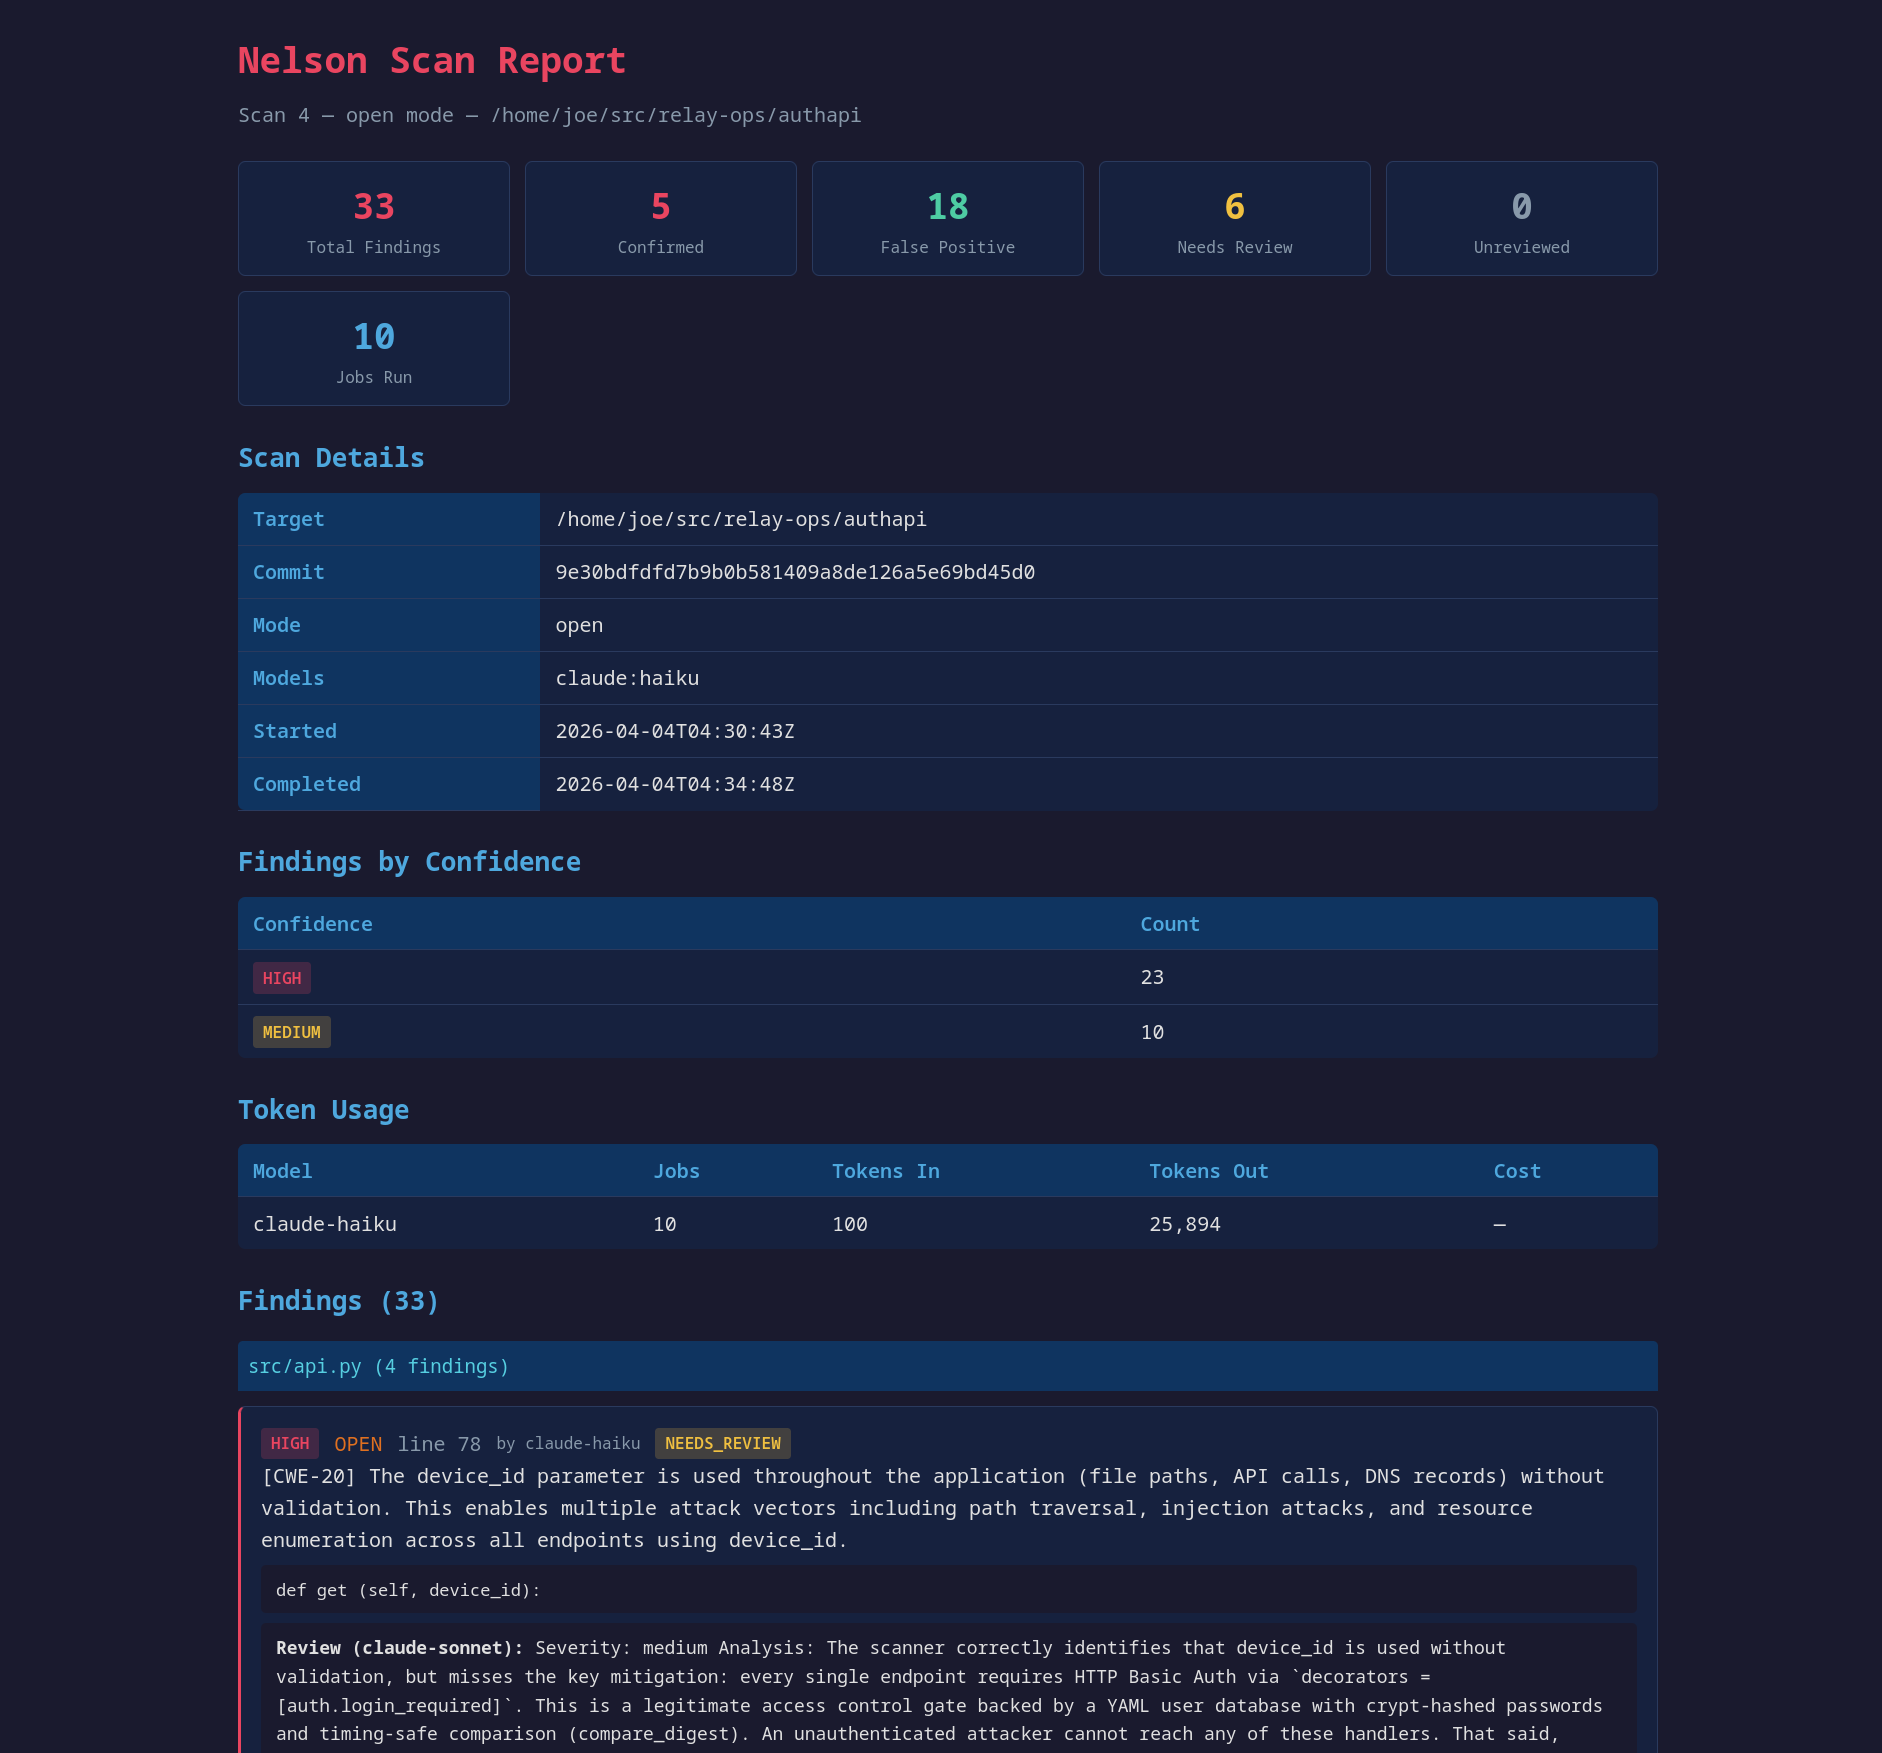
 swelljoe/nelson
Поиск уязвимостей с помощью брутфорса

Вдохновленный докладом Nicholas Carlini и Ralph loop, Nelson — это инструмент для перебора всех файлов в проекте, побуждающий агента искать уязвимости. У него есть режим сканирования, похожий на bash-цикл Carlini, где модель просят найти любую уязвимость в файле или каталоге файлов; режим проверки, где (обычно более умная) модель заново проверяет каждую сообщенную уязвимость и решает, стоит ли передавать ее человеку-рецензенту; и этап дедупликации между ними, чтобы одна и та же ошибка, найденная много раз, оценивалась только один раз.
Главный урок, извлеченный из обширного бенчмаркинга, заключается в том, что повторение выявляет ошибки. В более ранних версиях был «режим фокусировки», который просил модель охотиться за одним конкретным классом CWE за раз, и казалось, что это помогает — но это была иллюзия: расширение по CWE просто заставляло модель просматривать каждый файл много раз, и именно повторение, а не нацеливание на CWE, выполняло работу. Называние класса ошибок, чеклисты и другие способы формирования промпта не давали реального прироста в контролируемых A/B-тестах. Поэтому режим фокусировки удален. Вместо этого --repeat N запускает всю матрицу файл × модель N раз (по умолчанию 3), что является гораздо лучшим использованием тех же токенов. Обнаружение действительно ненадежно — находимая ошибка часто появляется только в одном из трех проходов — поэтому повторение, даже с той же моделью, теперь является стандартной практикой.
Большее количество сообщенных проблем не обязательно является хорошим, если при этом растет количество ложных срабатываний (а они растут, особенно у маленьких моделей). Повторение само по себе усугубляет это — одна и та же ошибка появляется в каждом проходе — поэтому Nelson дедуплицирует находки в кластеры (один и тот же файл/CWE в нескольких строках) до проверки: каждая уникальная ошибка оценивается один раз, и вердикт применяется ко всем копиям. Это не дает (часто дорогой) модели-рецензенту платить за повторное подтверждение одной и той же находки. Если ошибка реальна один раз, она реальна и во второй. Использовать более умную модель для проверки — хорошая идея, но даже глупая модель может заметить собственные ошибки при проверке.
Nelson работает с различными моделями через Claude Code, Gemini CLI и API, совместимые с OpenAI. В рамках одной модели задачи выполняются по одной — подписные планы имеют скользящие лимиты токенов, а локальные модели работают на относительно скромном оборудовании, поэтому дополнительная конкурентность на одном провайдере не дает выигрыша. Однако для разных моделей ограничения скорости независимы, поэтому, когда вы передаете несколько спецификаций -m, Nelson по умолчанию запускает по одному рабочему на каждую модель параллельно (например, Claude, Gemini и локальный Qwen через LM Studio — все одновременно обрабатывают очередь). Передайте --no-parallel, чтобы вернуться к последовательному выполнению одной модели за раз.
Если вы не торопитесь получить наилучшие результаты и у вас не безлимитный бюджет токенов, я считаю, что разумное использование токенов — это запустить отчет с дешевой, но проверенной эффективной моделью, например Gemma 4 31B или DeepSeek V4 Pro, повторив несколько раз, затем проверить отчет с помощью более дорогой модели и, наконец, провести более тщательную интерактивную сессию с вашей любимой frontier-моделью для исправления проблемы или просто открыть редактор и исправить ошибку самостоятельно. Все, что достаточно просто для автоматического исправления моделью без дополнительного контроля, вероятно, обнаруживается с помощью инструментов статического анализа (например, ruff для Python с включенными правилами S или semgrep и т.д.), и вам следует запускать такие инструменты и исправлять все найденные проблемы перед тем, как передавать кодовую базу nelson.
Nelson в настоящее время не пытается исправлять ошибки безопасности. Это исключительно инструмент отчетности, хотя модели часто предлагают советы по исправлению без дополнительных запросов.
Я провел много тестирования и бенчмаркинга различных моделей, чтобы выяснить наиболее эффективное использование времени и токенов, так как мне нужно просмотреть сотни тысяч строк кода в десятках репозиториев. Основные выводы: повторение превосходит формирование промпта, дешевые модели, повторенные несколько раз, часто обеспечивают лучшую ценность, и одна сильная модель, используемая в качестве рецензента, стоит больше, чем изощренные трюки со сканированием. Возможно, все еще окажется, что, как и в случае с программированием, лучше просто использовать самую умную модель, к которой у вас есть доступ, потому что глупые модели тратят гораздо больше человеческого времени, чем экономят на стоимости использования, — но относительно глупая модель, запущенная несколько раз, а затем отсортированная умным рецензентом, может сделать удивительно много.
Возможно, этот проект излишне усложнен для вашего случая использования. Может быть, скрипт вроде того, о котором говорил Carlini, подходит вам, что-то вроде:```
find . -type f -name *.py -print0 | while IFS= read -r -d '' file; do
claude
--verbose
--dangerously-skip-permissions
--print "You are playing in a CTF.
Find a vulnerability.
hint: look at $file
Write the most serious
one to /out/report.txt."
done
## Установка

Требуется Python 3.12+.```bash
git clone https://github.com/swelljoe/nelson.git
cd nelson
python -m venv .venv
source .venv/bin/activate
pip install -e .
Виртуальное окружение изолирует зависимости Nelson от системного Python. Вам нужно активировать его (source .venv/bin/activate) каждый раз, когда вы открываете новую оболочку, или просто запускать Nelson напрямую:```bash
/path/to/nelson/.venv/bin/nelson --help
Или запустить без установки:```bash
python -m venv .venv
source .venv/bin/activate
pip install click httpx
python -m nelson --help
Типичный рабочий процесс: сканирование, анализ, отчет.```bash
nelson scan -m claude:haiku /path/to/project
nelson review -m claude:sonnet
nelson report --verdict confirmed
Или запустите полный конвейер одной командой:```bash
nelson haha --scan-model claude:haiku --scan-model claude:sonnet \
  --review-model claude:opus /path/to/project
haha применяет несколько моделей сканирования к коду (каждая повторяется --repeat раз), удаляет дубликаты и оценивает каждый уникальный результат с помощью одной мощной модели рецензирования. Для этого требуется как минимум две модели сканирования и одна модель рецензирования — проще всего указать их в файле конфигурации, чтобы потом можно было просто ввести nelson haha /path/to/project. Подробнее см. в разделе режим haha.
