 suraj-ranganath/stealthrl
StealthRL: фреймворк RL для состязательного перефразирования текста ИИ, предназначенный для стресс-тестирования устойчивости детекторов.

Статья (arXiv)
Демо
Модель (Hugging Face)
Бенчмарк-датасет (Hugging Face)
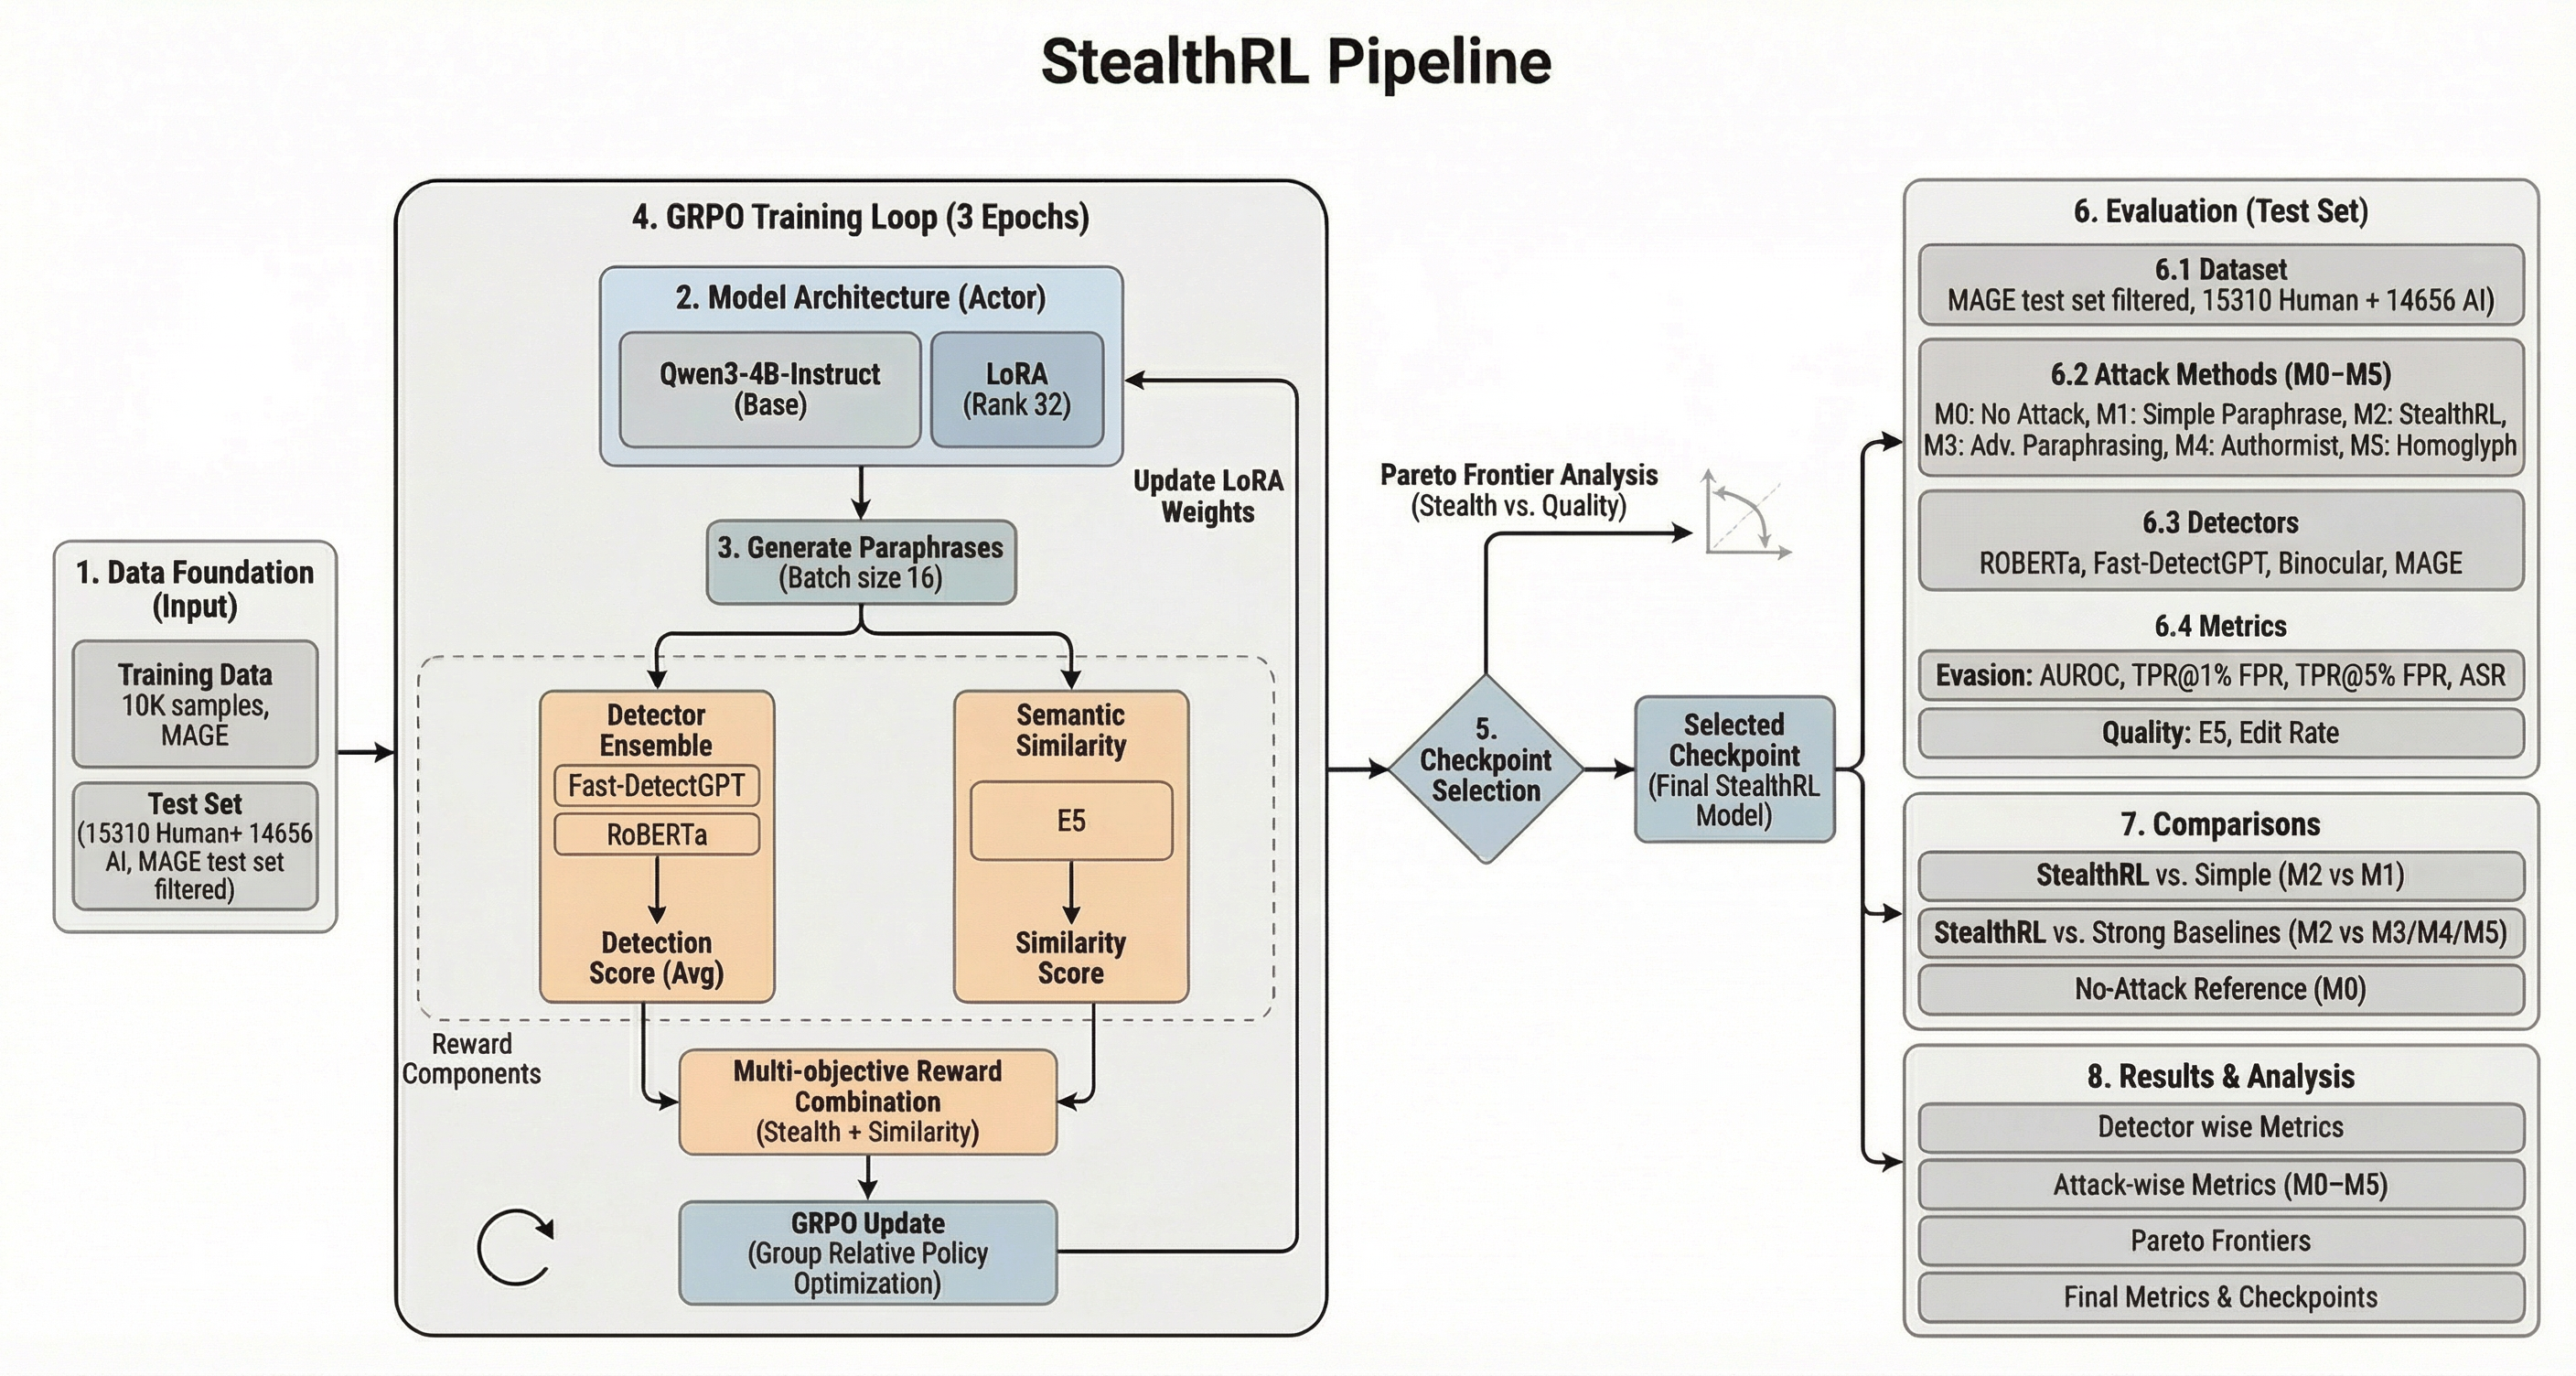
Детекторы ИИ-текста всё чаще используются в задачах с высокими ставками, однако их устойчивость к сохраняющему смысл состязательному переписыванию остаётся неопределённой. Мы представляем StealthRL — фреймворк на основе обучения с подкреплением для стресс-тестирования детекторов ИИ-текста с помощью адаптивных атак перефразированием. StealthRL обучает политику перефразирования против ансамбля детекторов, сохраняя семантическое содержание, а затем оценивает перенос на семейства детекторов, не использовавшиеся при обучении. На полном отфильтрованном тестовом пуле MAGE (15,310 человеческих / 14,656 ИИ-образцов) StealthRL снижает средний AUROC с 0.79 до 0.43 и достигает среднего TPR@1%FPR 0.024 на RoBERTa, Fast-DetectGPT, Binoculars и MAGE. Атака переносится на два детектора, не использовавшихся при обучении, выявляя общие уязвимости, а не отказ отдельного детектора. Мы также анализируем распределения оценок детекторов и оцениваем качество с помощью E5, BERTScore и Likert-оценок на основе LLM. Наши результаты показывают, что современные детекторы ИИ-текста остаются хрупкими под давлением реалистичного перефразирования, и предоставляют воспроизводимый протокол для оценки состязательной устойчивости.
Этот репозиторий — исследовательская и инженерная кодовая база, лежащая в основе StealthRL. Он содержит:
Репозиторий задуман как удобная отправная точка для исследователей, которые хотят:
stealthrl/: код обучения, обёртки детекторов, функции вознаграждения, утилиты для работы с данными и оригинальный пакет StealthBencheval/: исследовательский харнесс для оценки, использованный для результатов статьиscripts/: исполняемые точки входа для обучения, оценки, оркестрации, построения графиков и утилитconfigs/: YAML-конфиги для обучения, оценки и абляцийfigures/: диаграммы конвейера и статические ресурсыtests/: интеграционные проверки и sanity-тестыanalysis/: ad hoc вспомогательные инструменты анализа и разовые утилитыpython -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
В зависимости от того, какие части проекта вы хотите запускать, вам также могут понадобиться:
pip install tinker
pip install openai
pip install vllm
Примечания:
tinker требуется для облачного пути инференса чекпоинта StealthRL, используемого методом M2.openai требуется только для этапа оценки качества GPT/Likert.vllm рекомендуется для быстрой локальной генерации в базовых методах статьи.Типичные переменные окружения, используемые репозиторием:
export HF_HOME=$HOME/.cache/huggingface
export TRANSFORMERS_CACHE=$HF_HOME
export OPENAI_API_KEY=...
export TINKER_API_KEY=...
Для поэтапного конвейера оценки из статьи мы использовали env-файл и JSON-файл описания чекпоинта. Публичные скрипты позволяют явно переопределить оба пути:
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_eval.py --quick
python scripts/run_stealthbench.py --config configs/stealthbench.yaml
Теперь он загружает настроенные текстовые файлы, запускает настроенные детекторы, сохраняет CSV-выводы и генерирует сравнительные графики. Старая заглушка, содержавшая только TODO, удалена.
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_public \
  --gpus 0 1 2 3
Репозиторий включает демонстрационный сайт на FastAPI в каталоге demo/. Он обслуживает аккуратный статический интерфейс и предоставляет эндпоинт POST /api/paraphrase с поддержкой API-ключей, а также публичную квоту 20 запросов в день для неаутентифицированных пользователей.
pip install -r demo/requirements.txt
uvicorn demo.stealthrl_demo.app:app --reload --port 8080
По умолчанию демо запускается в бесплатном режиме mock для тестирования интерфейса. Чтобы использовать реальный сэмплер StealthRL, задайте STEALTHRL_DEMO_INFERENCE_BACKEND=tinker, STEALTHRL_DEMO_CHECKPOINT_JSON и TINKER_API_KEY. См. demo/README.md с примечаниями по API-ключам, квотам, развёртыванию в Docker и AWS.
В статье представлены результаты на полном отфильтрованном оценочном пуле MAGE:
Исследовательский конвейер оценки реализован в модуле eval/ и поэтапных скриптах в каталоге scripts/.
Подготовьте учётные данные и метаданные чекпоинта.
Создайте env-файл, содержащий OPENAI_API_KEY и TINKER_API_KEY, и JSON-файл чекпоинта, описывающий путь к сэмплеру StealthRL Tinker.
Запустите предварительную проверку.
python scripts/preflight_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_repro \
  --gpus 0 1 2 3
Изучите сгенерированные выходы методов, оценки детекторов, метрики и графики в выбранном каталоге запуска.
Если вам нужно только повторно запустить оценку качества на основе GPT на кэшированных результатах:
python scripts/run_gpt_quality_only.py \
  --run-root outputs/eval_runs/full_mage_repro \
  --env-file ~/.config/stealthrl/eval.env
python scripts/compute_bertscore_for_run.py \
  --run-dir outputs/eval_runs/full_mage_repro/assembled \
  --device cuda:0 \
  --batch-size 16 \
  --chunk-size 512
Скрипт BERTScore обновляет quality.parquet и quality.csv на месте после каждого чанка, поэтому прерванные запуски можно возобновлять без пересчёта уже обработанных строк. Используйте --limit-per-method для небольшого смоук-теста и --force только при намеренном пересчёте существующих столбцов BERTScore.
Поэтапный запуск создаёт:
