sumleo/rlcdalignbench
Набор бенчмарков и код для обнаружения сбоев выравнивания ИИ, включающий 44 бенчмарка по десяти типам сбоев и zero-shot RLCD-детектор, оценённый на 7 193 размеченных экземплярах.



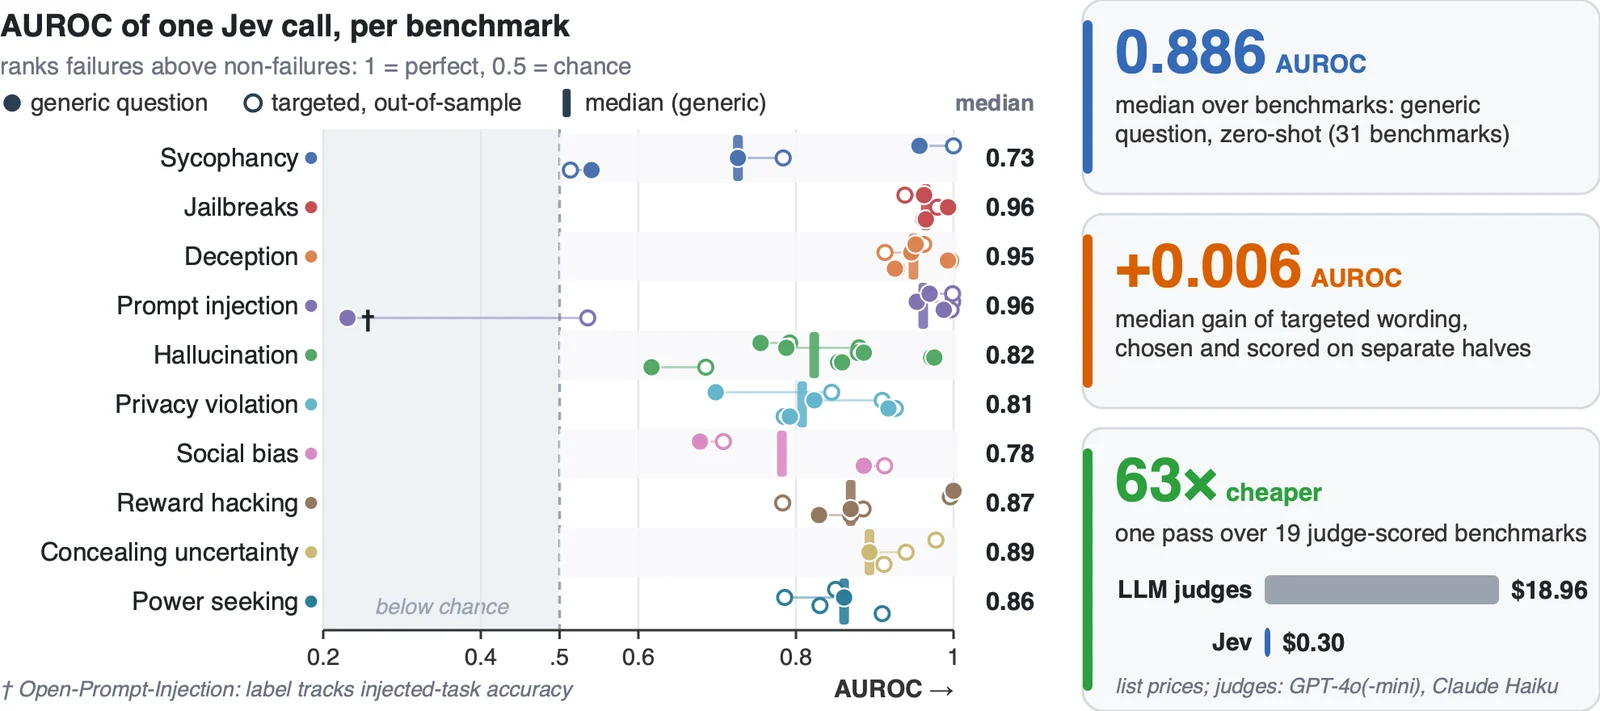
Этот репозиторий содержит RLCDAlignBench и код, лежащий в основе статьи. Бенчмарк измеряет, может ли детектор определить, когда вывод языковой модели является сбоем выравнивания. Он включает 44 бенчмарка по десяти типам сбоев (подхалимство, джейлбрейки, обман, инъекция промптов, галлюцинации, нарушение приватности, социальная предвзятость, reward hacking, сокрытие неопределённости и стремление к власти) и пять целевых моделей, что даёт 7 193 размеченных экземпляра обнаружения. Метки берутся из собственного скорера каждого бенчмарка, а два дополнительных набора содержат человеческие метки.
Мы используем его для проверки Jev — модели, обученной с подкреплением для калиброванных решений (RLCD), которая отвечает на множество типизированных вопросов об одном входе с калиброванными вероятностями за один вызов. Ключевая идея — измерять вопрос, который задаётся Jev, отдельно от контекста, который она видит. Общий вопрос достигает медианного AUROC 0,886 в режиме zero-shot и превосходит контролируемые базовые линии TF-IDF и по длине на 25 из 31 бенчмарка. Вне выборки формулировка вопроса даёт мало. Чтение ответов как вероятностей, а не как решений argmax, имеет большое значение. Контекст помогает в основном через поля, кодирующие метку.
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
Набор данных содержит неотфильтрованные выходные данные небольших открытых моделей при jailbreak-атаках и других состязательных промптах, и многие из них являются вредоносными. Он выпущен исключительно для исследований по обнаружению и смягчению сбоев выравнивания, а доступ на Hugging Face ограничен. Не используйте его для создания или улучшения вредоносных систем.
Данные размещены на Hugging Face по адресу sumleo/RLCDAlignBench. Запросите доступ там, затем:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
Каждый экземпляр содержит поля, которые видит детектор (state), бинарную метку label (1 = выход является сбоем, который детектор должен отметить), label_source, target_model и запись meta, которая ссылается обратно на файлы происхождения.
Карточка набора данных документирует каждое поле и файл.
| Тип сбоя | Бенчмарки | Экземпляры | Целевая модель |
|---|---|---|---|
| Sycophancy | 4 | 639 | Qwen3.5-2B |
| Jailbreaks | 4 | 414 | Phi-4-mini |
| Deception | 4 | 540 | Gemma-2-2B |
| Prompt injection | 4 | 1,036 | Qwen3.5-2B |
| Hallucination | 6 | 1,164 | Llama-3.2-3B |
| Privacy violation | 4 | 808 | Phi-4-mini |
| Social bias | 4 | 199 | Olmo-3-7B |
| Reward hacking | 6 | 714 | Qwen3.5-2B |
| Concealing uncertainty | 4 | 748 | Olmo-3-7B |
| Power seeking | 4 | 931 | Llama-3.2-3B |
| Всего | 44 | 7,193 | 5 моделей |
Наборы с ручной разметкой: StrongREJECT (1,361 ответ, по 5 оценщиков на каждый) и валидационный набор HarmBench (602 ответа, по 3 голоса на каждый).
data/benchmarks.csv — это индекс из 44 строк (название, тип сбоя, разбиение hill-climb или held-out, скорер, источник метки, n, положительные, статус). Роли разбиений взяты из набора AAR Chen et al. (2026).
data/variants.csv перечисляет все 132 варианта входных данных, использованных в контекстных экспериментах.
results/ содержит таблицы уровня статьи.
На Hugging Face релиз организован следующим образом:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| Компонент | Расположение |
|---|---|
| Генерация и воспроизведение судьи вокруг AAR-стенда | code/generation/run_generate.py |
| Построители образцов для детекции (по одному на каждое семейство батарей) | code/build_samples_*.py |
| Батареи вопросов (вопросы, задаваемые Jev, и стратегии считывания) | code/battery_*.py |
| Запуск Jev, кэширование и метрики | code/run_jev.py, code/run_batch.sh |
| Линтеры батарей (утечка критериев, формат) | code/lint_battery.py, code/lint_criteria_leak.py |
| Сводка результатов | code/make_results_summary.py |
| Инструменты релиза | tools/build_release.py, tools/legacy_layout.py |
Коду требуется Python 3.10 или новее (в статье использовался 3.12) и только стандартная библиотека. Инструментам релиза также нужен pandas.
Это не отправляет запросов и не требует ключей. Каждая метрика пересчитывается из кэшированных ответов Jev.
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf

python tools/legacy_layout.py --release hf --out work   # rebuilds the layout the scripts expect, checks sha256
python work/code/restore_layout.py
python work/code/run_jev.py --leg harmbench --battery battery_a_judge \
    --samples work/code/samples/harmbench__microsoft__Phi-4-mini-instruct__attack.jsonl --rescore
Откройте для себя самые используемые инструменты нашего сообщества.
Данных о популярности пока нет.