 rodricios/wxpath
wxpath - декларативный веб-скрапинг с XPath; язык веб-запросов (WQL)


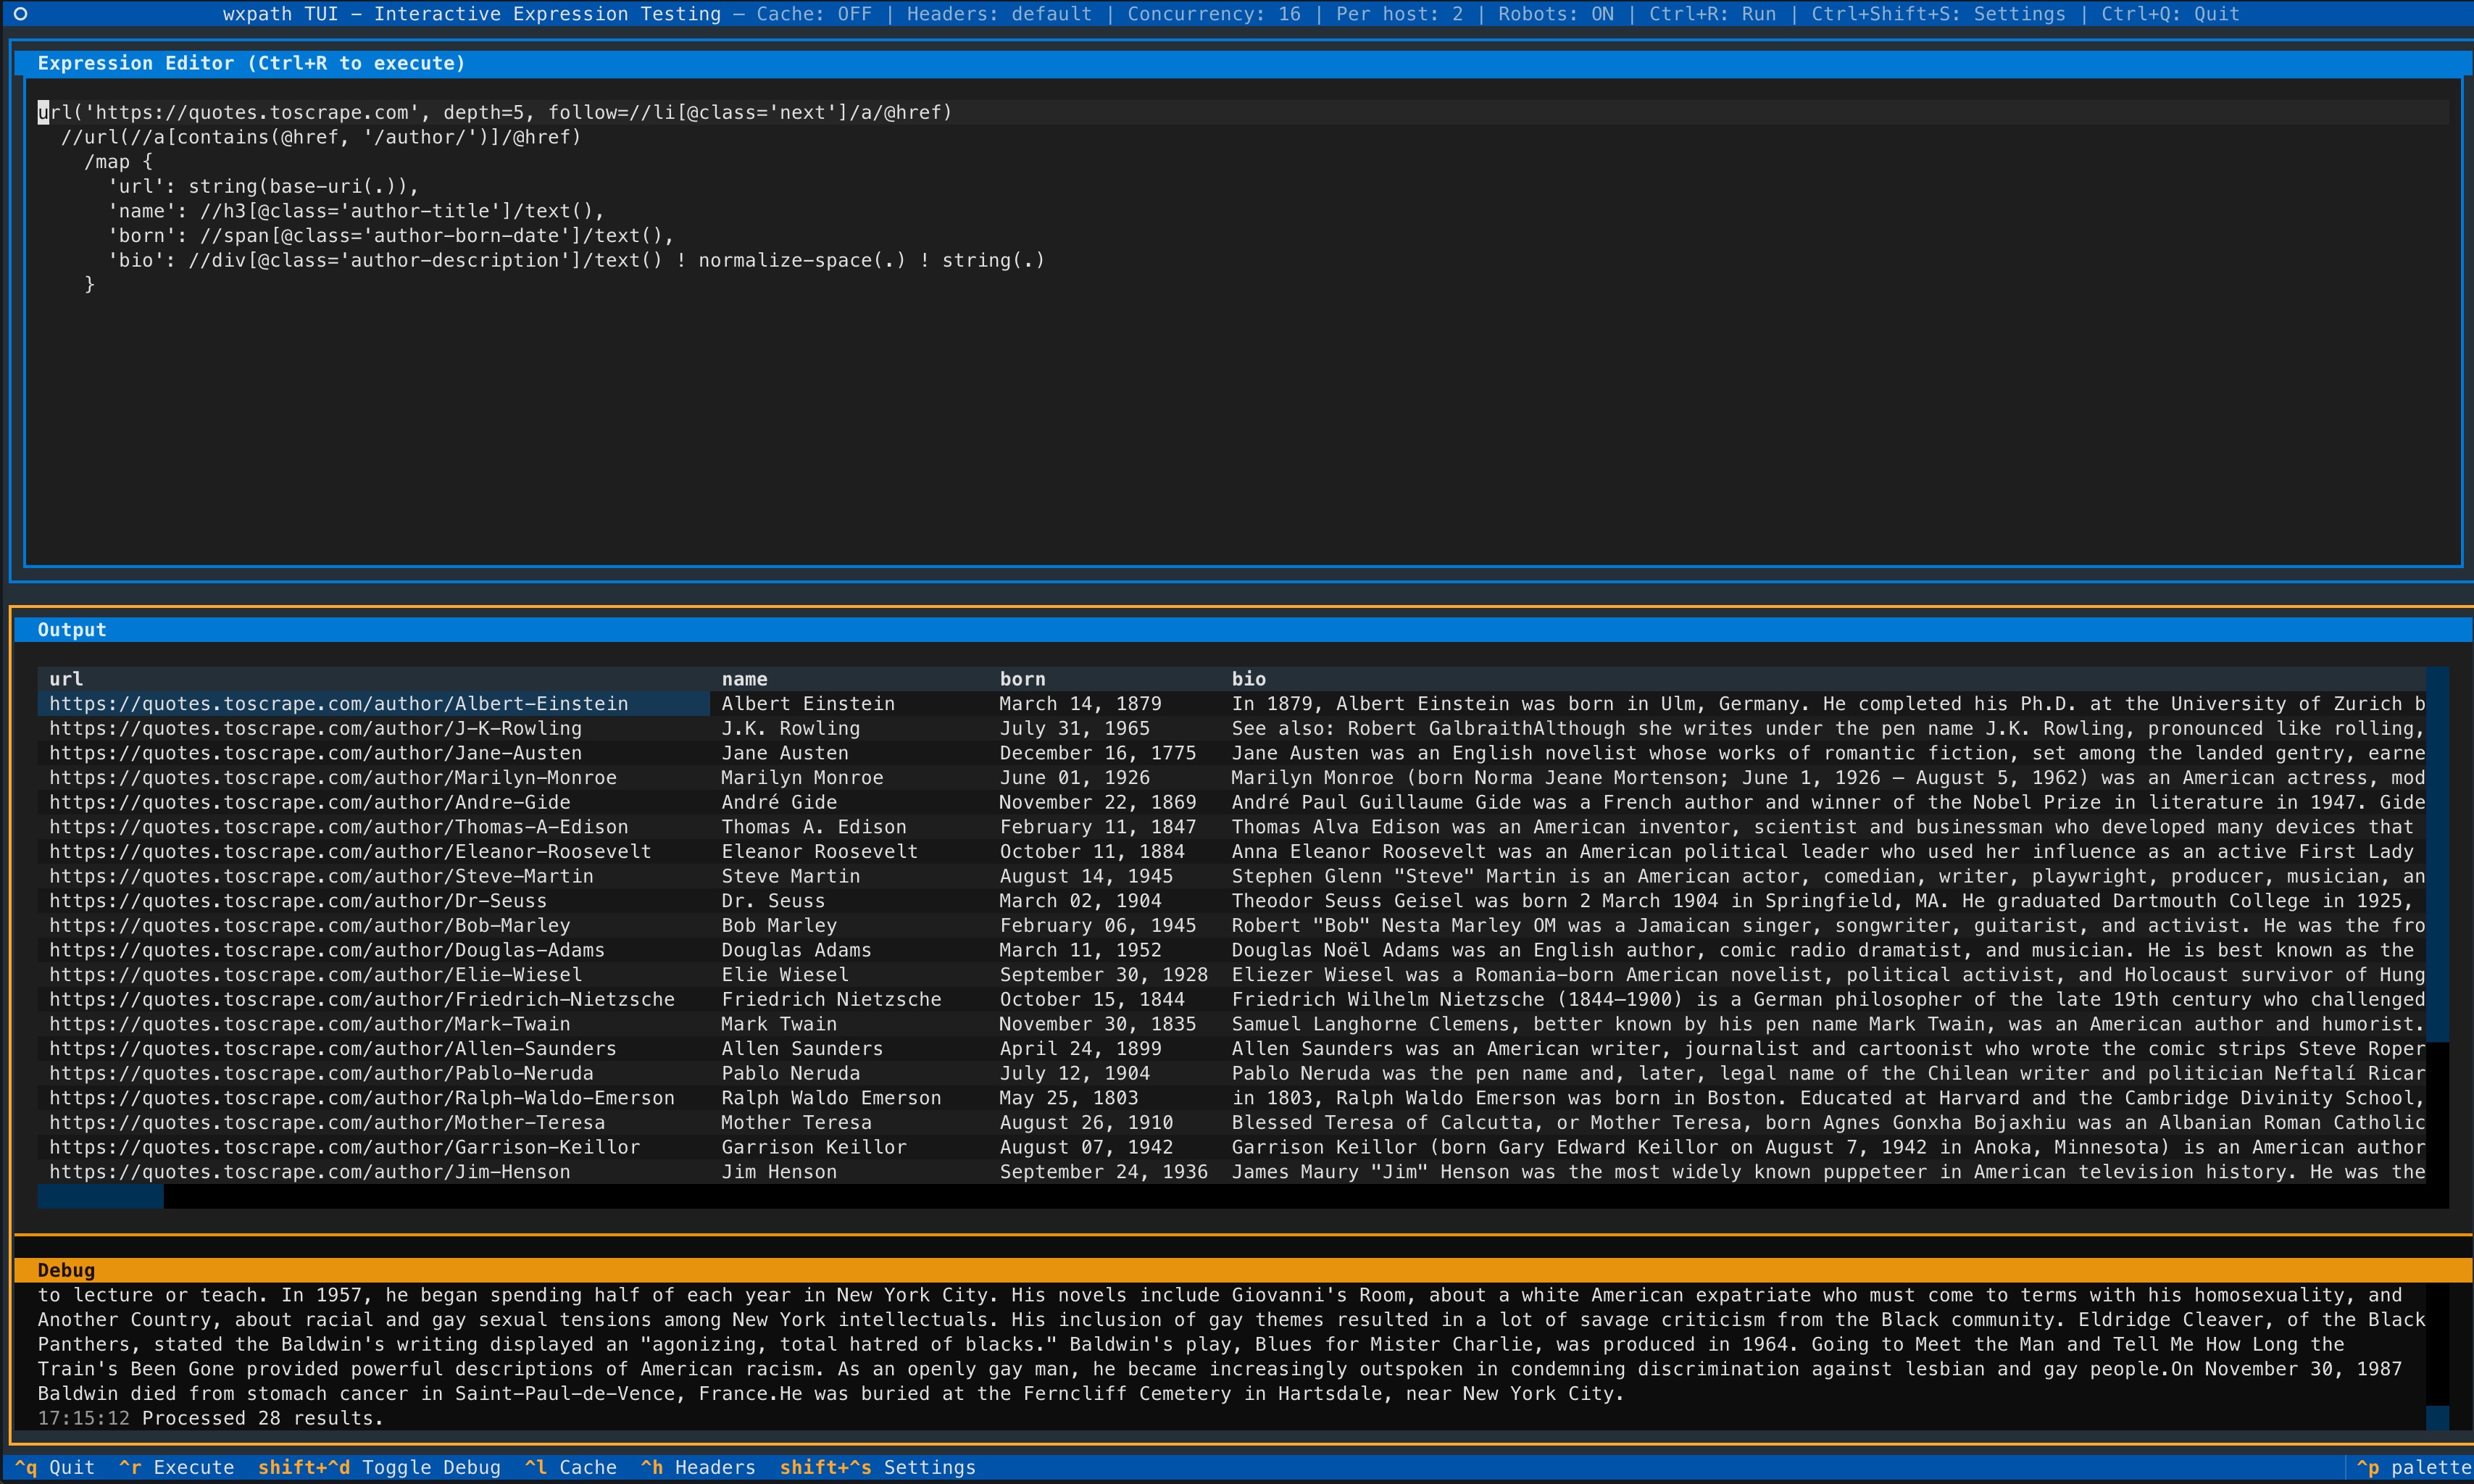
НОВИНКА: TUI — интерактивный терминальный интерфейс (на основе Textual) для тестирования выражений wxpath и экспорта данных.
Требуется Python 3.10+.
pip install wxpath
# Для поддержки TUI:
pip install "wxpath[tui]"
# Быстрый запуск TUI через uv:
uvx --from "wxpath[tui]" wxpath-tui
wxpath — это декларативный веб-сканер, в котором обход выражается непосредственно в XPath. Вместо написания императивных циклов сканирования, wxpath позволяет описать, что отслеживать и что извлекать, в одном выражении. wxpath выполняет это выражение конкурентно, в стиле поиска в ширину, и передаёт результаты по мере их обнаружения.
Это выражение загружает страницу, извлекает ссылки и передаёт их конкурентно — без цикла сканирования:
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
Благодаря оператору url(...) и синтаксису ///, движок wxpath может выполнять рекурсивный (или постраничный) веб-сканнинг и извлечение:
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
Большинство веб-скраперов заставляют сначала писать управляющий код сканирования, а затем извлечение.
wxpath объединяет эти два шага в один:
Извлекайте чистые, структурированные иерархии JSON непосредственно из графа — подавайте в LLM сигнал, а не шум. Подробнее в разделе Интеграция с LangChain.
wxpath детерминирован (читайте: не на основе LLM). Мы не можем гарантировать стабильность сети, но можем гарантировать предсказуемость обхода.
Документация доступна здесь.
url(...) и ///url(...)import wxpath
from wxpath.settings import CRAWLER_SETTINGS
# Пользовательские заголовки для вежливости; необходимы для некоторых сайтов (например, Wikipedia)
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contact: [email protected])'}
# Сканирование, извлечение полей, построение графа знаний
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
Примечание: Некоторые сайты (включая Wikipedia) могут блокировать запросы без правильных заголовков.
См. раздел Продвинутая настройка движка и краулера для установки пользовательского User-Agent.
Приведённое выше выражение делает следующее:
https://en.wikipedia.org/wiki/Expression_language.<main>, которые начинаются с /wiki/ и не содержат двоеточие (:).url(...) и ///url(...)url(...) — пользовательский оператор, который загружает содержимое указанного пользователем или созданного внутри URL и возвращает его как lxml.html.HtmlElement для дальнейшей обработки XPath.///url(...) указывает на глубокое сканирование. Он сообщает движку продолжать переход по ссылкам до указанного max_depth. В отличие от повторяющихся шагов url(), он позволяет одному выражению описывать более глубокое исследование графа. ВНИМАНИЕ: Используйте с осторожностью и ограничениями (через max_depth или предикаты XPath), чтобы избежать взрывного роста обхода.Подробности проектирования языка см. в DESIGN.md. Вы увидите основные концепции и сможете спроектировать язык с нуля.
wxpath вычисляет выражение как список шагов обхода и извлечения (внутренне называемых Segment).
url(...) создаёт задачи сканирования либо статически (через фиксированный URL), либо динамически (через URL, полученный из выражения XPath). URL дедуплицируются глобально, по принципу best-effort, а не по глубине.
Сегменты XPath работают с загруженными документами (загруженными через непосредственно предшествующие операции url(...)).
///url(...) указывает на глубокое сканирование — оно выполняется примерно в ширину до max_depth.
Результаты передаются, как только они готовы.
wxpath использует asyncio/aiohttp в первую очередь, предоставляя асинхронный API для сканирования и извлечения данных.
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
wxpath также предоставляет API asyncio-in-sync, позволяя сканировать несколько страниц конкурентно, сохраняя простоту синхронного кода. Это особенно полезно для сканирований в строго синхронных средах выполнения (т.е. не внутри цикла событий asyncio), где важна производительность.
from wxpath import wxpath_async_blocking_iter

path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
items = list(wxpath_async_blocking_iter(path_expr, max_depth=1))
wxpath по умолчанию соблюдает robots.txt через конструктор WXPathEngine(..., robotstxt=True).
