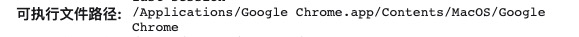
 qianlitp/crawlergo
Мощный браузерный краулер для сканеров веб-уязвимостей


Мощный браузерный краулер для сканеров уязвимостей веб-приложений
Английская документация | 中文文档
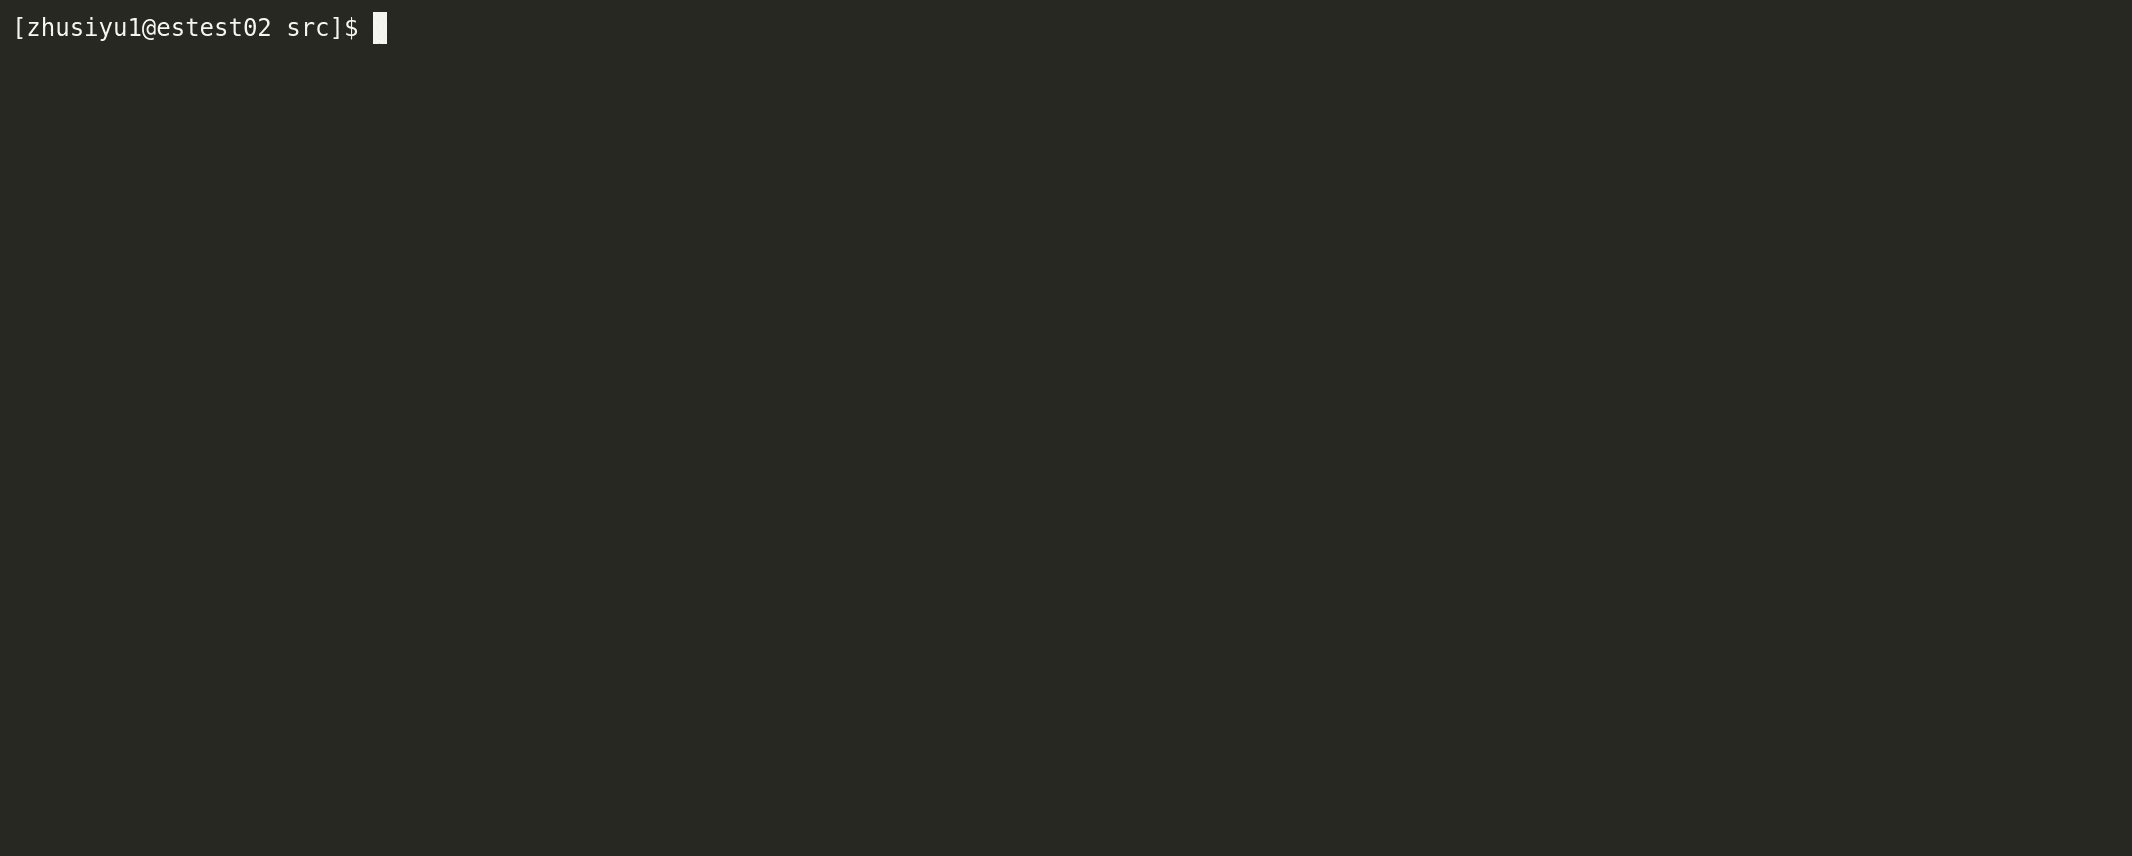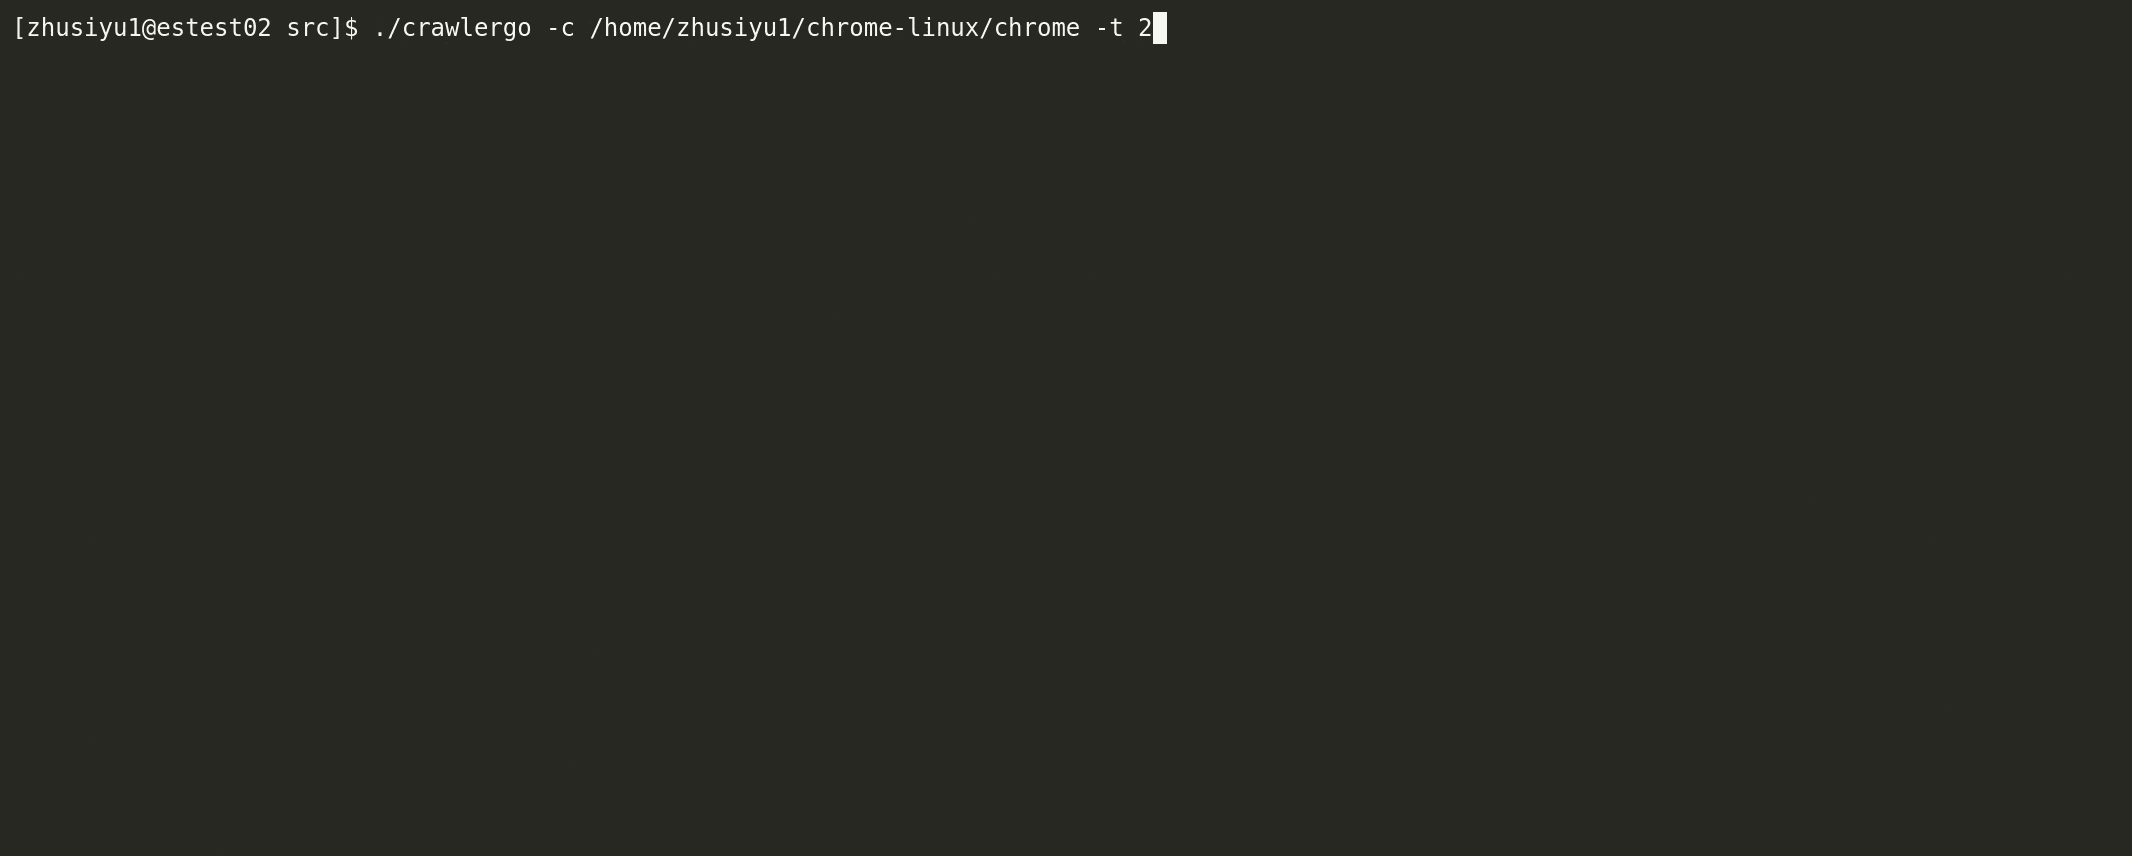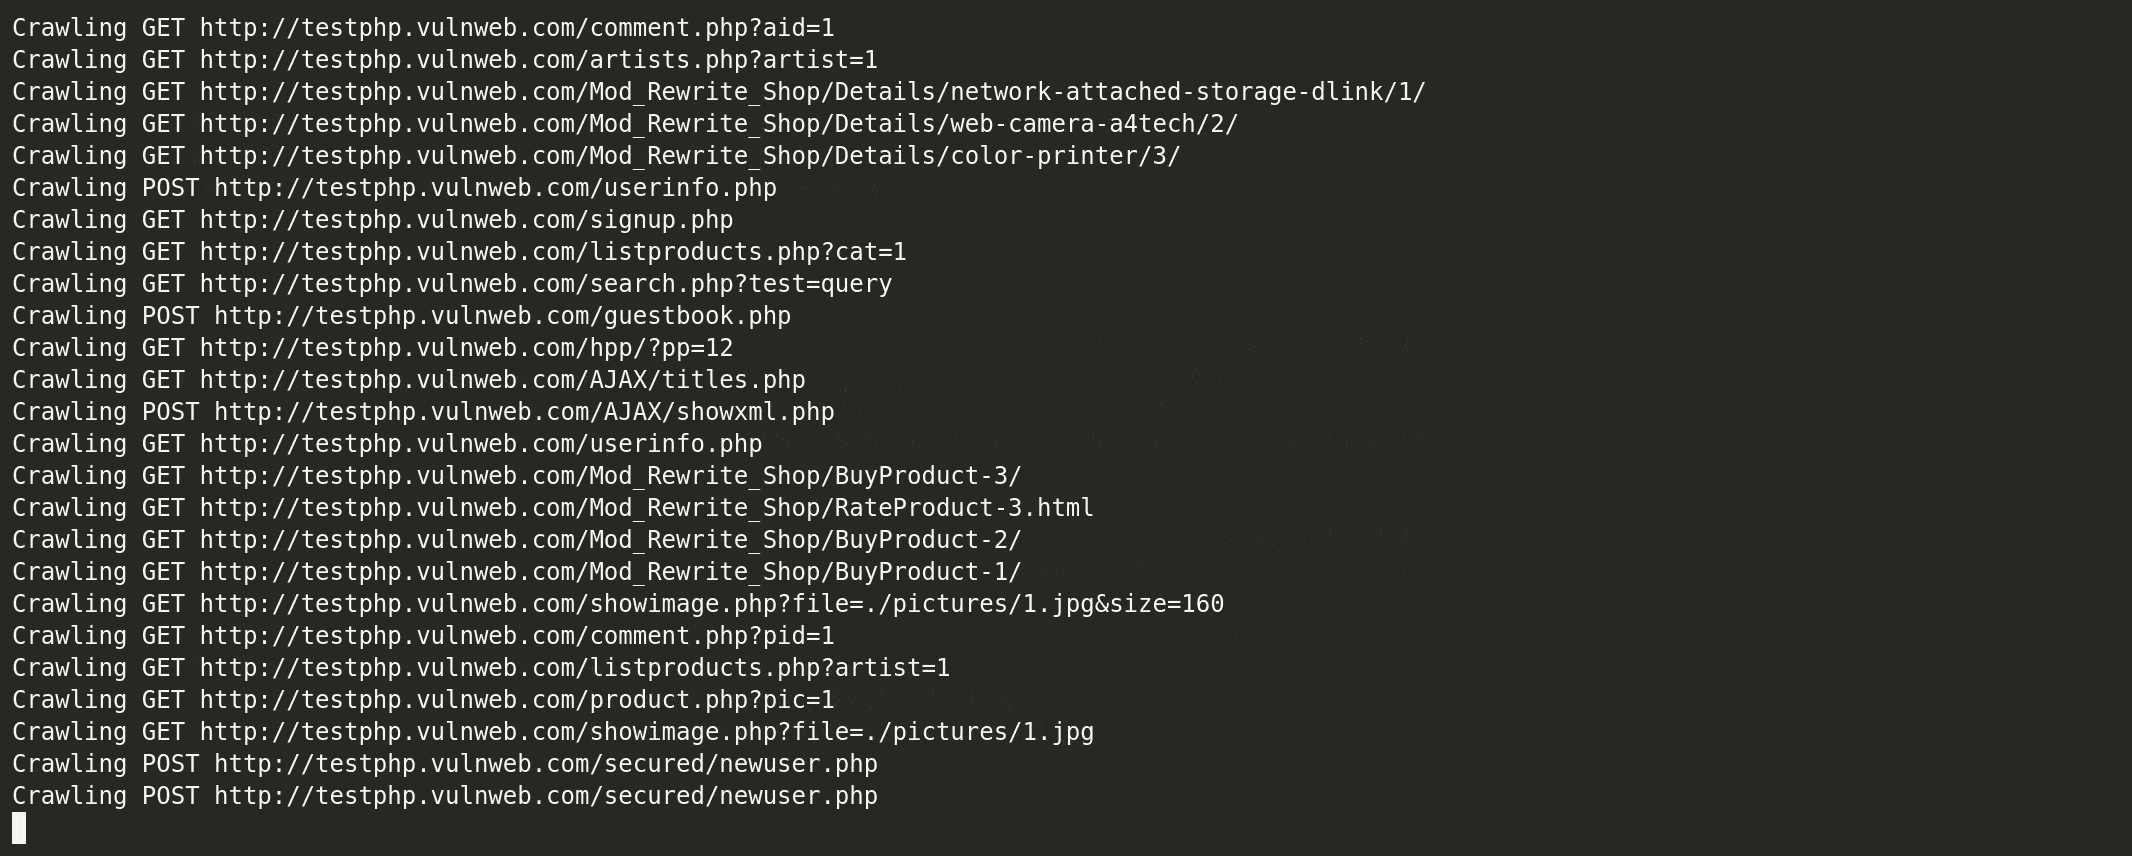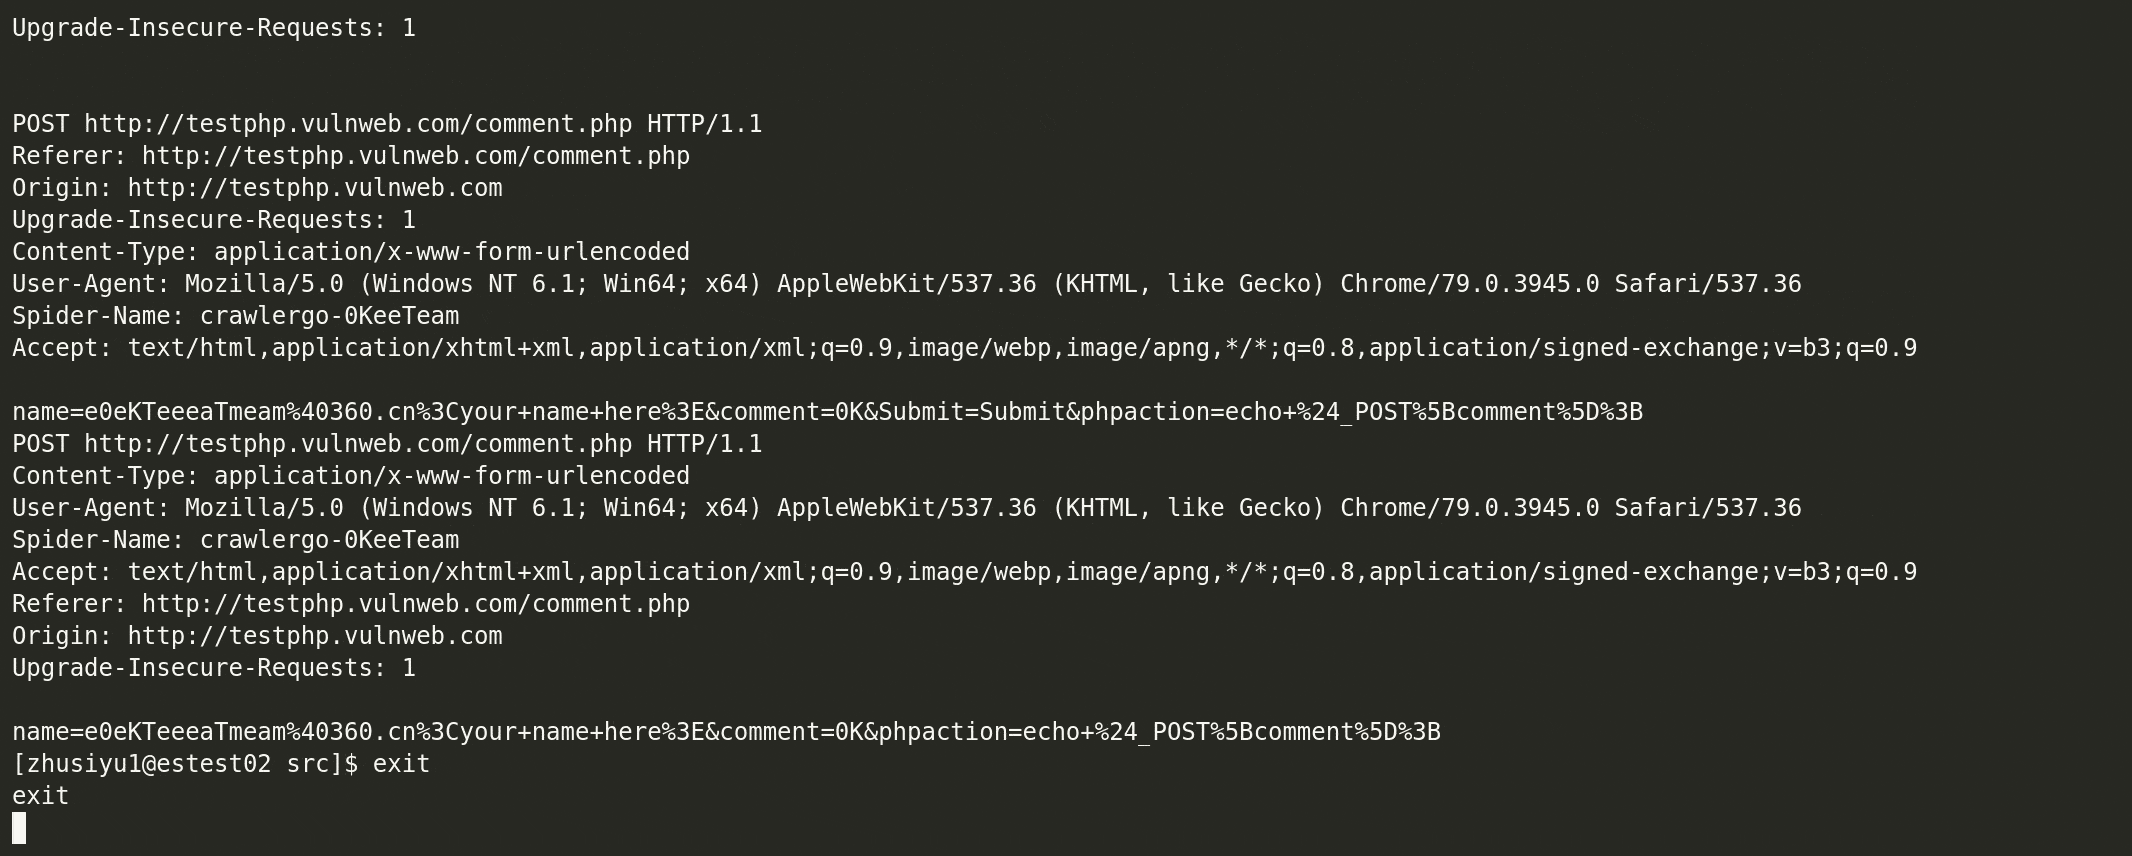
crawlergo — это браузерный краулер, использующий режим chrome headless для сбора URL. Он перехватывает ключевые позиции всей веб-страницы на этапе рендеринга DOM, автоматически заполняет и отправляет формы, интеллектуально инициирует события JavaScript и собирает как можно больше точек входа, доступных на веб-сайте. Встроенный модуль дедупликации URL отфильтровывает большое количество псевдостатических URL, сохраняя при этом высокую скорость анализа и сканирования для крупных веб-сайтов, и в итоге предоставляет высококачественный набор результатов запросов.
В настоящее время crawlergo поддерживает следующие возможности:
Пожалуйста, внимательно прочитайте и подтвердите отказ от ответственности перед установкой и использованием.
Сборка
make build
make build_all
Если вы используете Linux и Chrome сообщает о недостающих зависимостях, ознакомьтесь с разделом Troubleshooting ниже.
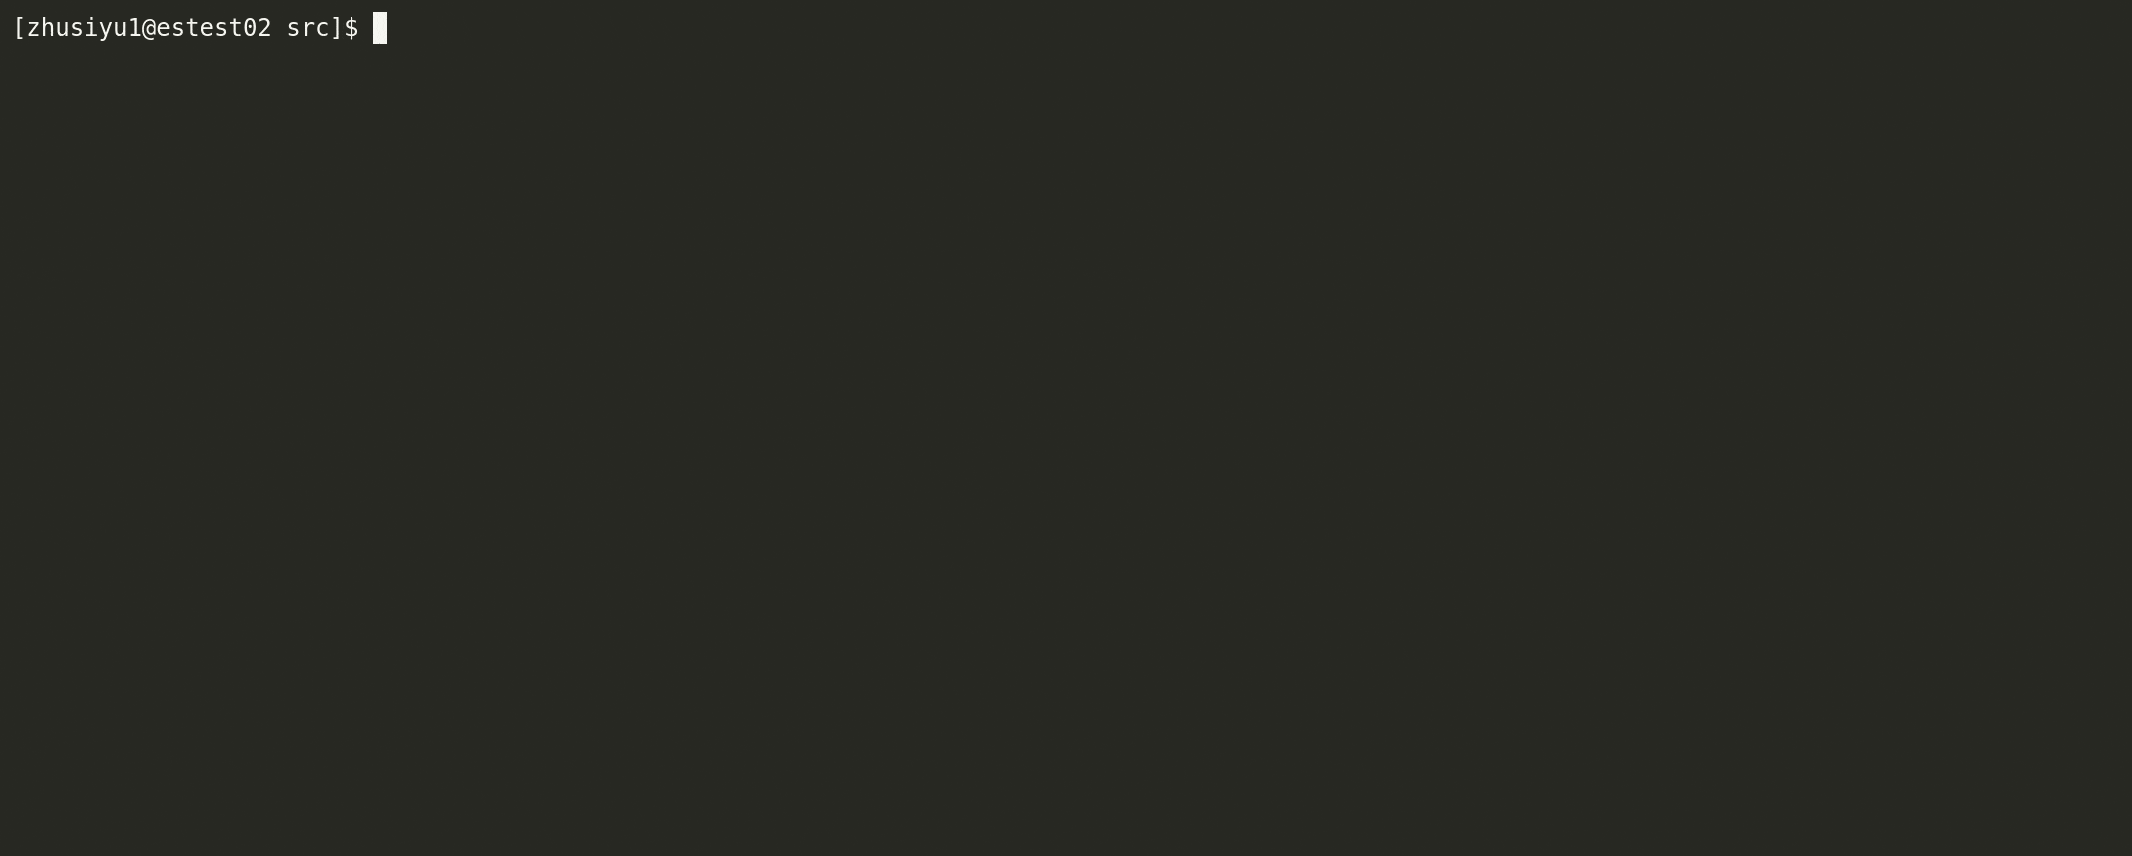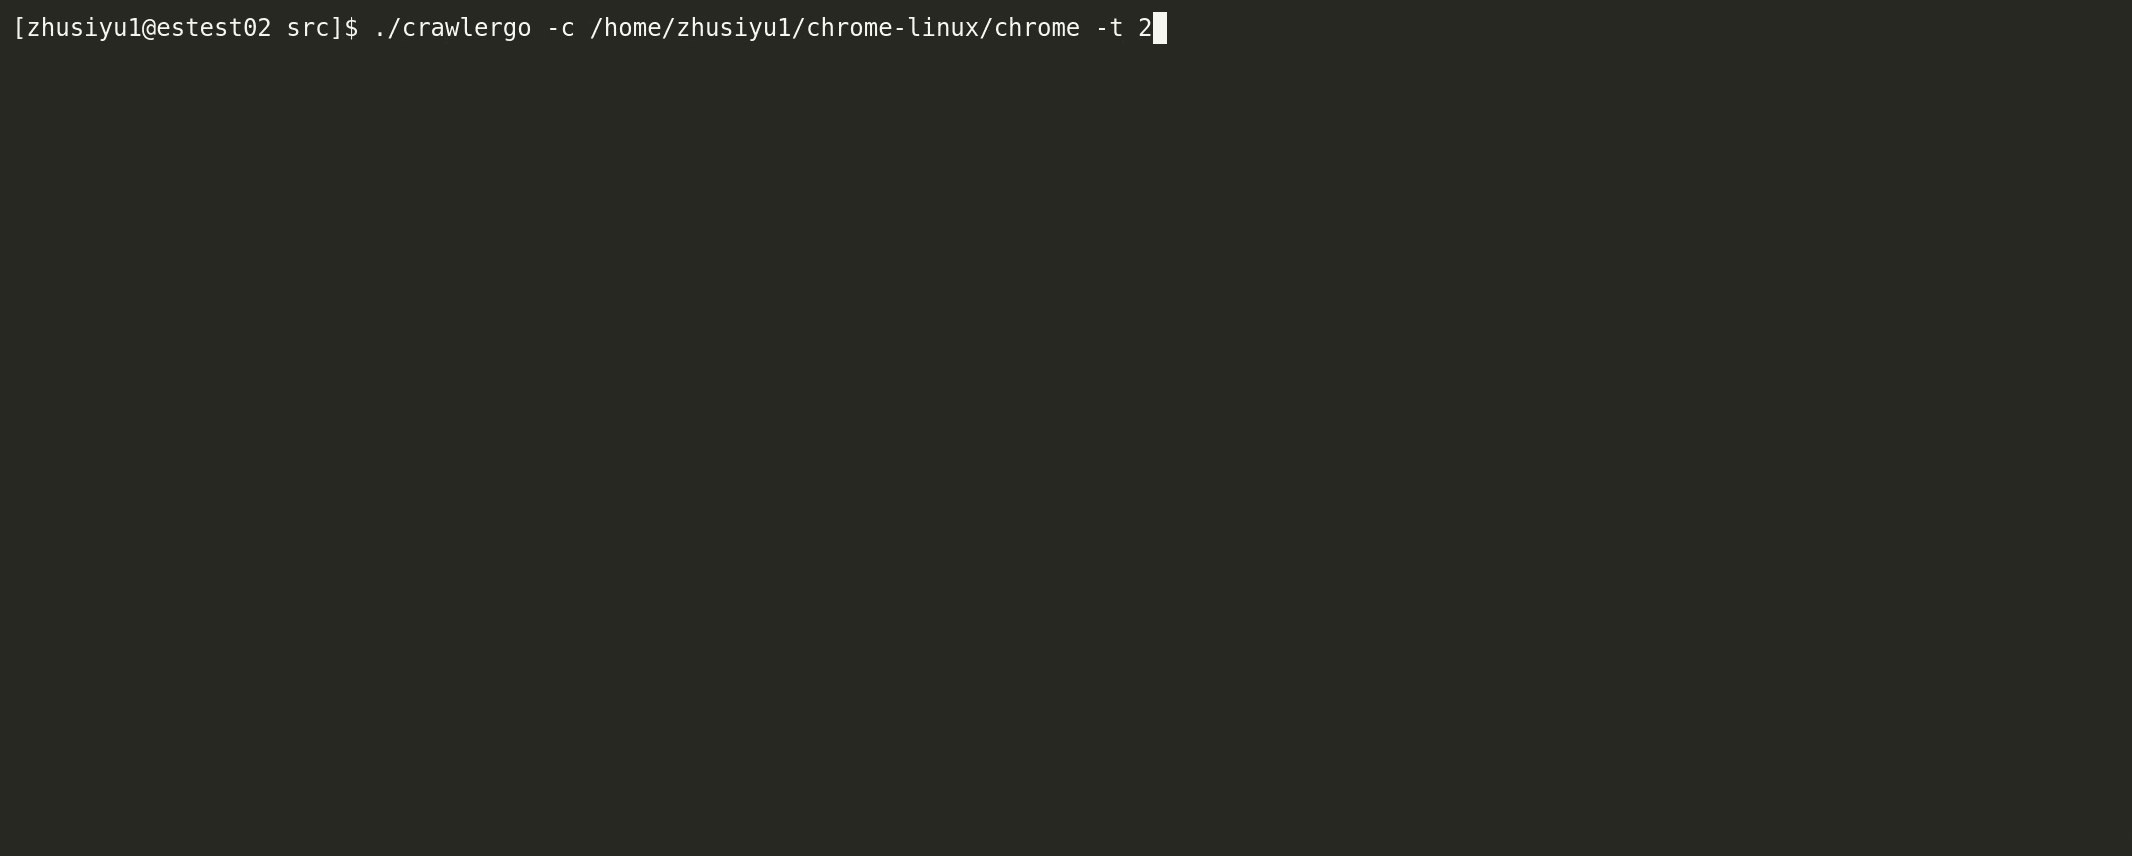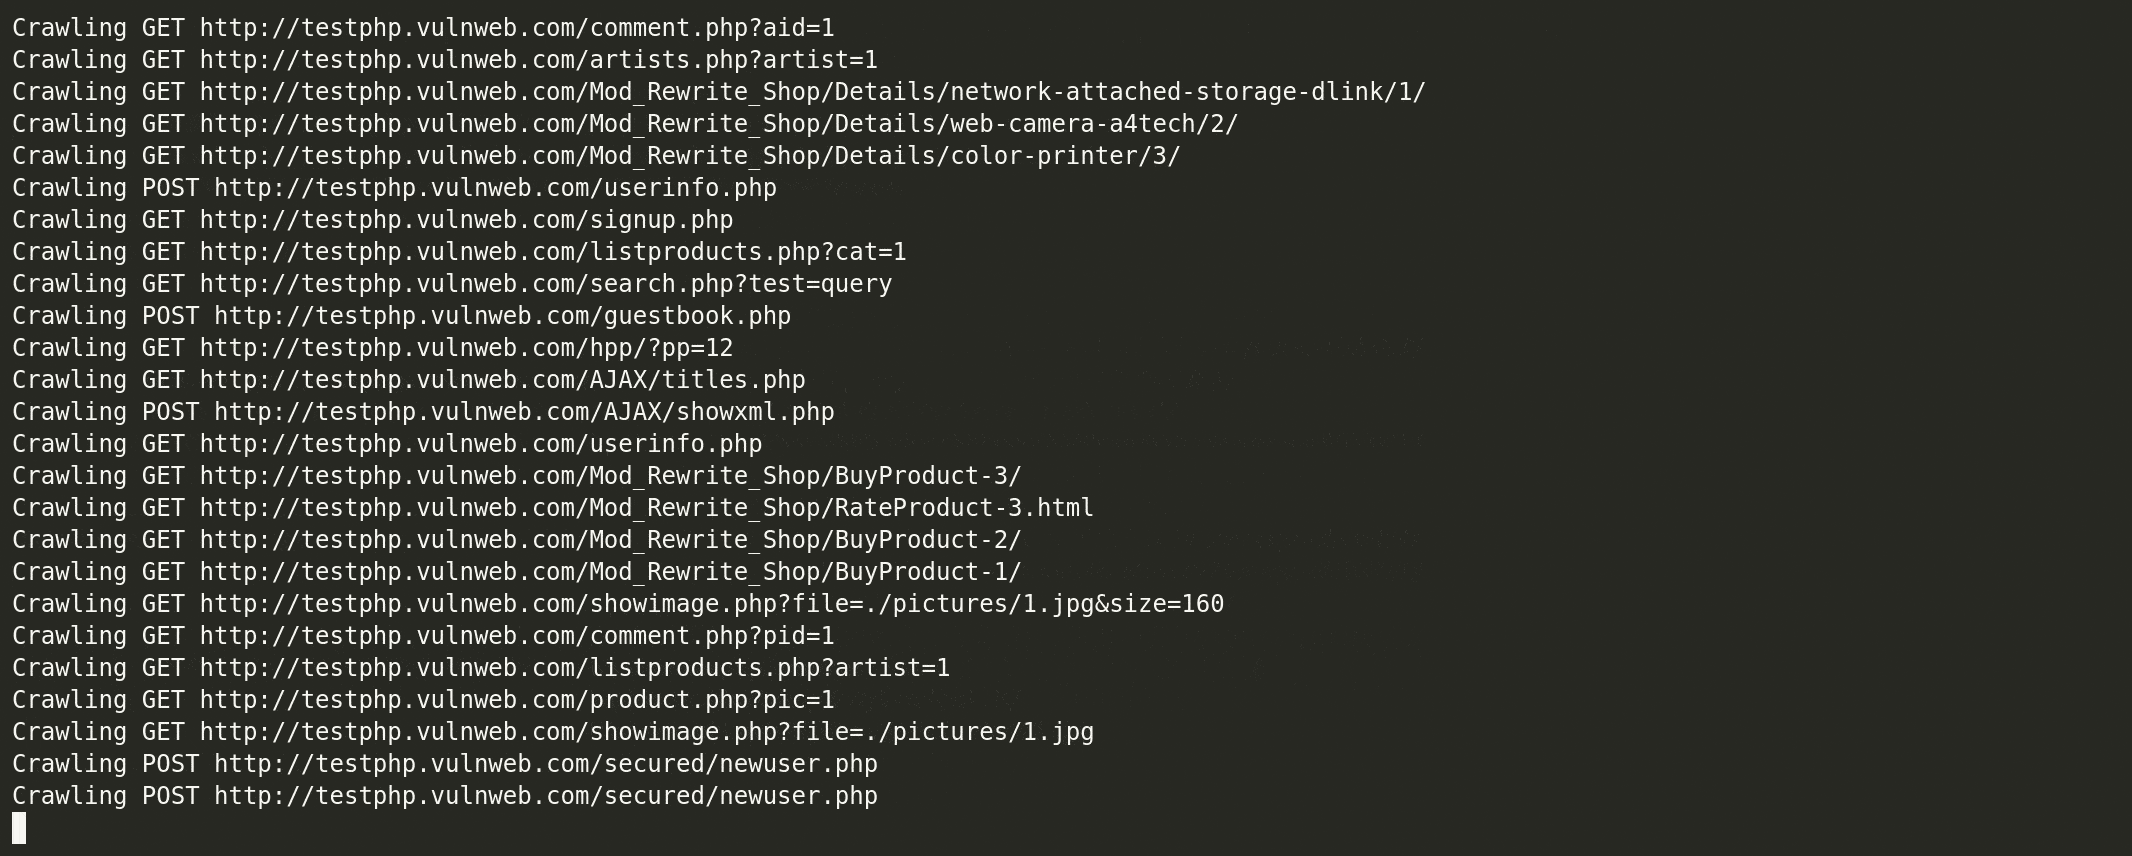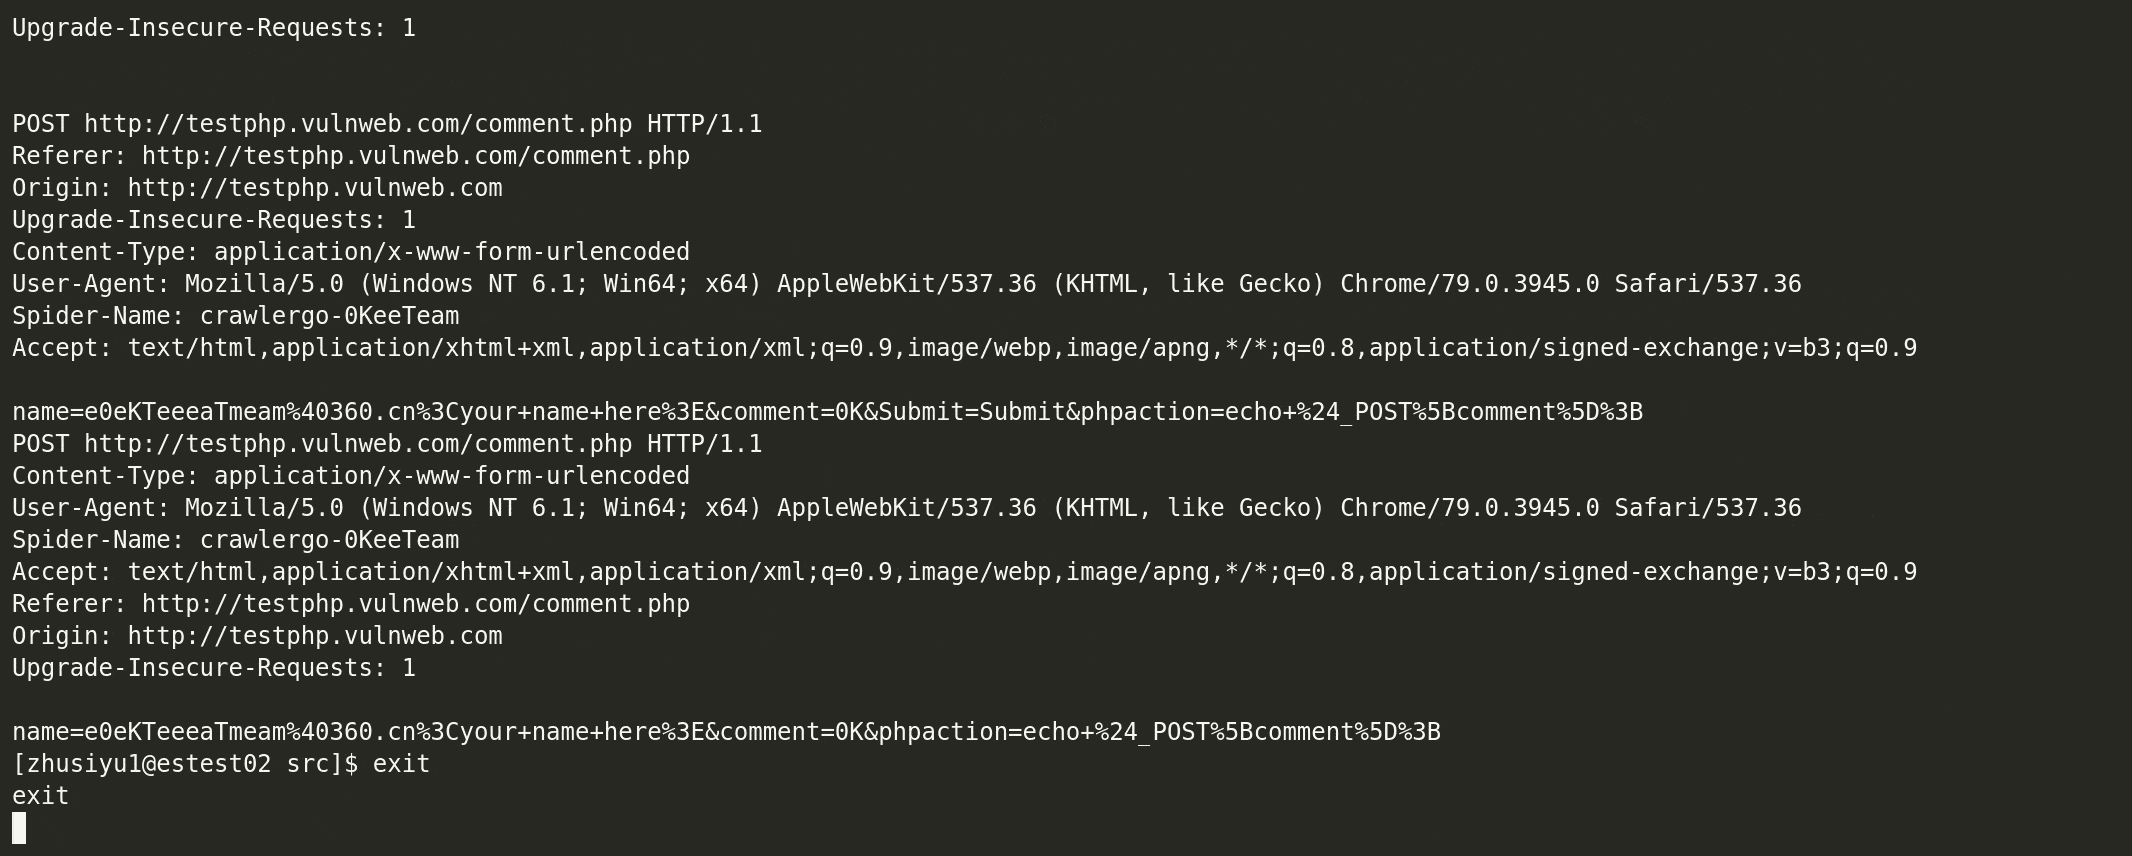
Предположим, ваш каталог установки Chromium — /tmp/chromium/, установите 10 одновременно открытых вкладок и сканируйте testphp.vulnweb.com:
bin/crawlergo -c /tmp/chromium/chrome -t 10 http://testphp.vulnweb.com/
Вы также можете использовать этот инструмент с Docker без лишних хлопот:
git clone https://github.com/Qianlitp/crawlergo
docker build . -t crawlergo
docker run crawlergo http://testphp.vulnweb.com/
bin/crawlergo -c /tmp/chromium/chrome -t 10 --request-proxy socks5://127.0.0.1:7891 http://testphp.vulnweb.com/
По умолчанию crawlergo выводит результаты прямо на экран. Далее мы устанавливаем режим вывода в json, и пример кода для вызова с использованием Python выглядит следующим образом:
#!/usr/bin/python3
# coding: utf-8

import simplejson
import subprocess


def main():
    target = "http://testphp.vulnweb.com/"
    cmd = ["bin/crawlergo", "-c", "/tmp/chromium/chrome", "-o", "json", target]
    rsp = subprocess.Popen(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
    output, error = rsp.communicate()
	#  "--[Mission Complete]--"  — это строка-разделитель окончания задачи
    result = simplejson.loads(output.decode().split("--[Mission Complete]--")[1])
    req_list = result["req_list"]
    print(req_list[0])


if __name__ == '__main__':
    main()
Когда режим вывода установлен в json, возвращаемый результат после десериализации JSON содержит четыре части:
all_req_list — все запросы, обнаруженные в ходе данной задачи сканирования, включая любые типы ресурсов с других доменов.req_list — возвращает результаты текущего домена этой задачи сканирования, после псевдостатической дедупликации, без ссылок на статические ресурсы. Является подмножеством all_req_list.all_domain_list — список всех найденных доменов.sub_domain_list — список найденных поддоменов.crawlergo возвращает полные запросы и URL, которые можно использовать различными способами:
Совместное использование с другими пассивными сканерами уязвимостей веб-приложений
Сначала запустите пассивный сканер и установите адрес прослушивания: http://127.0.0.1:1234/
Затем, предполагая, что crawlergo находится на той же машине, что и сканер, запустите crawlergo с параметрами:
--push-to-proxy http://127.0.0.1:1234/
Привязка хоста (недоступна для высоких версий Chrome) (пример)
Пользовательские Cookies (пример)
Регулярная очистка зомби-процессов, порождаемых crawlergo (пример), предоставлено @ring04h
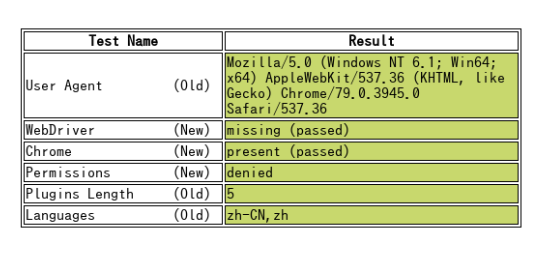
crawlergo может обходить обнаружение headless-режима по умолчанию.
https://intoli.com/blog/not-possible-to-block-chrome-headless/chrome-headless-test.html
Не найдено 'Fetch.enable'
Fetch — это функция, поддерживаемая новой версией Chrome. Если возникает эта ошибка, значит ваша версия устарела, обновите версию Chrome.
Chrome запускается с пропущенными зависимостями, такими как xxx.so
// Ubuntu
apt-get install -yq --no-install-recommends \
     libasound2 libatk1.0-0 libc6 libcairo2 libcups2 libdbus-1-3 \
     libexpat1 libfontconfig1 libgcc1 libgconf-2-4 libgdk-pixbuf2.0-0 libglib2.0-0 libgtk-3-0 libnspr4 \
     libpango-1.0-0 libpangocairo-1.0-0 libstdc++6 libx11-6 libx11-xcb1 libxcb1 libgbm1 \
     libxcursor1 libxdamage1 libxext6 libxfixes3 libxi6 libxrandr2 libxrender1 libxss1 libxtst6 libnss3

// CentOS 7
sudo yum install pango.x86_64 libXcomposite.x86_64 libXcursor.x86_64 libXdamage.x86_64 libXext.x86_64 libXi.x86_64 \
     libXtst.x86_64 cups-libs.x86_64 libXScrnSaver.x86_64 libXrandr.x86_64 GConf2.x86_64 alsa-lib.x86_64 atk.x86_64 gtk3.x86_64 \
     ipa-gothic-fonts xorg-x11-fonts-100dpi xorg-x11-fonts-75dpi xorg-x11-utils xorg-x11-fonts-cyrillic xorg-x11-fonts-Type1 xorg-x11-fonts-misc -y

sudo yum update nss -y
Запуск выдает ошибку Navigation timeout / браузер не найден / не знаете правильный путь к исполняемому файлу браузера
Убедитесь, что путь к исполняемому файлу браузера настроен правильно. Введите в адресной строке: chrome://version и найдите путь к исполняемому файлу: