
 js-lee-ai/refusal-relocates
Безопасность LLM: анализ того, как дообучение смещает поведение отказа, и оценка защит на основе замораживания слоёв и низкоранговых защит.





Страница проекта · Быстрый старт · Использование · CLI · Результаты · Воспроизведение · FAQ · Цитирование
Несколько десятков вредоносных примеров могут устранить отказ выровненной модели от вредоносных запросов. Предыдущие работы локализуют безопасность в конкретных слоях и направлениях, что предполагает защиту найденного места. Этот репозиторий проверяет данную предпосылку так, как это сделал бы адаптивный атакующий. Он находит, где можно восстановить отказ, замораживает эту область и атакует снова, а также исправляет обновление весов, после чего позволяет атакующему распространить его.
Исследование опирается на три измерения.
Этот репозиторий представляет собой измерение и обе защиты в виде небольшой библиотеки, а также записи запусков и скрипты, которые пересобирают таблицы статьи.
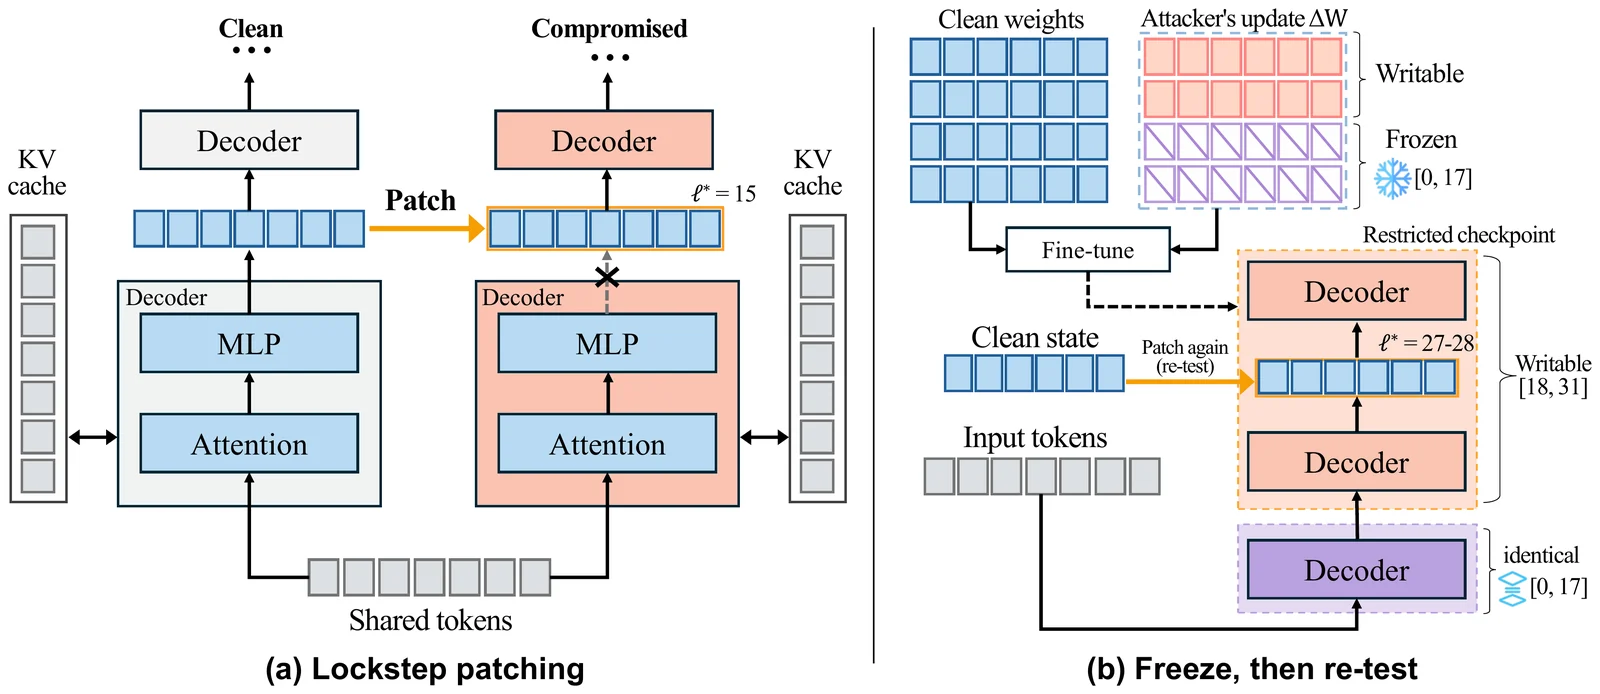
(a) Синхронное патчинг-воздействие активаций перезаписывает выход слоя скомпрометированной модели чистым состоянием при префилле и на каждом шаге декодирования. (b) В сопоставимой атаке на Llama замораживание слоёв 0–17 сдвигает переход через половину потолка с 15 на 27–28.
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
Обычный файнтюн помещает большую часть своего обновления в несколько сингулярных направлений, поэтому удаление двух главных направлений убирает большую его часть. Распределённое обновление имеет плоский спектр, поэтому то же самое удаление оставляет большую его часть на месте. PR/r — отношение участия к рангу LoRA — также является оценкой спектрального детектора из статьи.
Это выполняется на CPU примерно за секунду и ничего не скачивает. Тот же код находится в examples/quickstart.py, и CI запускает его при каждом push.
Чтобы обучать, патчить и оценивать реальные контрольные точки, установите дополнительный пакет models.
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| установка | добавляет | достаточно для |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | спектрального ядра, top-k удаления, детектора, скорера отказов, команды refusal |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch, transformers, peft, accelerate, safetensors, scikit-learn, datasets | обучения, lockstep-патчинга, проб и оценки на модели |
git clone и затем pip install -e ".[models,test]" | pytest | experiments/, records/ и tests/ |
Протестировано с Python 3.11.5, PyTorch 2.10.0, Transformers 4.57.3 и PEFT 0.18.0. Модели загружаются в bfloat16 на устройстве CUDA.
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))
Обе модели читают одни и те же токены, и на выбранном слое выход скомпрометированной модели заменяется выходом чистой модели. refusal patch выполняет полное измерение с его нижней и верхней границами и двумя контролями, оценивает когерентный отказ с помощью перплексионного фильтра и Llama-Guard и сообщает глубину перехода.
import refusal







