
 jev-sec/jev-ids
Быстродействующая и экономичная по количеству токенов система обнаружения вторжений (IDS) на основе Jev от TypeSafe.


Обнаружение вторжений за один запрос. Покажите Jev от TypeSafe один сетевой поток и пять размеченных примеров. Он ответит, является ли поток атакой и какого типа, за полсекунды, без текста для парсинга.
Jev IDS был протестирован на NSL-KDD, эталонном бенчмарке сообщества кибербезопасности, против современной LLM (Gemini 3.6 Flash на Vertex AI), классической модели машинного обучения (Random Forest) и необучаемой модели (Isolation Forest): 2 000 потоков, три сида, k от 0 до 8 примеров на категорию. При одинаковых пяти примерах (k = 1) Jev IDS был:
LLM — лучший детектор по F1: 0,880 против 0,856 у Jev при k = 1, и впереди при каждом k (McNemar p < 0,001), потому что он ловит больше атак тех типов, что показаны в примерах. Jev — второй, и на zero-day атаках, типов, отсутствующих в примерах, он ловит больше, чем LLM, с k = 1 по k = 8 (0,747 против 0,713 при k = 1). Цифры, графики и их ограничения — в Evidence and limits и docs/results.md.
Читать цикл · Шаблон запроса · Глоссарий
Jev — это System One Model. Вместо написания текста он читает state и отвечает на типизированные вопросы о нём с вероятностями. Jev IDS помещает один поток в состояние, рядом с инструкциями, именами столбцов, пятью описаниями категорий и размеченными примерами, и задаёт два вопроса. is_attack возвращается как вероятность. category возвращается как один из пяти вариантов с уверенностью. Вердикт — атака, когда вероятность достигает 0,5.
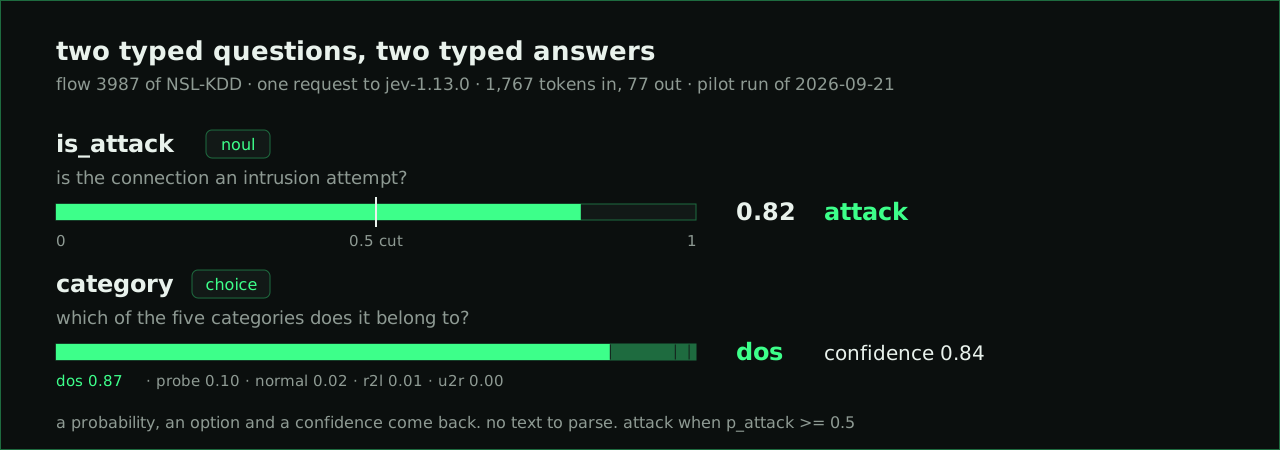
Каждый запрос следует одному и тому же пути:
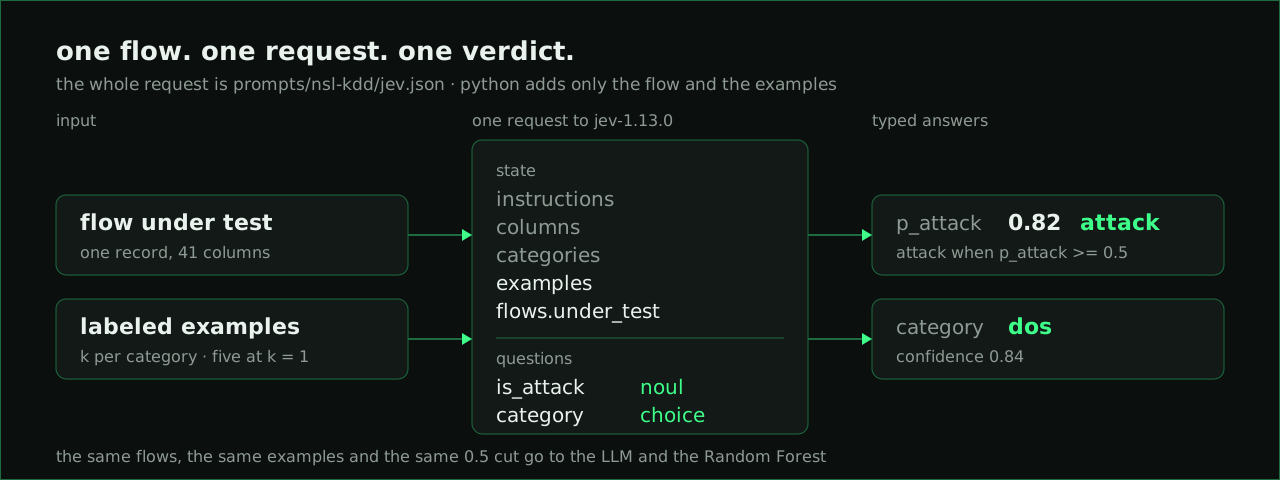
Весь запрос — это один файл, prompts/nsl-kdd/jev.json. Python добавляет только поток и примеры, а sha256 файла путешествует в каждой строке предсказания как prompt_hash, так что запуски, задававшие разные вопросы, никогда не сравниваются как равные. Примеры размечены только по категории: названия атак, такие как neptune, никогда не доходят до модели.
Те же потоки, примеры и порог 0,5 идут к двум базовым линиям: LLM через агента Agno с JSON-схемой вывода (Gemini 3.6 Flash через Vertex AI в статье; GPT-5.6 через бэкенд ChatGPT Codex или DeepSeek как альтернативы) и Random Forest из scikit-learn, обученный на тех же примерах. Третья базовая линия, Isolation Forest, обученный только на нормальных потоках пула, никогда не видит пример: это необучаемый эталон, только при k = all.
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
Скачайте NSL-KDD в data/raw/nsl-kdd/ и подготовьте его один раз:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
Smoke-сплит — это пять потоков. Запуск записывает results/<timestamp>-nsl-kdd-jev-smoke/ с config.json, одной JSON-строкой на поток в predictions.jsonl (вердикт, истина, p_attack, категория, уверенность, задержка и отчёт шлюза о токенах) и сырыми ответами в responses.jsonl.
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k — это число размеченных примеров на категорию. k = 1 с пятью категориями означает пять примеров, а all означает весь пул. metrics печатает одну строку CSV на детектор и k с F1, recall на zero-day атаках (novel в коде) и по категориям, PR-AUC и ROC-AUC для p_attack, токенами, задержкой и стоимостью. compare сопоставляет два запуска поток за потоком и выполняет тест McNemar на несогласованных парах, потому что только потоки, по которым два детектора расходятся, позволяют их различить. Стоимость вычисляется офлайн как токены, умноженные на прайс-лист из prices.json, одинаково для всех детекторов.
docs/protocol.md фиксирует входные данные (сплит paper из 2 000 потоков, промпты, идентификаторы моделей, цены), а make paper запускает четыре детектора на этом сплите в results/paper/ и записывает results/paper/summary.csv. У каждого детектора своя цель (make paper-jev, make paper-llm, make paper-random-forest, make paper-isolation-forest), так что они могут работать в отдельных терминалах; LLM — самый медленный. make paper-llm запускает Gemini 3.6 Flash на Vertex AI как пять параллельных процессов, по одному на k (make -j5 paper-llm); ошибка квоты или таймаут становится строкой ошибки, а uv run jev-ids redo-errors results/paper/<run> заново оценивает эти потоки на месте. Полные таблицы и графики — в docs/results.md.

