 jaidedai/easyocr
Готовый к использованию OCR с поддержкой более 80 языков и всех популярных систем письменности, включая латиницу, китайскую, арабскую, деванагари, кириллицу и др.


Готовый к использованию OCR с более чем 80 поддерживаемыми языками и всеми популярными системами письма, включая: латиницу, китайский, арабский, деванагари, кириллицу и другие.
Попробуйте демо на нашем сайте
Интегрировано в Huggingface Spaces 🤗 с помощью Gradio. Попробуйте веб-демо:
24 сентября 2024 г. — версия 1.7.2
Установка с помощью pip
Для последней стабильной версии:
pip install easyocr
Для последней версии в разработке:
pip install git+https://github.com/JaidedAI/EasyOCR.git
Примечание 1: Для Windows сначала установите torch и torchvision, следуя официальным инструкциям здесь https://pytorch.org. На сайте pytorch обязательно выберите правильную версию CUDA, которая у вас установлена. Если вы планируете запускать только в режиме CPU, выберите CUDA = None.
Примечание 2: Мы также предоставляем Dockerfile здесь.
Примечание 3: Опциональный детектор DBNet (detect_network='dbnet18') компилирует свои C++/CUDA-операции при первом использовании, для чего требуется инструмент сборки Ninja. Чтобы установить его вместе с EasyOCR, используйте pip install "easyocr[dbnet]".
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
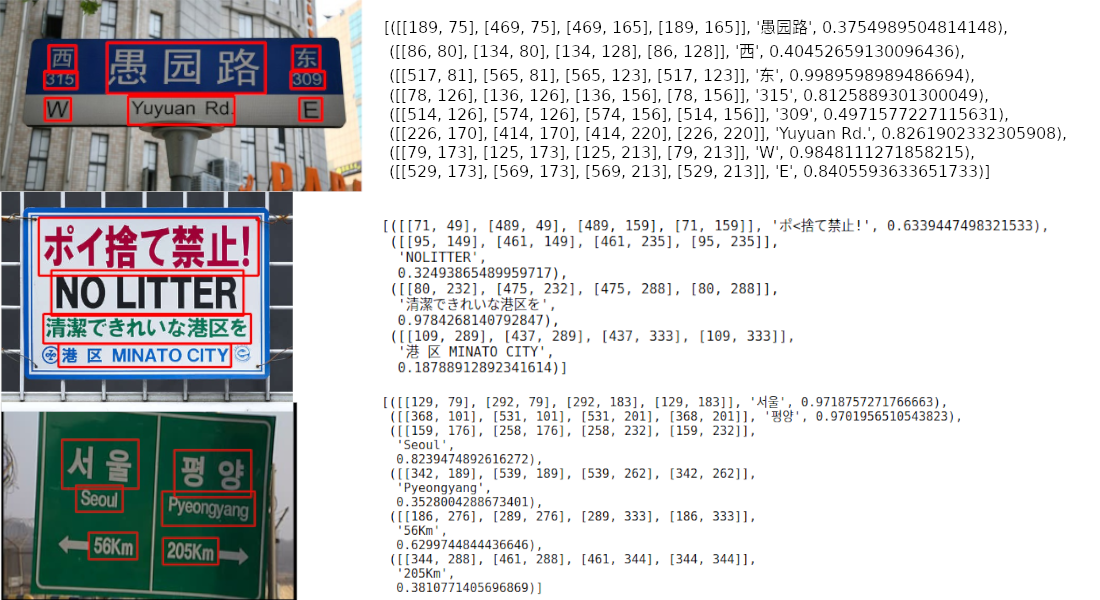
Результат будет представлен в виде списка, где каждый элемент содержит ограничивающую рамку, распознанный текст и уровень уверенности соответственно.
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
Примечание 1: ['ch_sim','en'] — это список языков, которые вы хотите распознавать. Можно передать несколько языков одновременно, но не все языки могут использоваться вместе. Английский совместим с любым языком, а языки, имеющие общие символы, обычно совместимы друг с другом.
Примечание 2: Вместо пути к файлу chinese.jpg можно также передать объект изображения OpenCV (массив numpy) или файл изображения в виде байтов. URL-адрес исходного изображения также допустим.
Примечание 3: Строка reader = easyocr.Reader(['ch_sim','en']) служит для загрузки модели в память. Это занимает некоторое время, но выполнять её нужно только один раз.
Вы также можете задать detail=0 для более простого вывода.
reader.readtext('chinese.jpg', detail = 0)
Результат:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
Веса модели для выбранного языка будут загружены автоматически, или вы можете загрузить их вручную из model hub и поместить в папку '~/.EasyOCR/model'
Если у вас нет GPU или ваша GPU имеет мало памяти, вы можете запустить модель в режиме только CPU, добавив gpu=False.
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
Дополнительную информацию см. в руководстве и документации API.
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
Для модели распознавания читайте здесь.
Для модели обнаружения (CRAFT) читайте здесь.
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
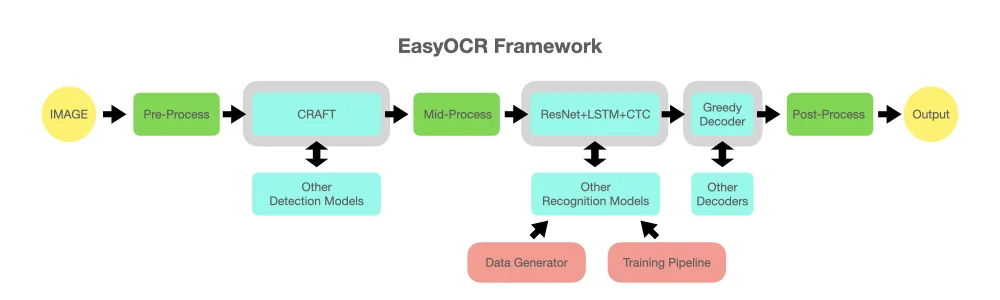
Идея состоит в том, чтобы иметь возможность подключить любую современную модель к EasyOCR. Есть много гениев, пытающихся создать лучшие модели обнаружения/распознавания, но мы не пытаемся быть гениями здесь. Мы просто хотим сделать их работы быстро доступными для общественности... бесплатно. (что ж, мы верим, что большинство гениев хотят, чтобы их работа создавала положительный эффект как можно быстрее/масштабнее) Пайплайн должен быть примерно таким, как на диаграмме ниже. Серые слоты — это заполнители для сменных светло-синих модулей.
Этот проект основан на исследованиях и коде из нескольких статей и open-source репозиториев.
Всё выполнение глубокого обучения основано на Pytorch. ❤️
Выполнение обнаружения использует алгоритм CRAFT из этого официального репозитория и их статьи (Спасибо @YoungminBaek из @clovaai). Мы также используем их предобученную модель. Скрипт обучения предоставлен @gmuffiness.

