 hpthreatresearch/subcrawl
Модульная платформа для обнаружения и анализа открытых каталогов в интернете. Сканирует URL-адреса, извлекает содержимое, применяет сканирование YARA/ClamAV и выводит результаты в MISP, SQLite или консоль для анализа угроз.

SubCrawl — это фреймворк, разработанный Патриком Шлепфером, Джошем Штрошайном и Алексом Холландом из команды Threat Research компании HP Inc. SubCrawl предназначен для поиска, сканирования и анализа открытых директорий. Фреймворк модульный и состоит из четырёх компонентов: модулей ввода, модулей обработки, модулей вывода и основного движка сканирования. Основными входными значениями являются URL-адреса, которые фреймворк разбирает и добавляет в систему очередей перед сканированием. Разбор URL-адресов — важный первый шаг: он берёт переданный URL и генерирует дополнительные URL-адреса для сканирования, последовательно удаляя поддиректории, пока таковых не останется. Этот процесс обеспечивает более полную попытку сканирования веб-сервера и может привести к обнаружению дополнительного контента. Важно отметить, что SubCrawl не использует метод перебора для обнаружения URL-адресов. Весь сканируемый контент поступает из входных URL-адресов, процесса разбора URL и обнаружения во время сканирования. Когда обнаруживается открытая директория, движок сканирования извлекает из неё ссылки для оценки. Движок определяет, является ли ссылка другой директорией или файлом. Директории добавляются в очередь сканирования, а файлы подвергаются дополнительному анализу модулями обработки. Результаты генерируются и сохраняются для каждого сканированного URL, например, SHA256 и нечёткие хеши содержимого, информация о том, была ли найдена открытая директория, или совпадения с правилами YARA. Наконец, данные результатов обрабатываются одним или несколькими модулями вывода, которых на данный момент три. Первый обеспечивает интеграцию с MISP, второй просто выводит данные в консоль, а третий сохраняет данные в базу SQLite. Поскольку фреймворк модульный, легко не только настроить нужные модули ввода, обработки и вывода, но и разработать новые модули.
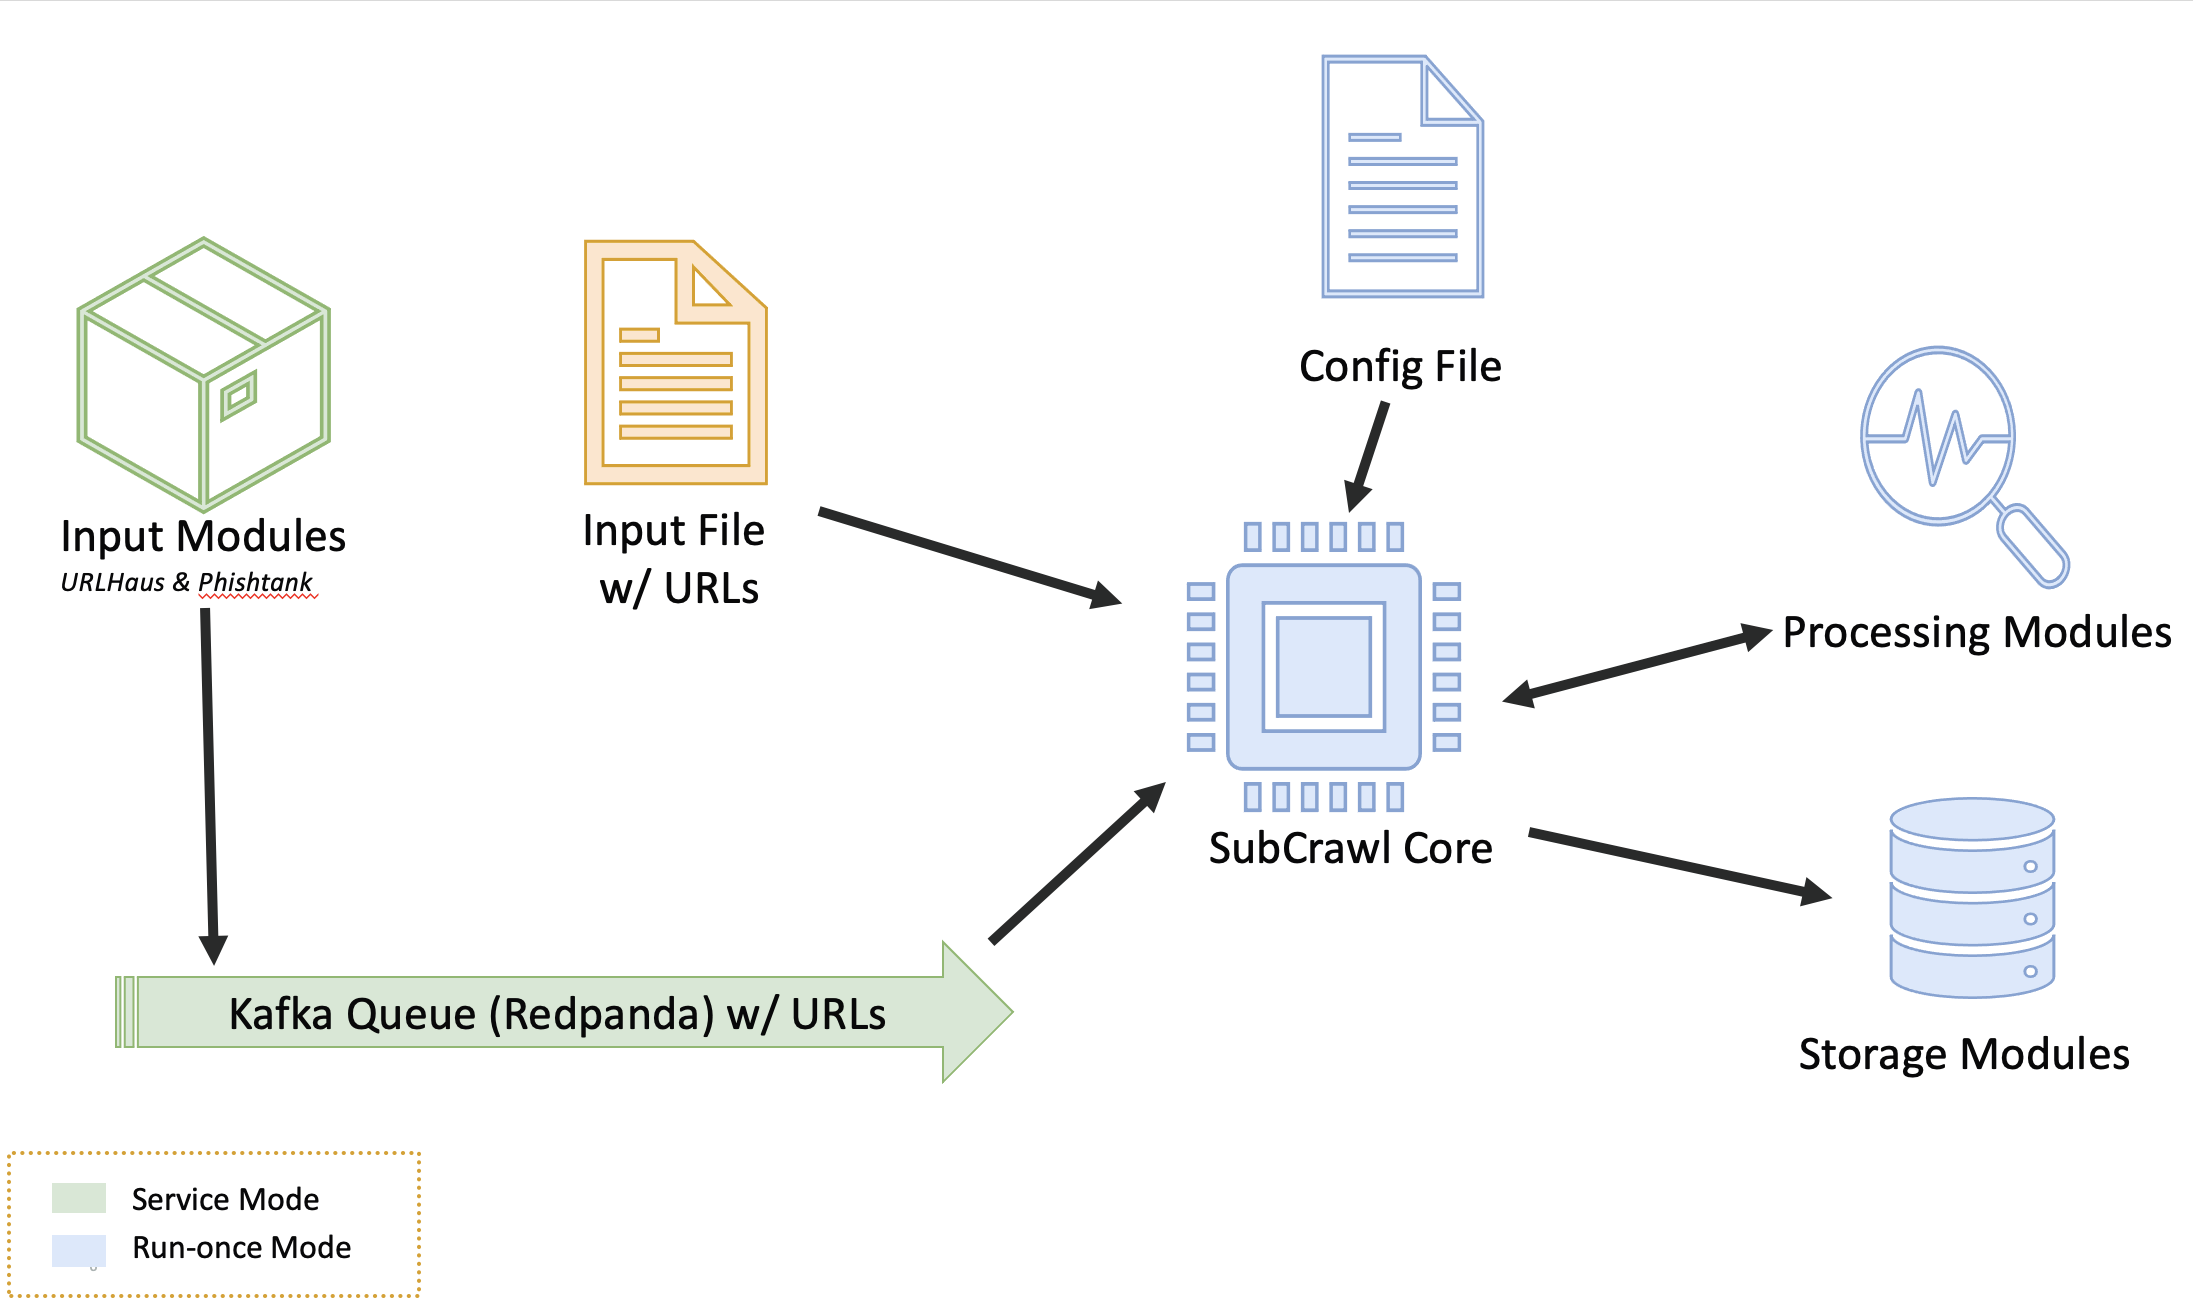 Рисунок 1 — Архитектура SubCrawl
SubCrawl поддерживает два различных режима работы. Во-первых, SubCrawl можно запустить в режиме однократного выполнения. В этом режиме пользователь предоставляет URL-адреса для сканирования в файле, где каждое входное значение отделяется разрывом строки. Второй режим — сервисный. В этом режиме SubCrawl работает в фоновом режиме и полагается на модули ввода для предоставления URL-адресов для сканирования. На рисунке 1 показан обзор архитектуры SubCrawl. Компоненты, используемые в обоих режимах работы, окрашены в синий цвет, компоненты режима однократного выполнения — в жёлтый, а компоненты сервисного режима — в зелёный.
В зависимости от выбранного режима выполнения необходимо выполнить и другие предварительные условия.
SubCrawl написан на Python3. Кроме того, перед запуском SubCrawl требуется несколько пакетов. Для установки всех необходимых пакетов можно использовать следующую команду. Выполните её из каталога crawler:
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
Если SubCrawl запускается в сервисном режиме, это можно сделать с помощью Docker. Поэтому требуется установка Docker и Docker Compose. Подходящие инструкции по установке можно найти на сайте Docker.com.
SubCrawl имеет встроенную справку через аргумент -h/--help или при простом выполнении скрипта без аргументов.
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ Harvesting the Open Web ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
Этот режим подходит, если вы хотите быстро просканировать небольшое количество доменов. Для этого URL-адреса для сканирования необходимо сохранить в файле, который затем служит входными данными для сканера. Ниже приведён пример выполнения в режиме однократного выполнения: обратите внимание на использование аргумента -f с путём к файлу.
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
С помощью сервисного режима можно сканировать большее количество доменов и сохранять результаты. В зависимости от выбранного модуля хранения данные можно затем более подробно анализировать и оценивать. Чтобы сделать запуск сервисного режима как можно более простым для пользователя, мы встроили все функциональные возможности в образ Docker. В сервисном режиме домены для сканирования получаются через модули ввода. По умолчанию новые вредоносные URL-адреса и фишинговые URL-адреса загружаются с URLhaus и PhishTank и ставятся в очередь на сканирование. Нужные модули обработки и хранения можно указать непосредственно в config.yml. По умолчанию активированы следующие модули обработки, использующие хранилище SQLite:
В дополнение к модулю хранения SQLite был разработан простой веб-интерфейс, позволяющий просматривать и управлять сканированными доменами и URL-адресами.
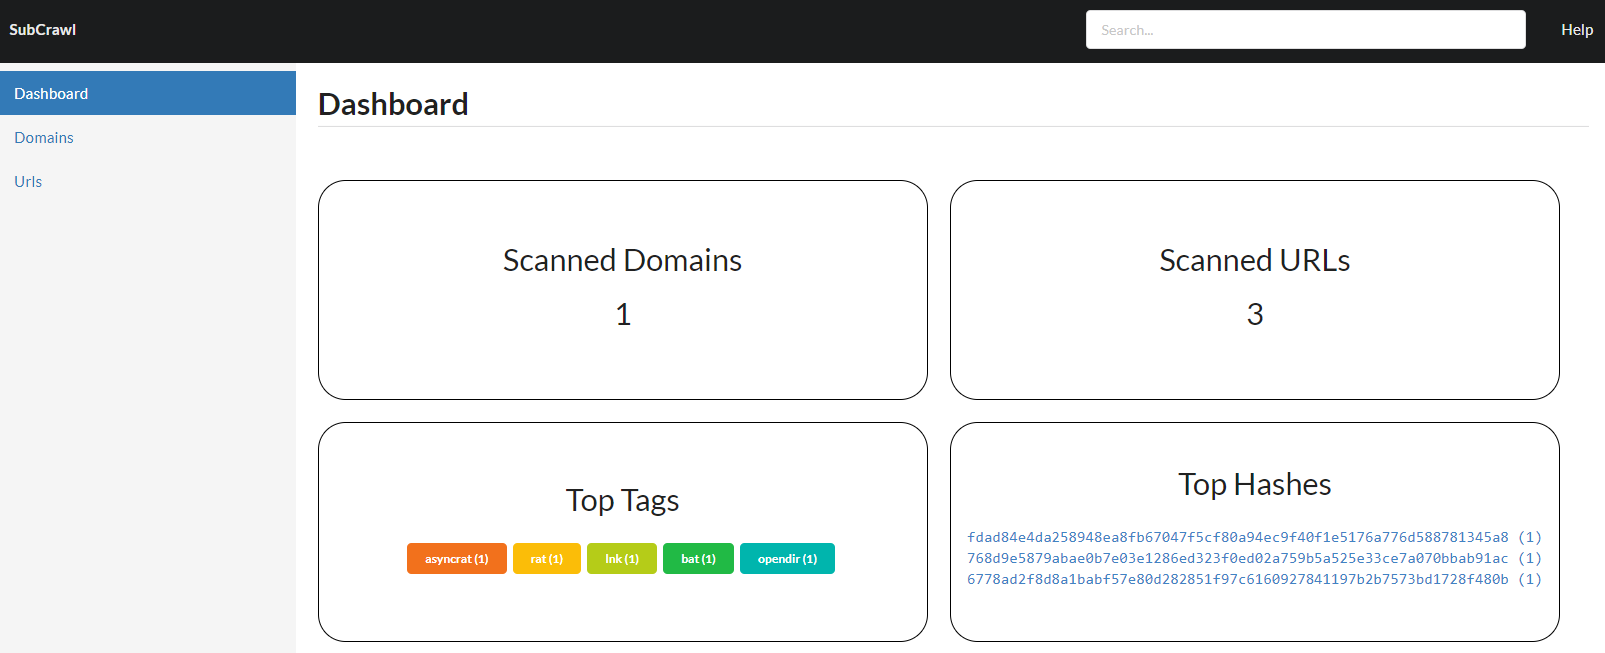
Однако, если этого интерфейса недостаточно для последующей оценки данных, можно альтернативно или дополнительно активировать модуль хранения MISP. Соответствующие настройки необходимо выполнить в config.yml в разделе MISP.
Следующих двух команд достаточно, чтобы клонировать GIT-репозиторий, создать контейнер Docker и сразу его запустить. После этого веб-интерфейс будет доступен по адресу https://localhost:8000/. Обратите внимание: после запуска контейнеров модули ввода начнут добавлять URL-адреса в очередь обработки, а движок начнёт сканирование хостов.
git clone https://github.com/hpthreatresearch/subcrawl.git

docker-compose up --build
Модули ввода используются только в сервисном режиме. Если SubCrawl запущен в режиме однократного выполнения, необходимо предоставить файл с URL-адресами для сканирования. Реализованы следующие два модуля ввода.
