 hoodoer/colonelclustered
Java-плагин для Burp, который выполняет кластеризацию текста ответов для выявления выбросов/групп на основе фактического содержимого ответов сервера, например, из запуска Intruder.

Расширение Burp Suite для кластеризации HTTP-ответов с целью поиска выбросов.
Это плагин, о котором я думал много лет, просто потому что меня умеренно раздражает то, как мы анализируем результаты фаззинг-атак в Burp Intruder. Обычно мы ищем изменения в ответах сервера во время фаззинг-атак. И мы ищем эти различия, глядя на коды состояния, время ответа и размер ответа. Всё это — косвенные показатели содержимого ответа. Конечно, как пентестеры, мы не можем тратить время на чтение содержимого тысяч ответов сервера в поисках различий в содержимом. Но, безусловно, мы можем поручить это алгоритмам.
Вот тут и появляется этот плагин. Он использует методы кластеризации текста для анализа содержимого ответов и распределяет их по кластерам на основе схожести. Это даёт вам ещё один способ просмотра результатов фаззинг-атак в Intruder и быстрого выявления тех ответов сервера, которые отличаются.
Colonel Clustered предоставляет два различных алгоритма для кластеризации ответов. Алгоритм по умолчанию работает относительно быстро, а дополнительный алгоритм глубокого анализа отлично справляется с поиском выбросов, но плохо масштабируется. Впрочем, ни один из них не масштабируется хорошо — я бы поостерёгся отправлять в этот плагин 50 тысяч ответов. Быстрый/стандартный алгоритм имеет сложность O(n^2), тогда как алгоритм глубокого анализа — O(n^3). Учитывайте это, когда будете отправлять результаты Intruder на обработку.
Токенизация с учётом содержимого: Расширение сначала проверяет заголовок Content-Type каждого ответа, чтобы применить наиболее подходящую стратегию токенизации:
Предварительная группировка: Чтобы оставаться быстрым даже при тысячах ответов, расширение выполняет один проход для группировки всех абсолютно идентичных ответов. Оно вычисляет хеш набора токенов каждого ответа и группирует все элементы с одинаковым хешем. Это означает, что дорогостоящий алгоритм кластеризации запускается только на гораздо меньшем наборе уникальных тел ответов.
Два алгоритма кластеризации: Colonel Clustered предлагает два различных алгоритма кластеризации:
Fast Scan (по умолчанию): Высокопроизводительный алгоритм на основе DBSCAN запускается автоматически, когда вы отправляете несколько запросов/ответов в расширение.
Deep Analysis (ручной запуск): Оригинальный, более вычислительно затратный алгоритм иерархической кластеризации доступен через кнопку "Deep Analysis". Этот вариант предназначен для сценариев, требующих более детального и потенциально иного взгляда на кластеризацию, используя Average Linkage для улучшенной связности кластеров.
Консолидация выбросов: После кластеризации любая группа, содержащая только одного уникального члена, считается выбросом. Все такие выбросы затем объединяются в единую удобную группу "Outliers" в интерфейсе.
Эти два алгоритма должны обеспечить простой способ автоматического выявления ответов сервера, различающихся по содержимому, даже когда размер ответа является ненадёжным показателем различий.
Загрузка расширения:
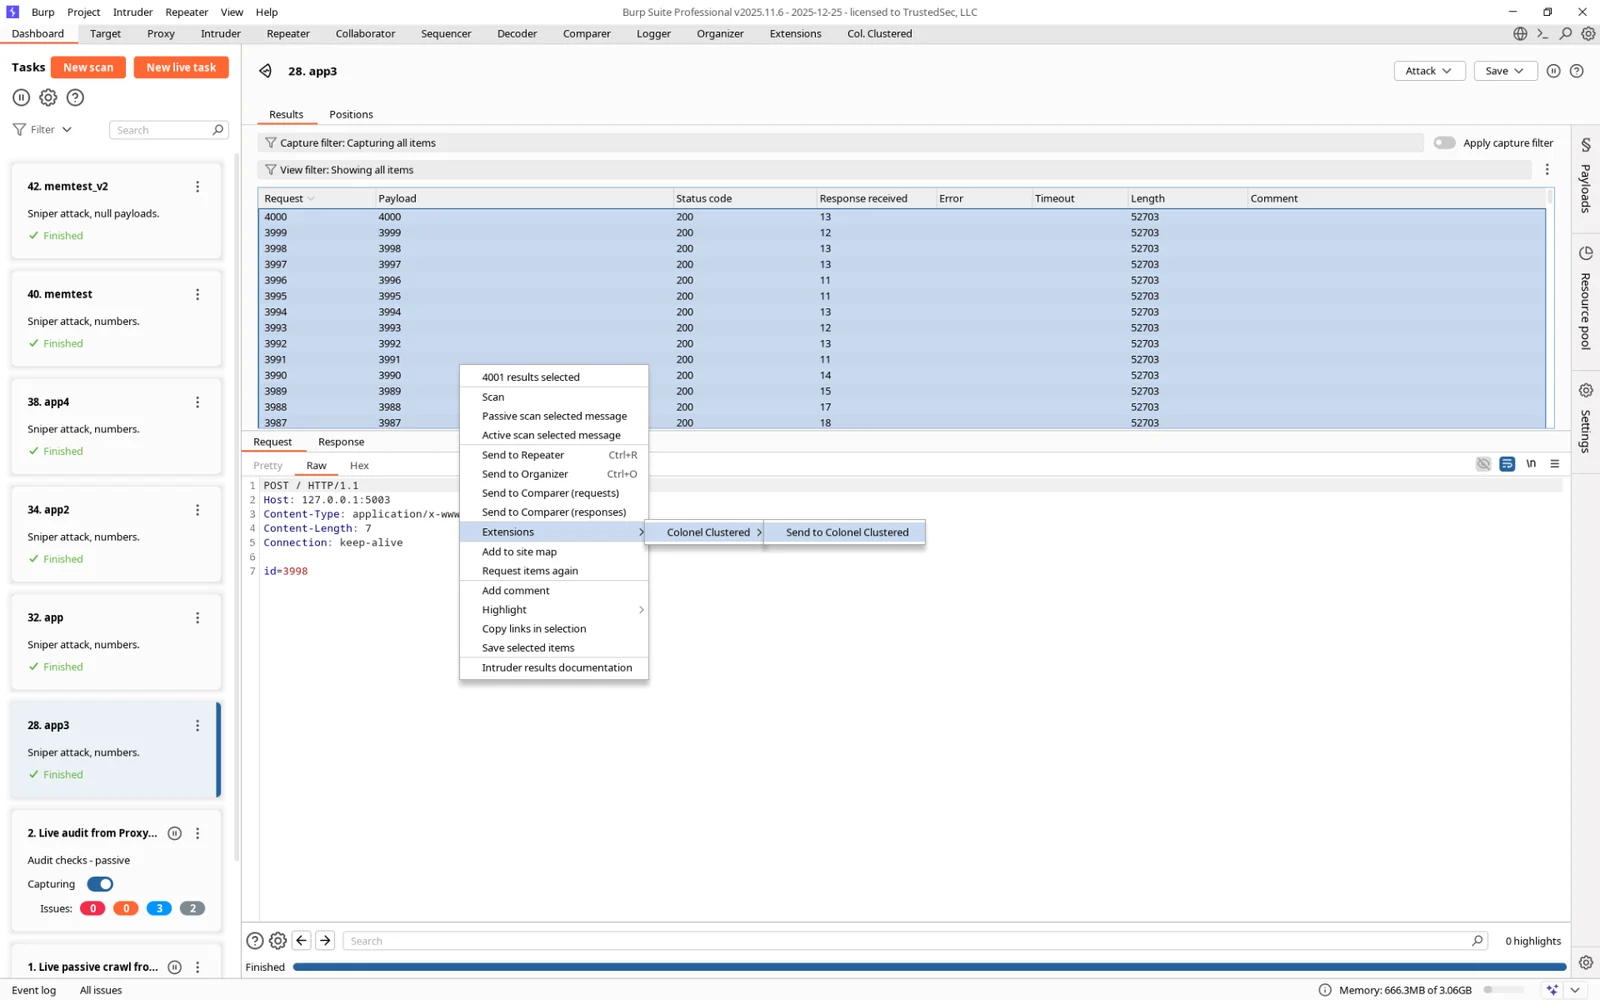
Отправка ответов на анализ:
Выполнение глубокого анализа (опционально):
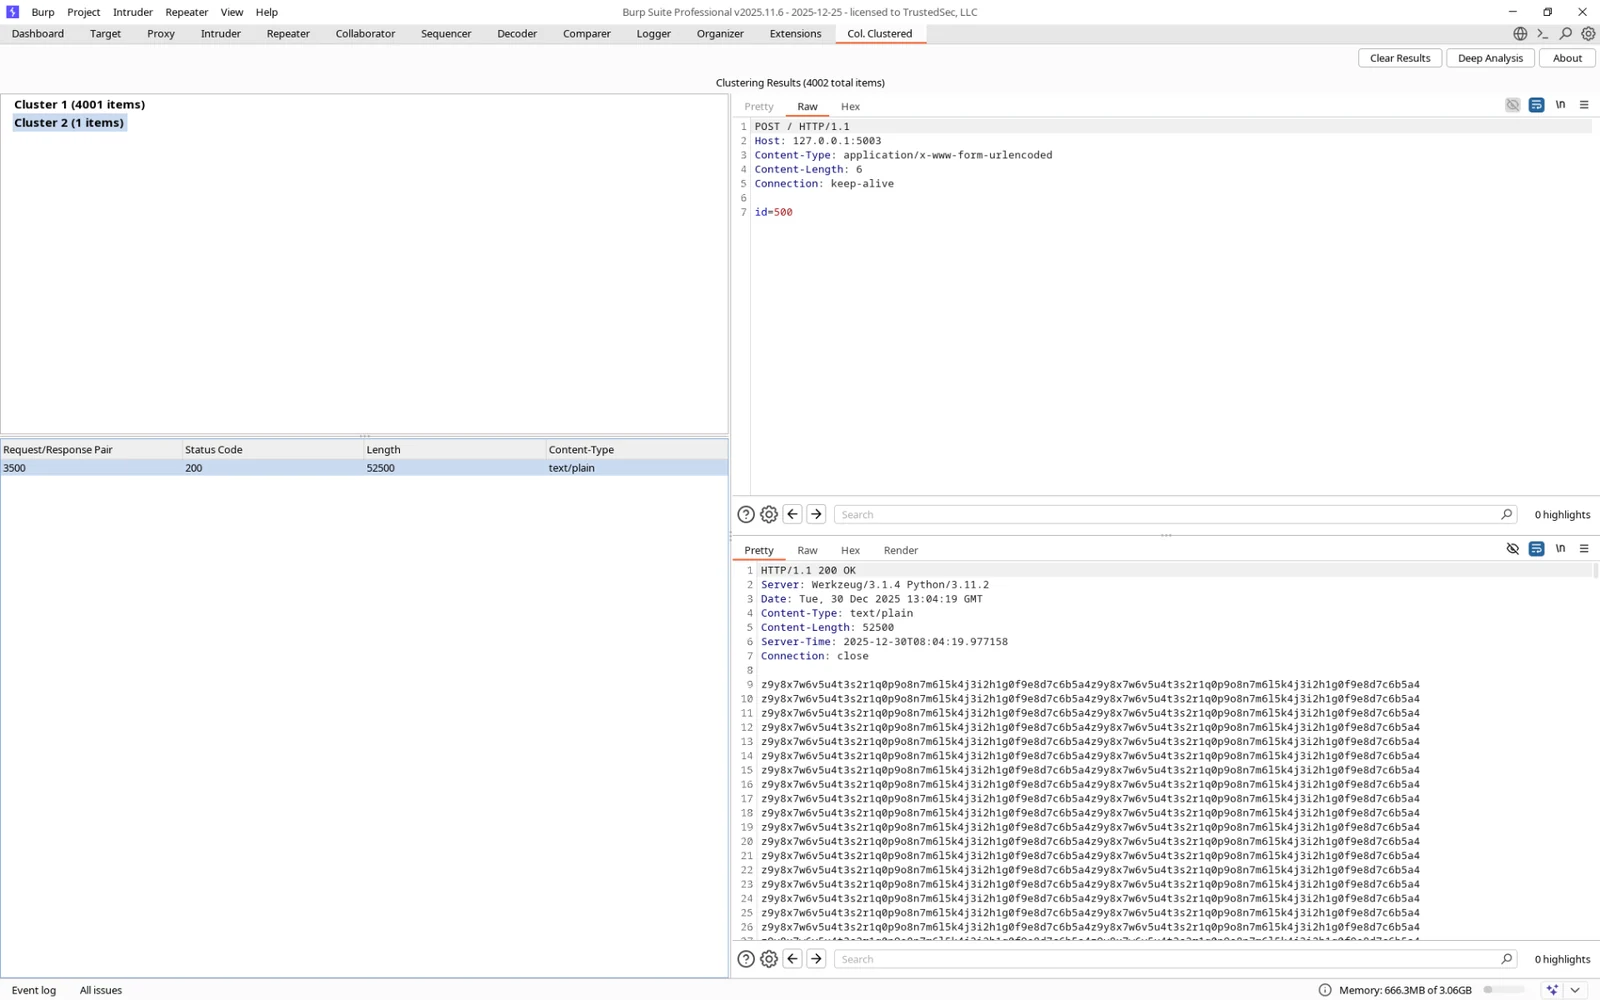
Анализ результатов в четырёхпанельном интерфейсе:
Request/Response Pair: Исходный индекс элемента.Status Code: Код состояния HTTP-ответа.Length: Длина тела ответа в байтах.Content-Type: Заголовок Content-Type ответа.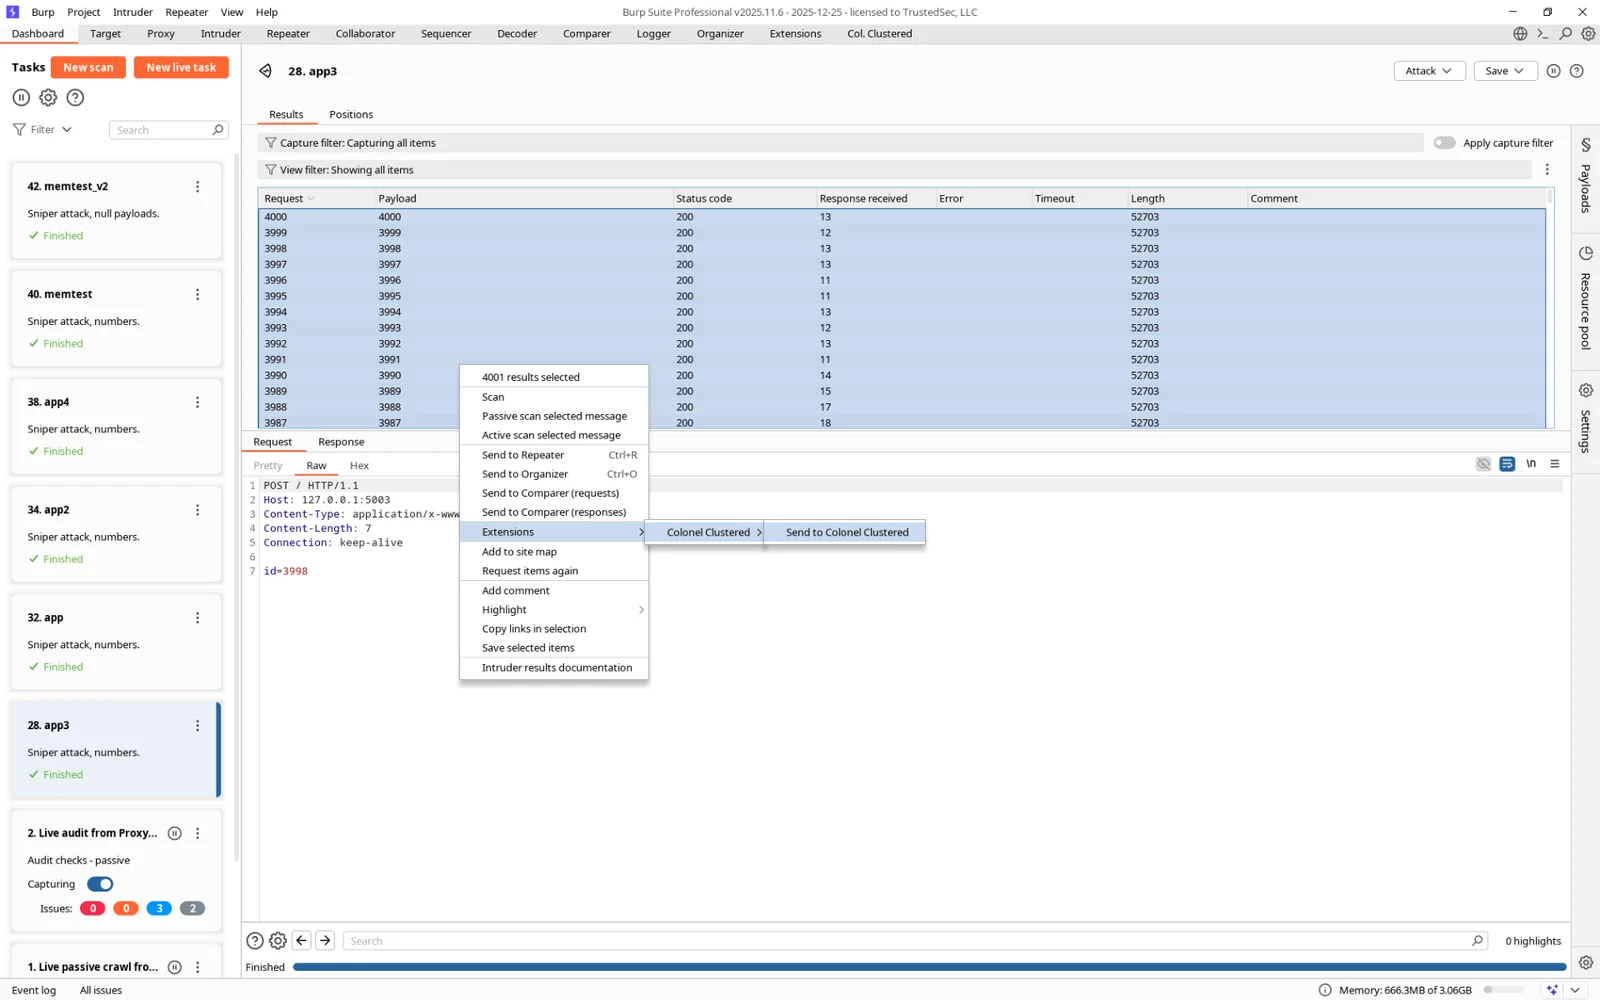
Этот проект использует Gradle. Для сборки плагина требуется установленный JDK версии 17.
git clone <repository-url>
cd ColonelClustered
./gradlew build
build/libs/ColonelClustered.jar.Drew Kirkpatrick
@hoodoer
[email protected]
Вы можете найти меня в Blackthorne Consulting.
Этот проект выпущен в общественное достояние под лицензией Unlicense. Подробности см. в файле LICENSE.
