 hahwul/urx
Извлекает URL-адреса из архивов OSINT для аналитики безопасности

Извлекает URL-адреса из OSINT-архивов для анализа безопасности.



Urx — это инструмент командной строки, предназначенный для сбора URL-адресов из OSINT-архивов, таких как Wayback Machine и Common Crawl. Написанный на Rust для обеспечения эффективности, он использует асинхронную обработку для быстрого опроса нескольких источников данных. Этот инструмент упрощает процесс сбора информации об URL-адресах для указанного домена, предоставляя исчерпывающий набор данных, который может быть использован для различных целей, включая тестирование безопасности и анализ.
--cdx-endpoint URL, без изменения кода-H, --cookie и --user-agent применяются к каждому запросу, который urx делает к цели (--check-status, --extract-links, --extract-js-endpoints, --expand-specs), и намеренно никогда не отправляются в архив--match-regex / --filter-regex)--meta-*): фильтрация по дате первого/последнего захвата, записанному MIME-типу и записанному статусу единообразно для каждого провайдера, после сбораurx example.com/shop передаёт область в сам CDX-запрос (url=example.com/shop*), поэтому поддерево большого сайта стоит лишь часть всего индекса вместо фильтрации на стороне клиента--scope-file): собственный список *.example.com / !admin.example.com программы, используемый дословно, повторяемый и объединяемый, при этом исключения всегда побеждают--dedup-similar)wordlist — сегменты пути и имена параметров, из которых построена цель, без идентификаторов, хешей и дат--params (полный перечень параметров цели), --params-by-endpoint (какой эндпоинт принимает что) и --fuzz-placeholder FUZZ (один шаблонный URL на каждую сигнатуру параметра, готовый для ffuf или dalfox)first_seen, last_seen, mime, archive_status и digest возвращаются с каждым URL-адресом, о котором сообщил CDX-архив, без дополнительных сетевых затрат--stream): URL-адреса записываются по мере их сообщения каждым провайдером, поэтому конвейер начинает работать немедленно, вместо ожидания самого медленного архива--archive-body), чтобы страницы, которых больше не существует, всё ещё отдавали содержавшиеся в них ссылки — один запрос на каждое отдельное тело, благодаря дедупликации по CDX-дайджесту--extract-js-endpoints извлекайте также из архивного JavaScript: бандл, названный по хешу сборки, отдаёт 404 в момент повторного развёртывания сайта, и архив — единственное место, где его API-поверхность всё ещё существует--archive-body-dir) как корпус для поиска того, что не ищет ни один извлекатель ссылок — комментариев разработчиков, встроенных учётных данных, внутренних имён хостов — без дополнительных запросов--expand-specs): документы OpenAPI 3.x, Swagger 2.0 и GraphQL introspection, в формате JSON или YAML, превращаются в каждый описанный ими маршрут — один запрос даёт всю документированную поверхность--check-status также записывает Location, Content-Length и Content-Type, а --check-title добавляет HTML <title>--archived-discovery): каждая отдельная версия, которую хранит Wayback Machine, поэтому Disallow: от 2015 года всё ещё называет пути, о которых сайт с тех пор перестал упоминатьurx cache для просмотра и обслуживания кэша: stats, list, prune, drop <domain>, clear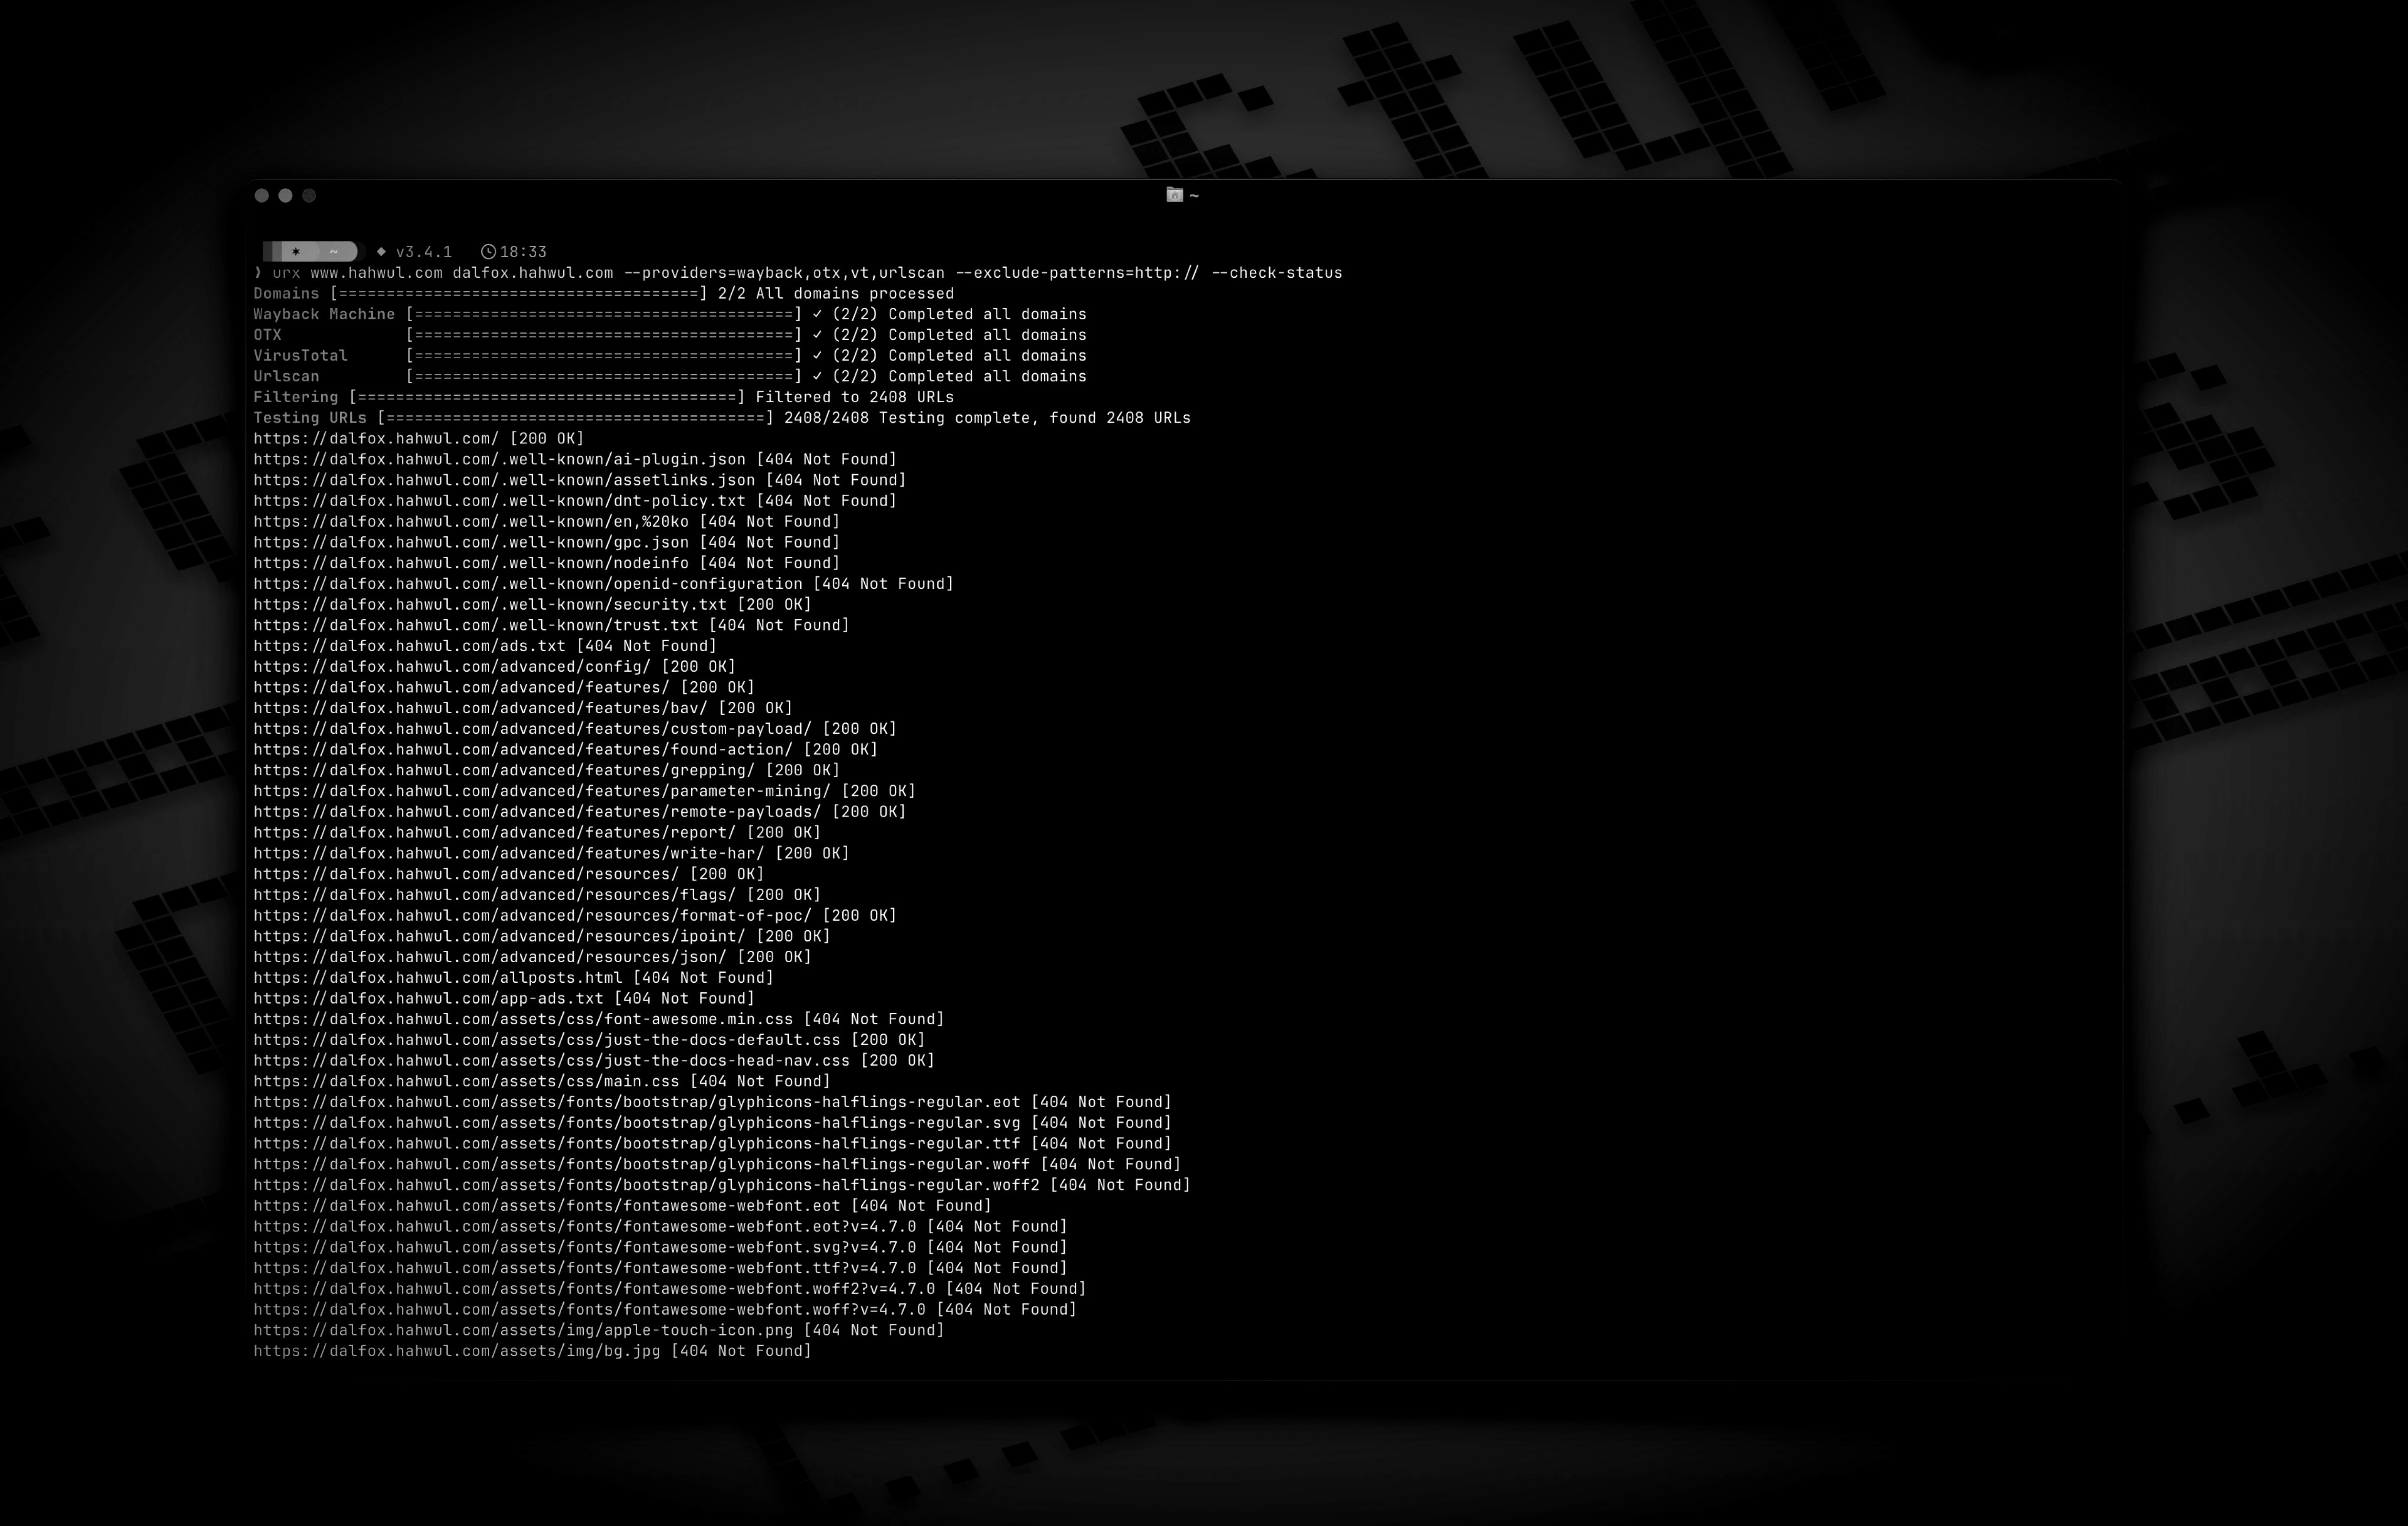
cargo install urx
### Из Homebrew```bash
# https://formulae.brew.sh/formula/urx
brew install urx
git clone https://github.com/hahwul/urx.git cd urx cargo build --release
Скомпилированный бинарный файл будет доступен по пути `target/release/urx`.

### Из Docker

[ghcr.io/hahwul/urx](https://github.com/hahwul/urx/pkgs/container/urx)

### Автодополнение для оболочки
