 edoardottt/cariddi
Возьмите список доменов, обойдите URL-адреса и выполните поиск конечных точек, секретов, ключей API, расширений файлов, токенов и многого другого.

Возьмите список доменов, обойдите URL-адреса и просканируйте на наличие эндпоинтов, секретов, API-ключей, расширений файлов, токенов и многого другого

Написано с 💙 от edoardottt
Поделиться в Twitter!
Установка • Использование • Начало работы • История изменений • Участие в разработке • Лицензия
brew install cariddi
sudo snap install cariddi
go install -v github.com/edoardottt/cariddi/cmd/cariddi@latest
pacman -Syu cariddi
nix-shell -p cariddi
Вам потребуется Go (>=1.24.0)
git clone https://github.com/edoardottt/cariddi.git
cd cariddi
go get ./...
make linux # (to install)
make unlinux # (to uninstall)
Одной строкой: git clone https://github.com/edoardottt/cariddi.git && cd cariddi && go get ./... && make linux
Обратите внимание, что исполняемый файл работает только в папке cariddi.
git clone https://github.com/edoardottt/cariddi.git
cd cariddi
go get ./...
.\make.bat windows # (to install)
.\make.bat unwindows # (to uninstall)
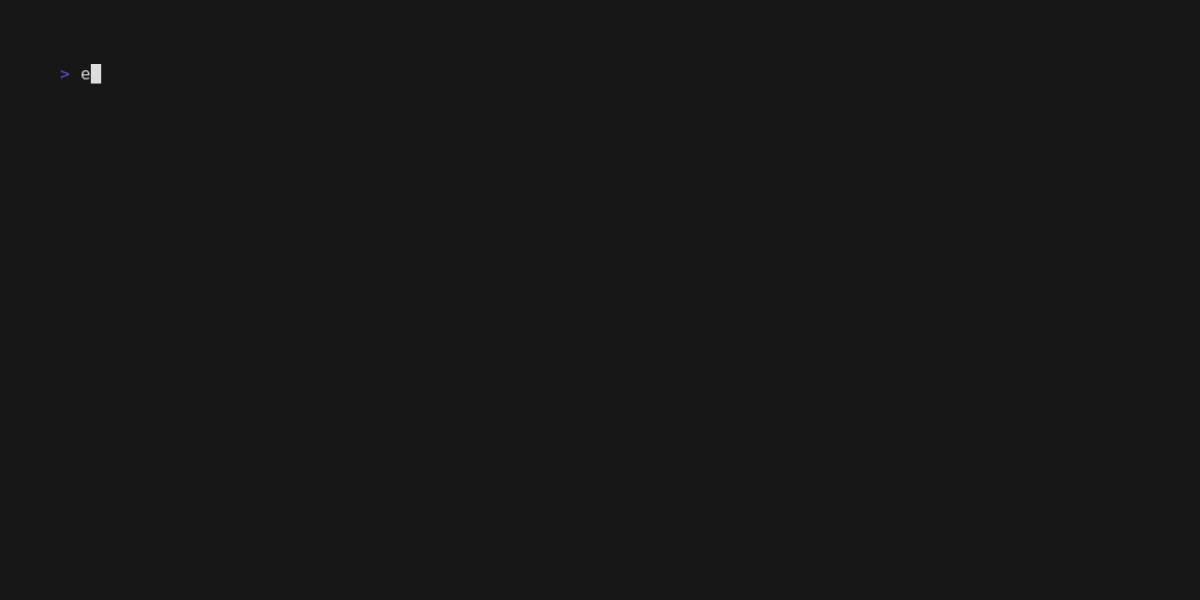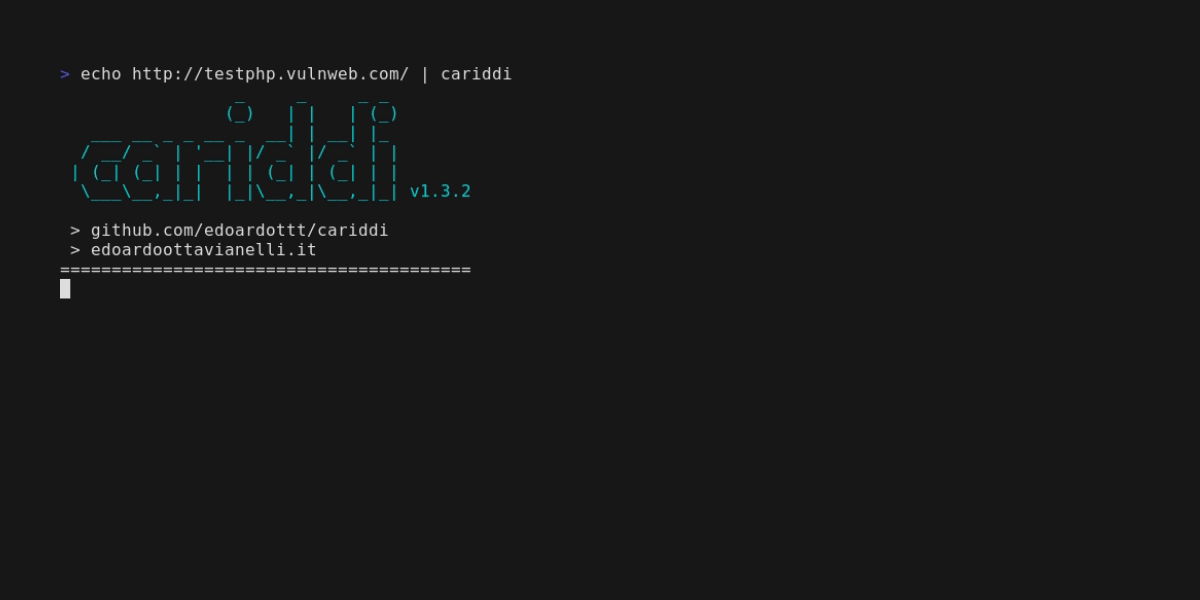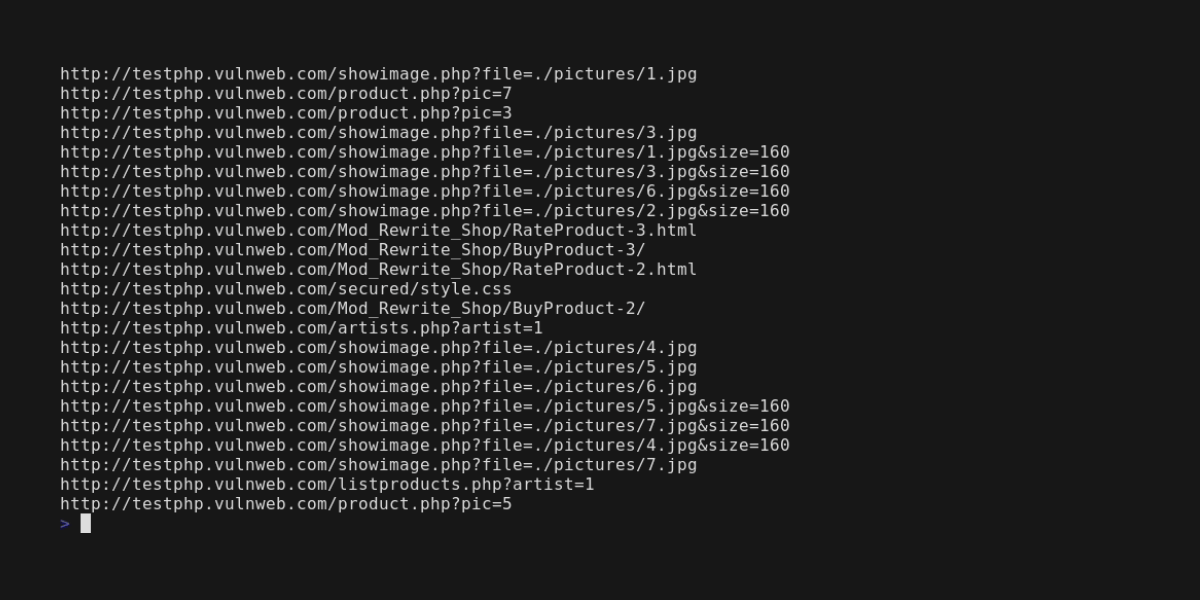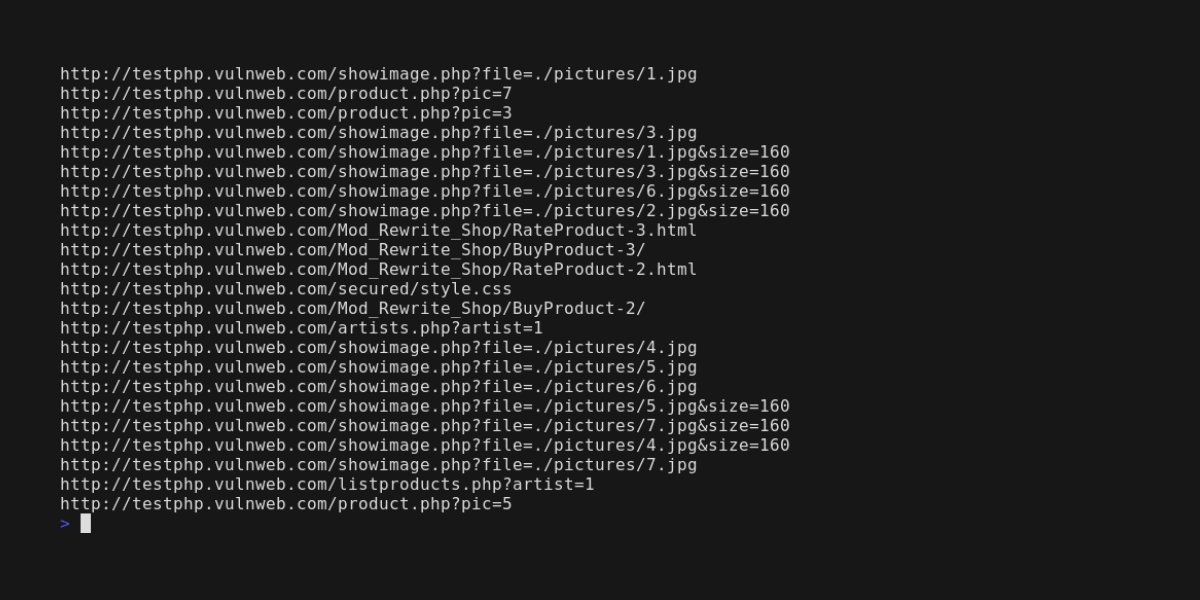
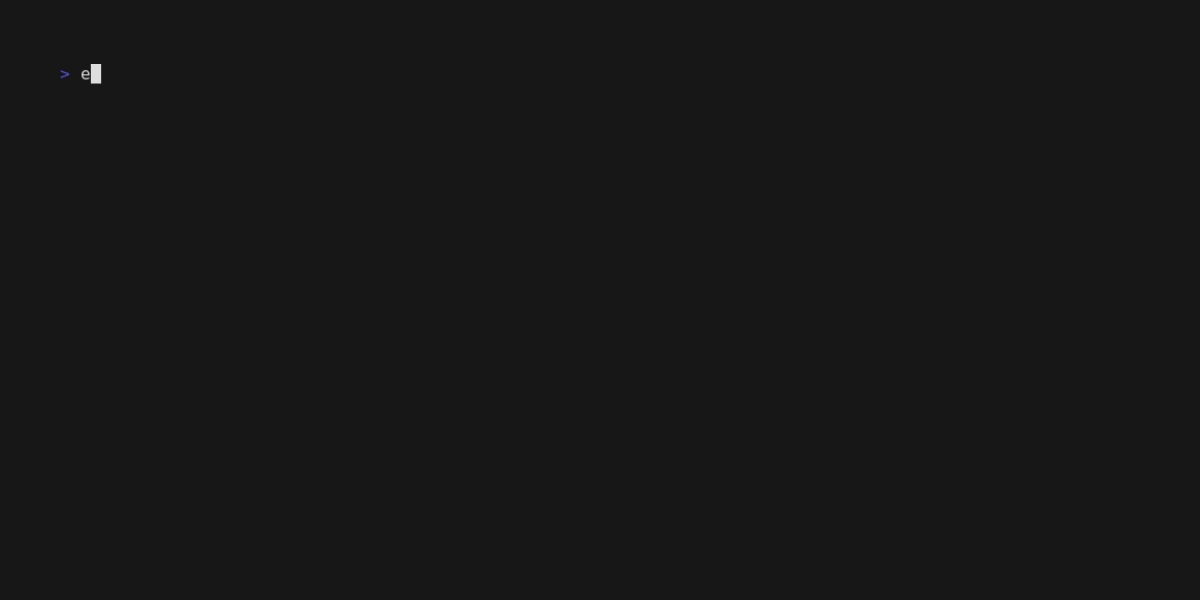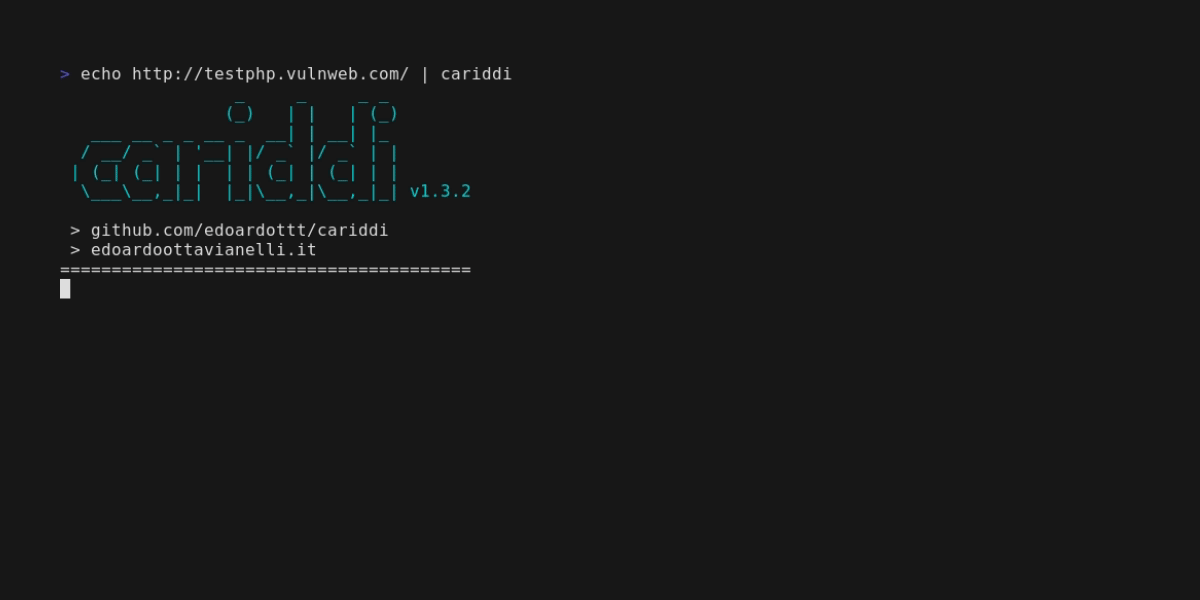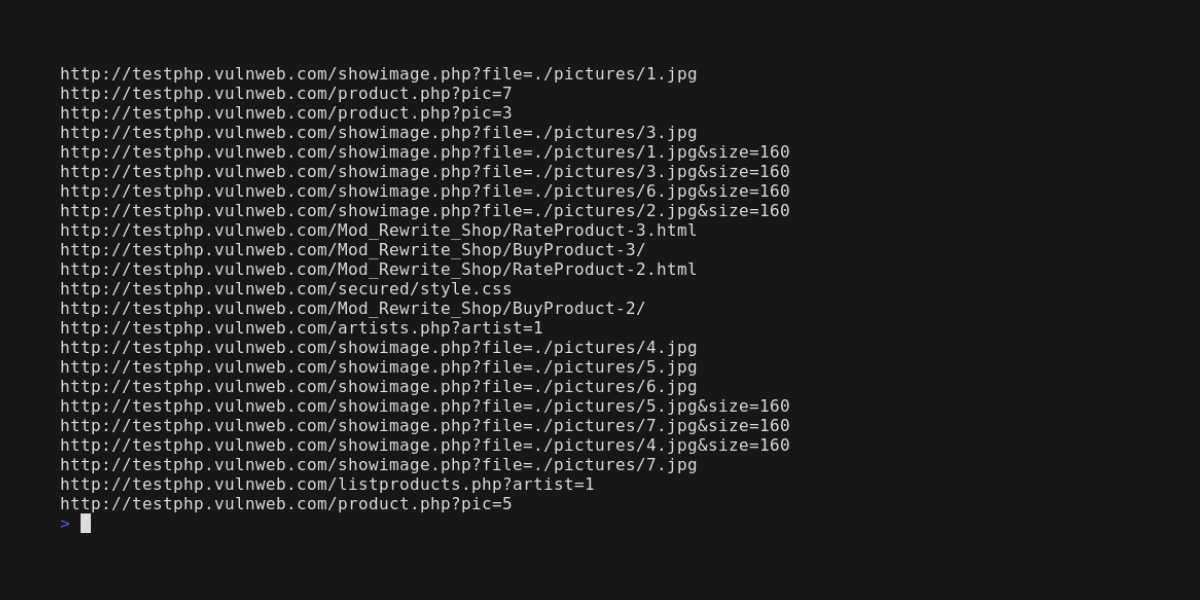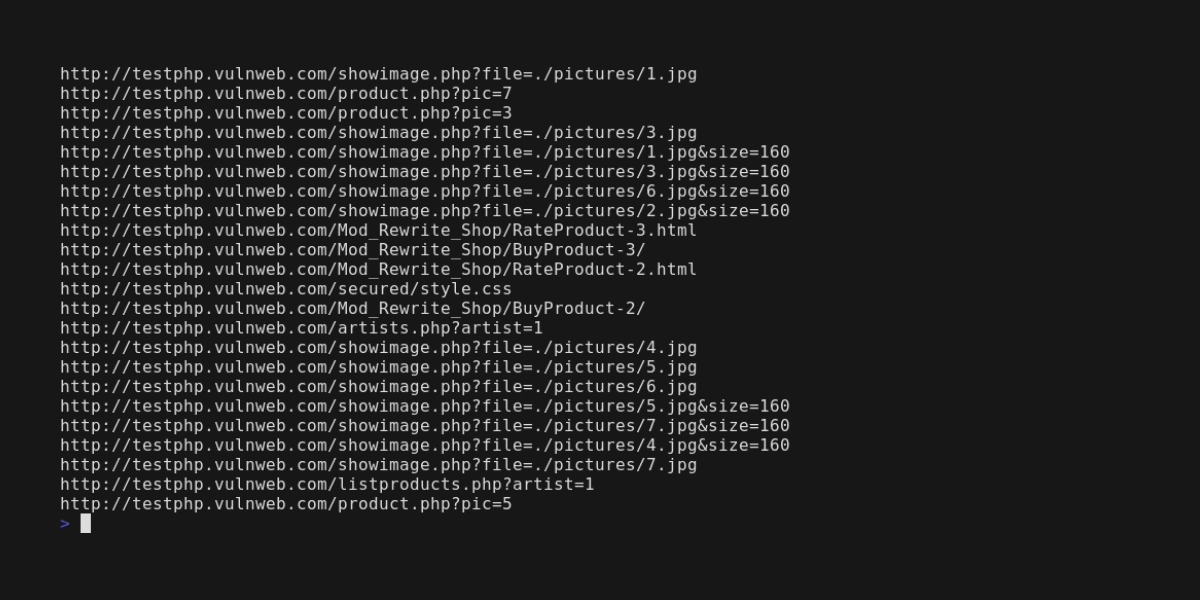
Если вы хотите просканировать только одну цель, вы можете использовать
echo https://edoardottt.com/ | cariddi
Для нескольких целей вы можете использовать файл, например urls.txt, содержащий:
https://edoardottt.com/
http://testphp.vulnweb.com/
Для Windows:
powershell.exe -Command "cat urls.txt | .\cariddi.exe" в командной строкеcat urls.txt | cariddi.exe в PowerShellcariddi -version (Вывести версию)cariddi -h (Вывести справку)cariddi -examples (Вывести примеры)cat urls.txt | cariddi -intensive (Обход с поиском также поддоменов, то же самое, что *.target.com)cat urls.txt | cariddi -s (Поиск секретов)cat urls.txt | cariddi -err (Поиск ошибок на веб-сайтах)cat urls.txt | cariddi -e (Поиск интересных эндпоинтов)cat urls.txt | cariddi -info (Поиск полезной информации на веб-сайтах)cat urls.txt | cariddi -ext 2 (Поиск интересных (уровень 2 из 7) файлов)cat urls.txt | cariddi -e -ef endpoints_file (Поиск пользовательских эндпоинтов)cat urls.txt | cariddi -s -sf secrets_file (Поиск пользовательских секретов)cat urls.txt | cariddi -ie pdf,png,jpg (Игнорировать эти расширения при сканировании)По умолчанию: png, svg, jpg, jpeg, bmp, jfif, gif, webp, woff, woff2, ttf, tiff, tif, mp4, webm, mkv, avi, mov, flv, wmv, mp3, wav, flac, ogg, m4a, aac, ico, cur, eot, otf игнорируются при поиске секретов, информации и ошибок.
cat urls.txt | cariddi -proxy http://127.0.0.1:8080 (Установить прокси, поддерживаются http и socks5)cat urls.txt | cariddi -d 2 (2 секунды между обходом одной страницы и другой)cat urls.txt | cariddi -c 200 (Установить уровень параллелизма на 200)cat urls.txt | cariddi -i forum,blog,community,open (Игнорировать URL-адреса, содержащие эти слова)cat urls.txt | cariddi -it ignore_file (Игнорировать URL-адреса, содержащие хотя бы одну строку из входного файла)cat urls.txt | cariddi -cache (Использовать папку .cariddi_cache в качестве кэша)cat urls.txt | cariddi -t 5 (Установить тайм-аут для запросов)cat urls.txt | cariddi -headers "Cookie: auth=admin;type=2;; X-Custom: customHeader"cat urls.txt | cariddi -headersfile headers.txt (Читать пользовательские заголовки из внешнего файла)cat urls.txt | cariddi -ua "Custom User Agent" (Использовать пользовательский User Agent)cat urls.txt | cariddi -rua (Использовать случайный браузерный user agent при каждом запросе)cat urls.txt | cariddi -plain (Выводить только результаты)cat urls.txt | cariddi -ot target_name (Результаты в txt-файл)cat urls.txt | cariddi -oh target_name (Результаты в html-файл)cat urls.txt | cariddi -json (Выводить результат в формате JSON в stdout)cat urls.txt | cariddi -sr (Сохранять HTTP-ответы)cat urls.txt | cariddi -debug (Выводить отладочную информацию во время обхода)cat urls.txt | cariddi -md 3 (Максимум 3 уровня глубины)cariddi -h выводит справку.
Usage of cariddi:
  -c int
     Concurrency level. (default 20)
  -cache
     Use the .cariddi_cache folder as cache.
  -d int
     Delay between a page crawled and another.
  -debug
     Print debug information while crawling.
  -e Hunt for juicy endpoints.
  -ef string
     Use an external file (txt, one per line) to use custom parameters for endpoints hunting.
  -err
     Hunt for errors in websites.
  -examples
     Print the examples.
  -ext int
     Hunt for juicy file extensions. Integer from 1(juicy) to 7(not juicy).
  -h Print the help.
  -headers string
     Use custom headers for each request E.g. -headers "Cookie: auth=yes;;Client: type=2".
  -headersfile string
     Read from an external file custom headers (same format of headers flag).
  -json
     Print the output as JSON in stdout.
  -md
     Maximum depth level the crawler will follow from the initial target URL.
  -i string
     Ignore the URL containing at least one of the elements of this array.
  -ie value
     Comma-separated list of extensions to ignore while scanning.
  -info
     Hunt for useful informations in websites.
  -intensive
     Crawl searching for resources matching 2nd level domain.
  -it string
     Ignore the URL containing at least one of the lines of this file.
  -oh string
     Write the output into an HTML file.
  -ot string
     Write the output into a TXT file.
  -plain
     Print only the results.
  -proxy string
     Set a Proxy to be used (http and socks5 supported).
  -rua
     Use a random browser user agent on every request.
  -s Hunt for secrets.
  -sf string
     Use an external file (txt, one per line) to use custom regexes for secrets hunting.
  -sr
     Store HTTP responses.
  -t int
     Set timeout for the requests. (default 10)
  -ua string
     Use a custom User Agent.
  -version
     Print the version.
Обычно вы используете Burpsuite в браузере, поэтому вам достаточно доверять сертификату burpsuite в браузере, и всё готово.
Чтобы использовать cariddi с прокси BurpSuite, вам нужно выполнить несколько дополнительных шагов.
Если вы попытаетесь использовать cariddi с опцией -proxy http://127.0.0.1:8080, вы обнаружите эту ошибку в разделе журнала ошибок burpsuite:
