 decalage2/collisions
Коллизии хэшей и их эксплуатация

TL;DR получение MD5-коллизии этих двух изображений теперь(*) тривиально и мгновенно.
 ⟷
<a href=http://gunshowcomic.com/648>
Не играйте с огнём, не полагайтесь на MD5.
(*) Создание коллизии для любой пары файлов возможно уже много лет, но каждый раз это занимает несколько часов, без возможности ускорить процесс.
На этой странице приведены приёмы, специфичные для форматов файлов, и предвычисленные префиксы коллизий, чтобы сделать коллизию мгновенной.
git clone. Запустите скрипт. Готово.
Авторы: Ange Albertini и Marc Stevens.
Цель — всесторонне исследовать существующие атаки и заодно показать, насколько слаб MD5 (мгновенные коллизии для любых JPG, PNG, PDF, MP4, PE...) — а также детально изучить распространённые форматы файлов, чтобы определить, как их можно эксплуатировать с помощью текущих или будущих атак.
Действительно, один и тот же приём с форматом файла можно применить к нескольким хэшам (те же приёмы с JPG использовались для MD5, malicious SHA-1 и SHA1), если коллизии следуют одним и тем же байтовым шаблонам.
Этот документ не о новых атаках (самая свежая была задокументирована в 2012 году), а о новых формах эксплуатации существующих атак.
Текущий статус известных атак — по состоянию на декабрь 2018 года:
получить файл, соответствующий хэшу другого файла или заданному хэшу: невозможно
получить два разных файла с одинаковым MD5: мгновенно
сделать так, чтобы два произвольных файла имели одинаковый MD5: несколько часов (72 hours.core)
сделать так, чтобы два произвольных файла определённых форматов (PNG, JPG, PE...) имели одинаковый MD5: мгновенно
получить два разных файла с одинаковым SHA1: 6500 years.core
(*) пример с crypt — спасибо Sven!```
import crypt crypt.crypt("5dUD&66", "br") 'brokenOz4KxMc' crypt.crypt("O!>',%$", "br") 'brokenOz4KxMc'
# Атаки

MD5 и SHA1 работают с блоками по 64 байта.

Если два содержимых A и B имеют одинаковый хэш, то добавление одного и того же содержимого C к обоим сохранит одинаковый хэш.``` text
hash(A) = hash(B) -> hash(A + C) = hash(B + C)
Коллизии работают путём вставки на границе блока нескольких вычисленных блоков коллизий, количество которых зависит от того, что было в файле ранее. Эти блоки коллизий выглядят очень случайными, но с незначительными различиями (которые следуют определённому шаблону для каждой атаки) и они вносят крошечные различия, в конечном итоге приводя к одинаковому значению хеша после этих блоков.
Эти различия используются для создания корректных файлов с определёнными свойствами.
Форматы файлов также работают сверху вниз, и большинство из них работает с чанками на уровне байтов.
Некоторые «комментарные» чанки можно вставлять, чтобы выровнять чанки файла по границам блоков, выровнять конкретные структуры по различиям блоков коллизий, скрыть остальную случайность блоков коллизий от парсеров файлов, и скрыть иное корректное содержимое от парсера (чтобы он видел другое содержимое).
Эти «комментарные» чанки часто не являются официально настоящими комментариями: они просто используются как контейнеры данных, которые игнорируются парсером (например, PNG-чанки с ID, начинающимся со строчной буквы, являются вспомогательными, а не критическими).
В большинстве случаев различие в блоках коллизий используется для изменения длины комментарного чанка,
которая обычно объявляется непосредственно перед данными этого чанка:
в промежутке между меньшей и большей версиями этого чанка
объявляется ещё один комментарный чанк, чтобы перепрыгнуть через содержимое одного файла A.
После этого содержимого файла A просто добавьте другое содержимое файла B.
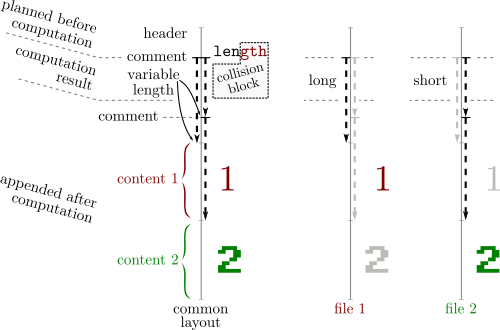
Поскольку форматы файлов обычно определяют терминатор, после которого парсеры останавливаются,
A завершит разбор, из-за чего добавленное содержимое B будет проигнорировано.
Поэтому обычно требуется как минимум два комментария — часто три:
