 corelight/zeek2es
Приложение на Python для фильтрации и передачи логов Zeek в Elastic/OpenSearch+Humio. Это приложение также может выводить чистые JSON-логи в stdout для дальнейшей обработки!

Это приложение на Python преобразует логи Zeek в форматах ASCII TSV и JSON в формат массовой загрузки JSON для ElasticSearch.
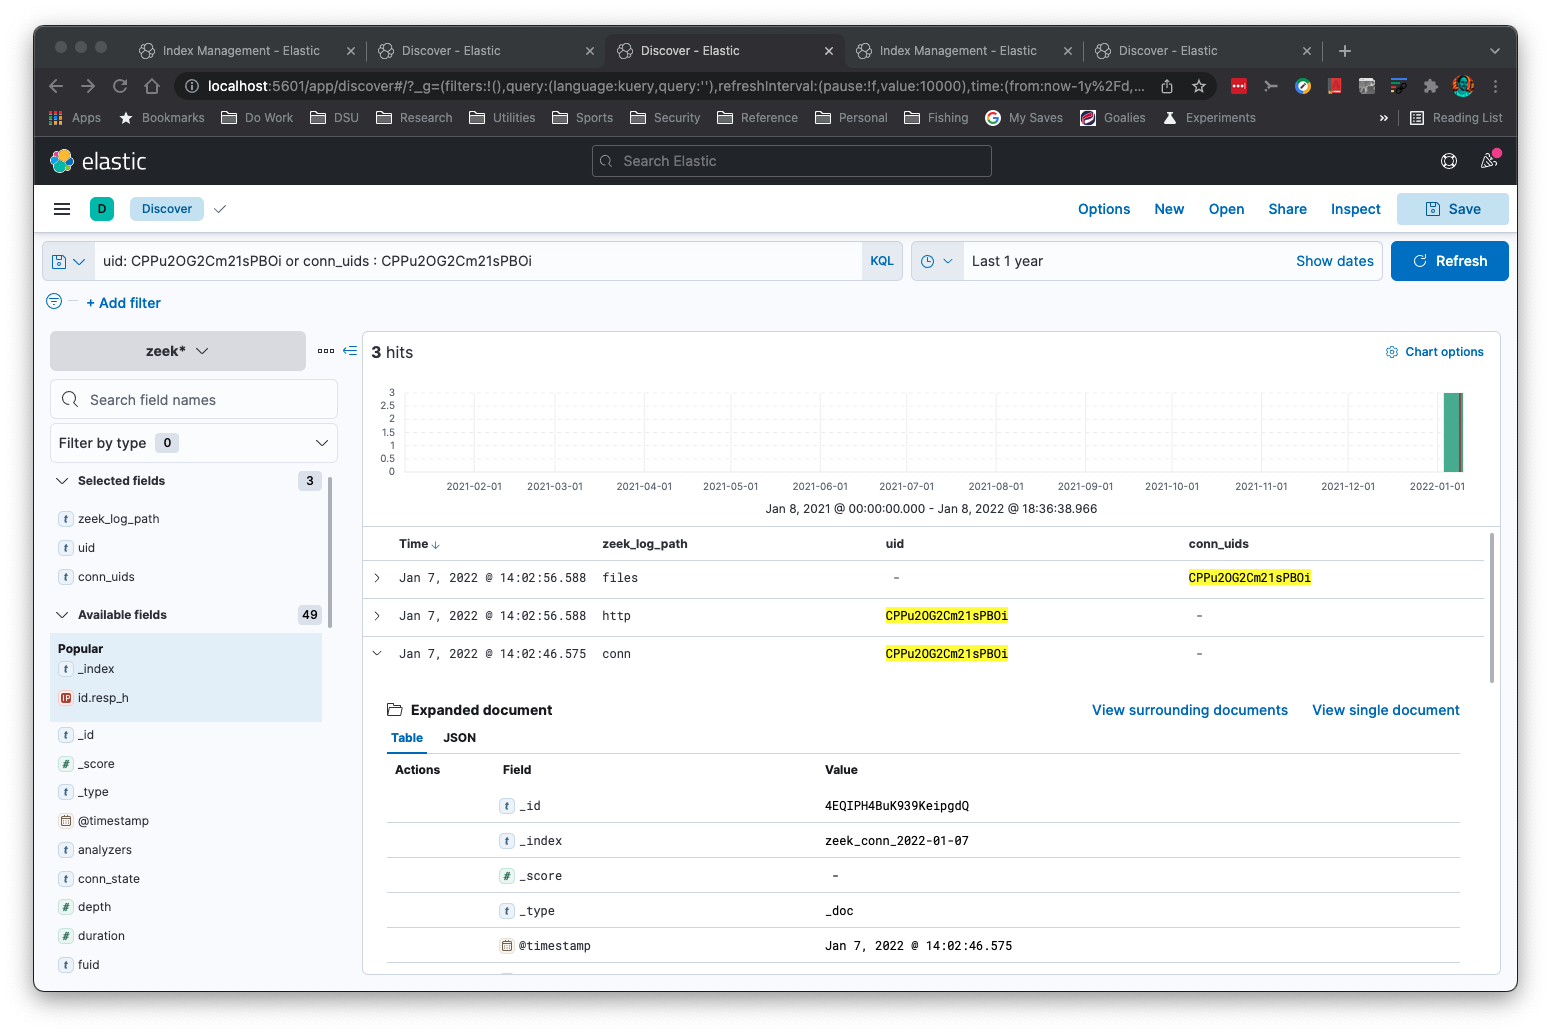
Хотите увидеть несколько логов Zeek для одного и того же ID соединения (uid) или ID файла (fuid)? Вот результаты из files.log, http.log и conn.log для одного uid:
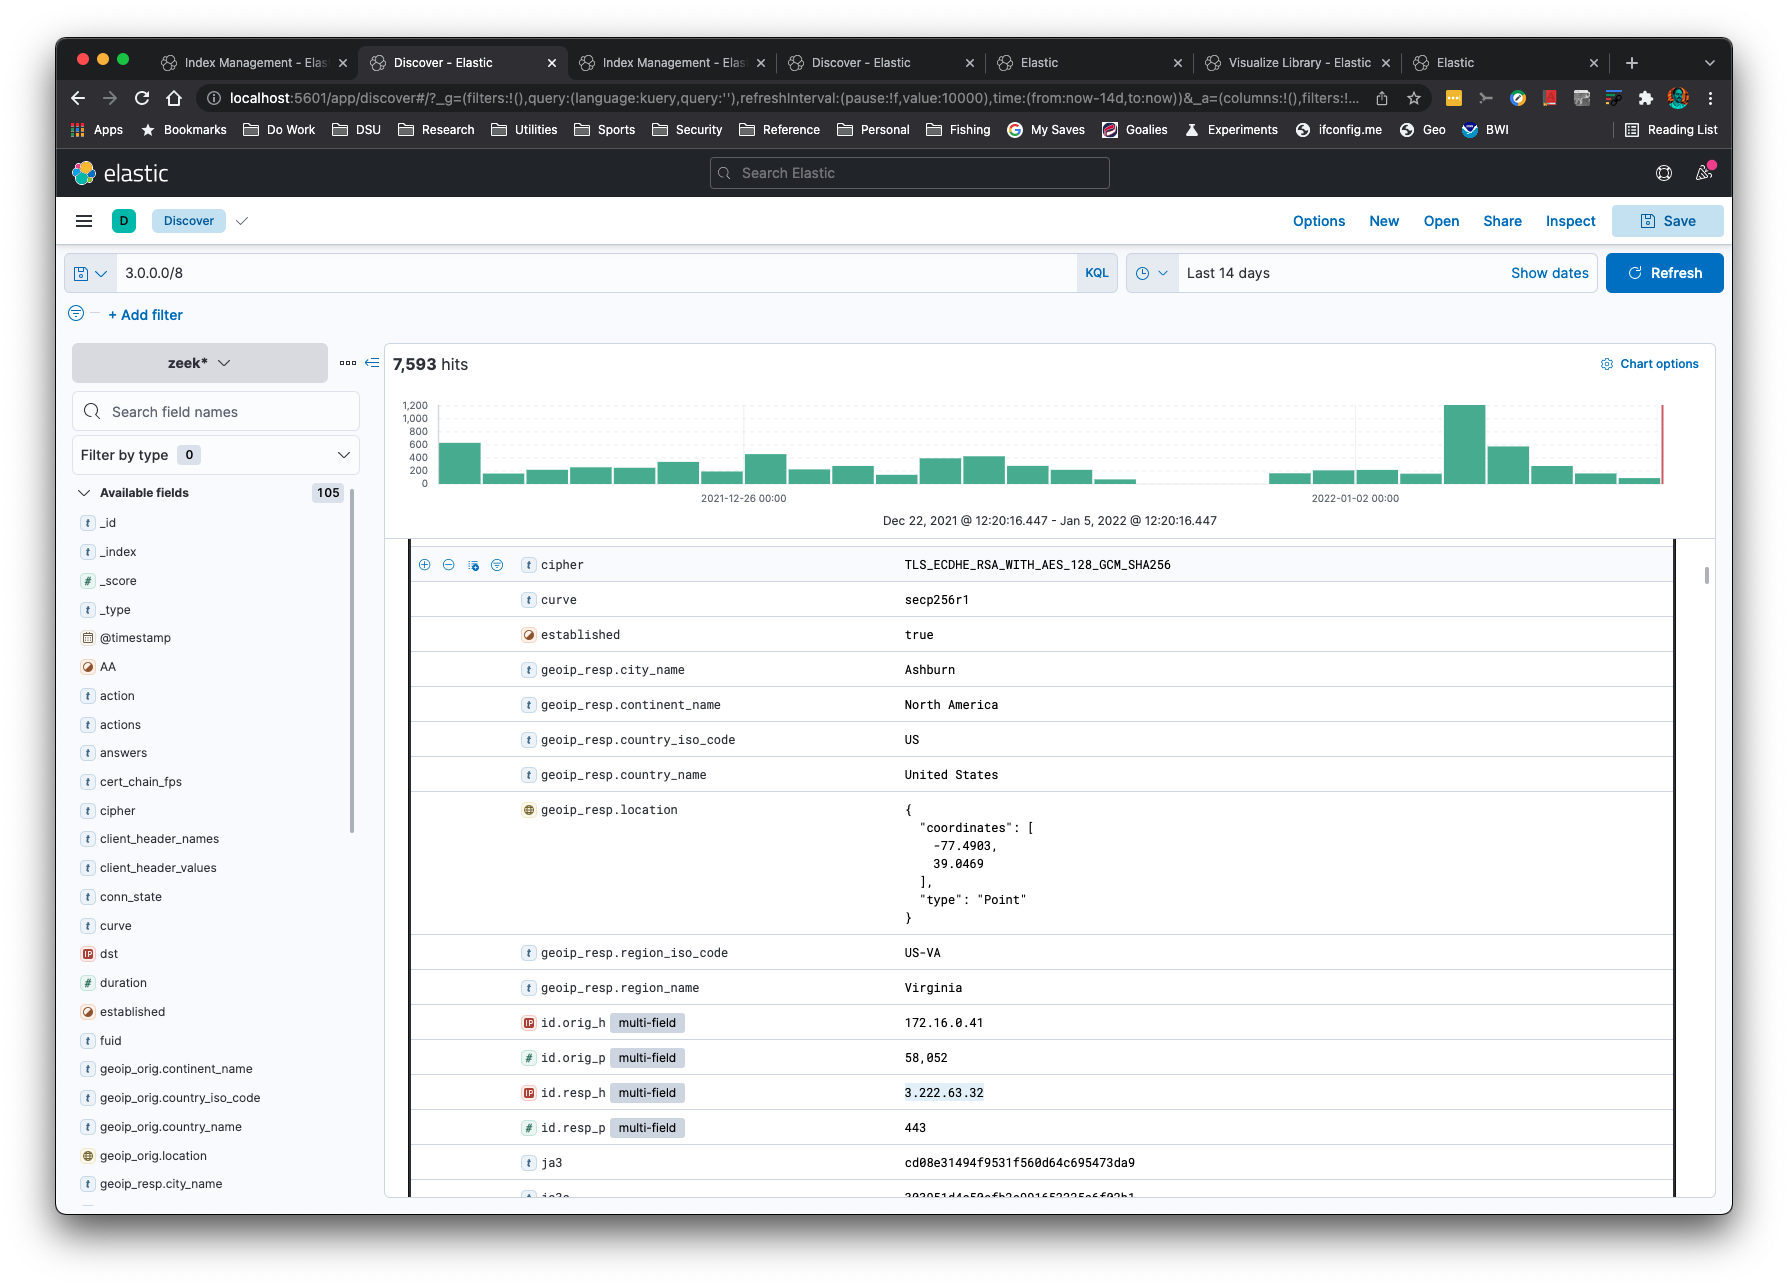
Вы можете выполнять поиск по подсети для типа 'addr' Zeek:
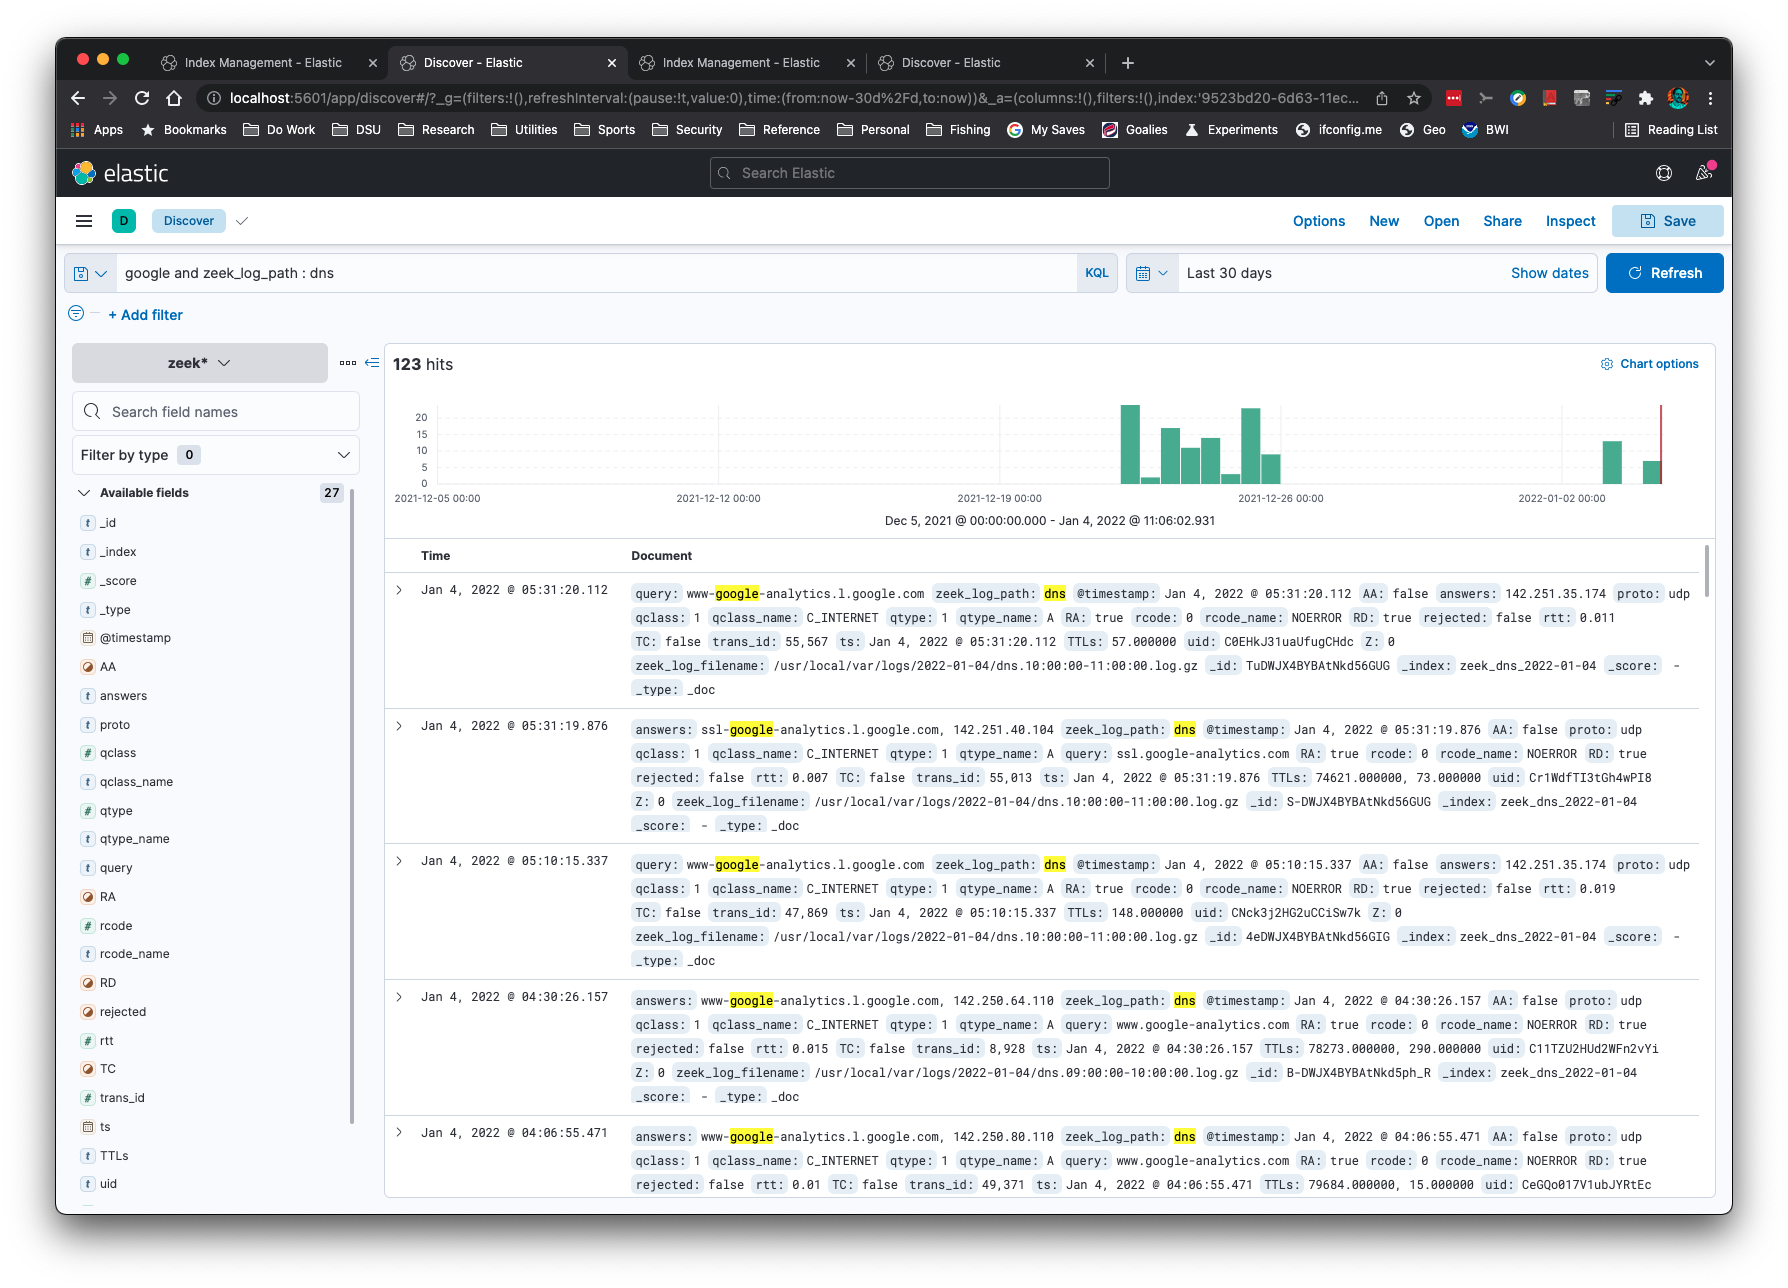
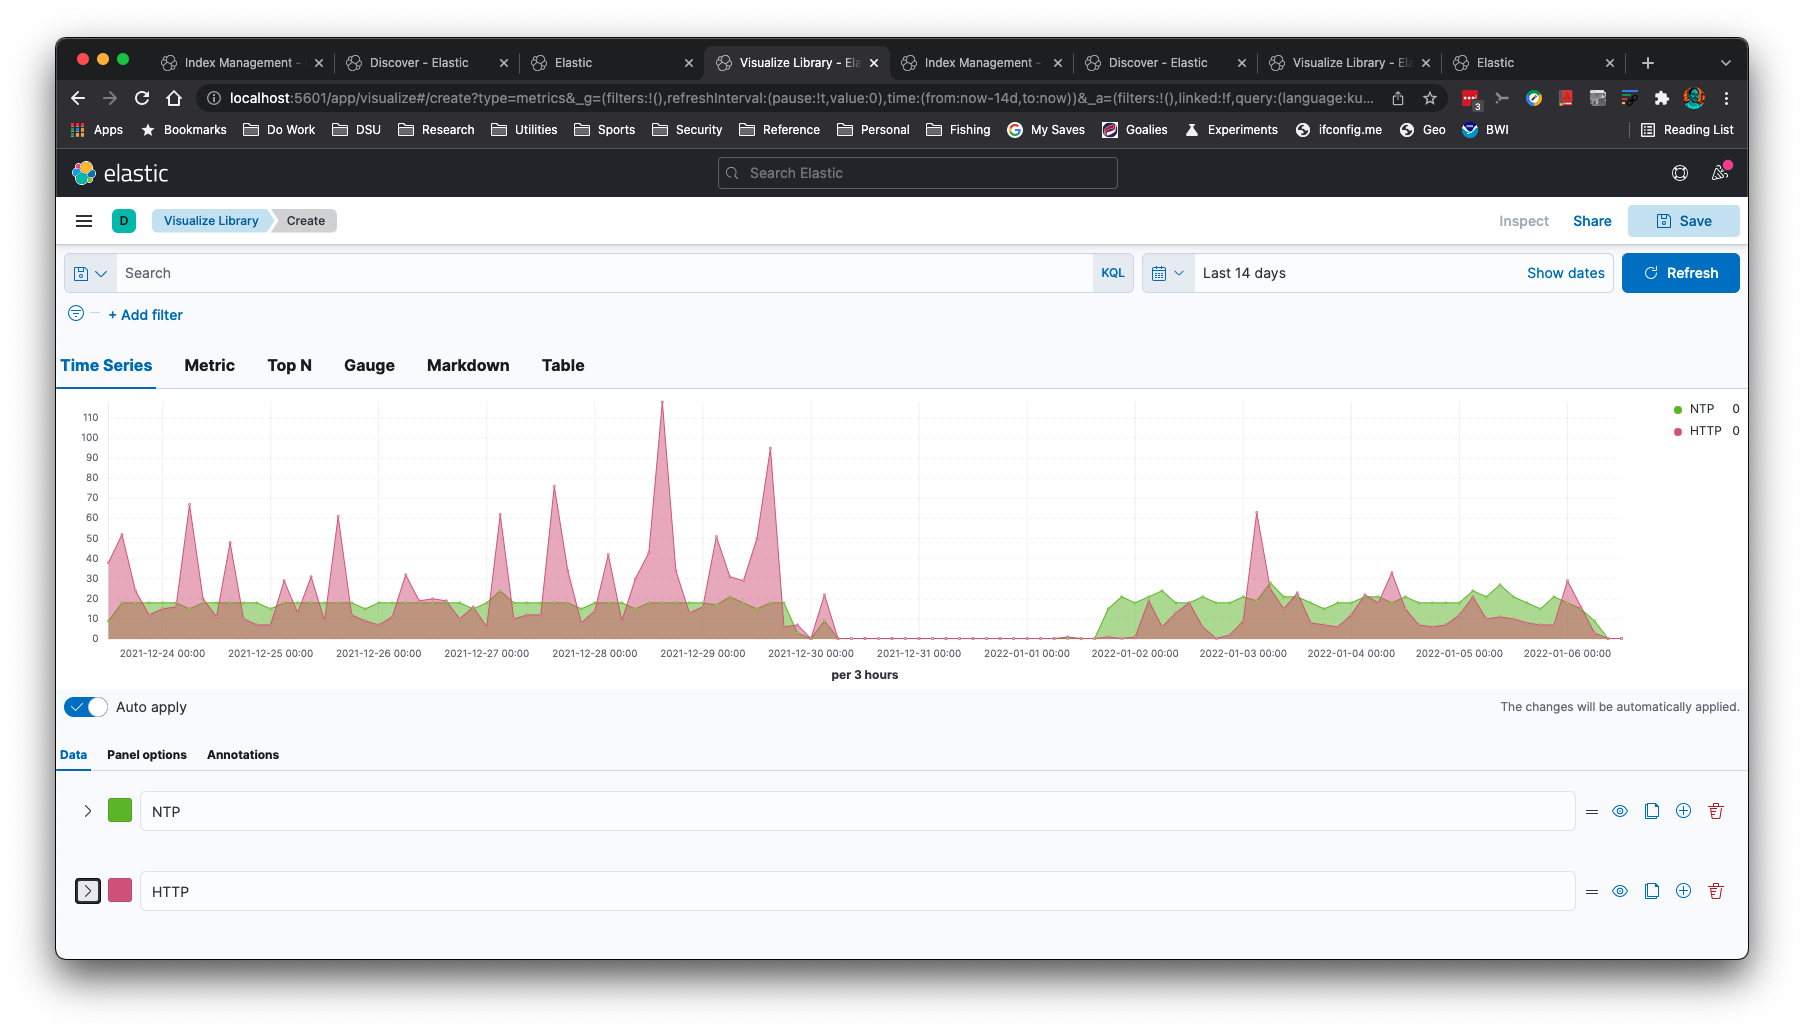
Вы можете создавать графики временных рядов, например, этот график NTP и HTTP:
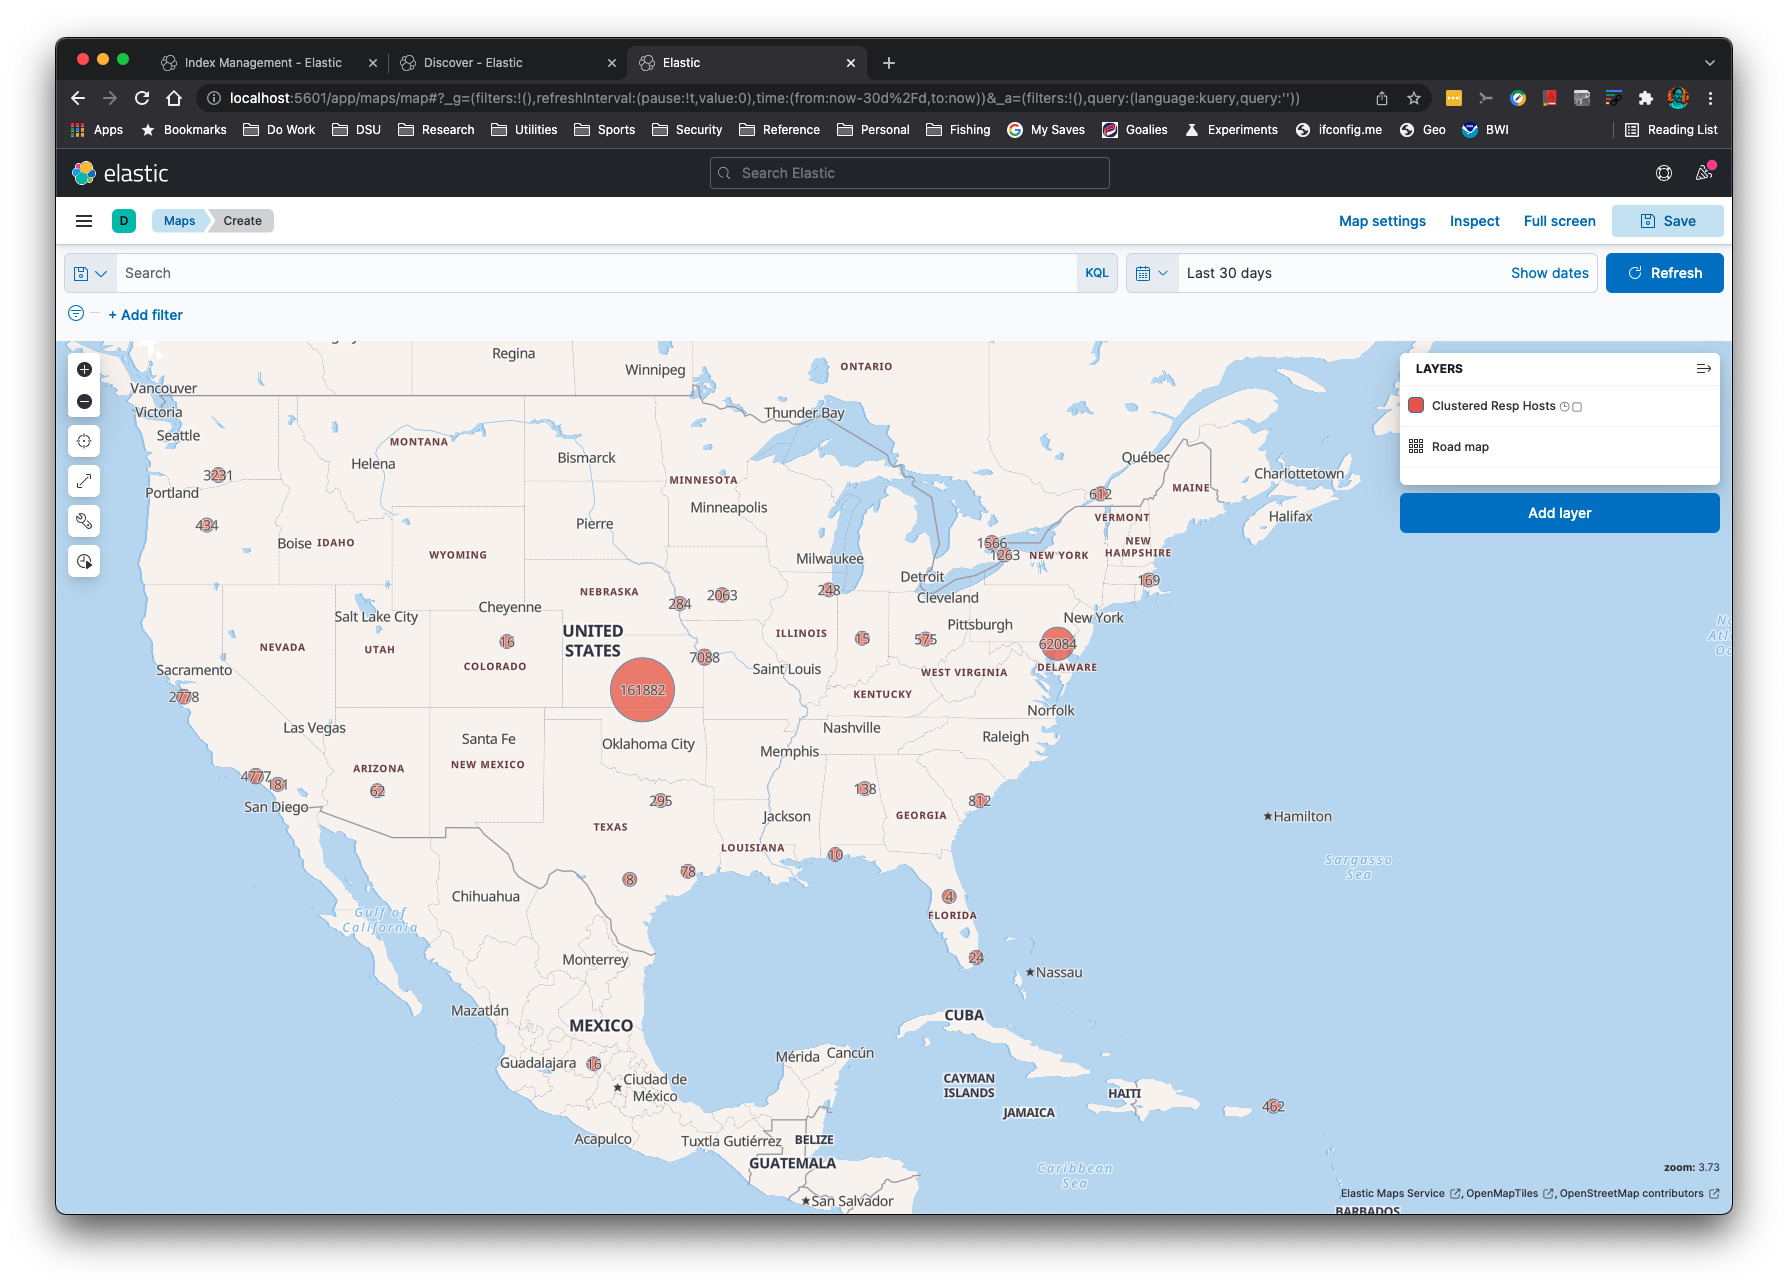
IP-адреса можно геолоцировать с помощью параметра командной строки -g:
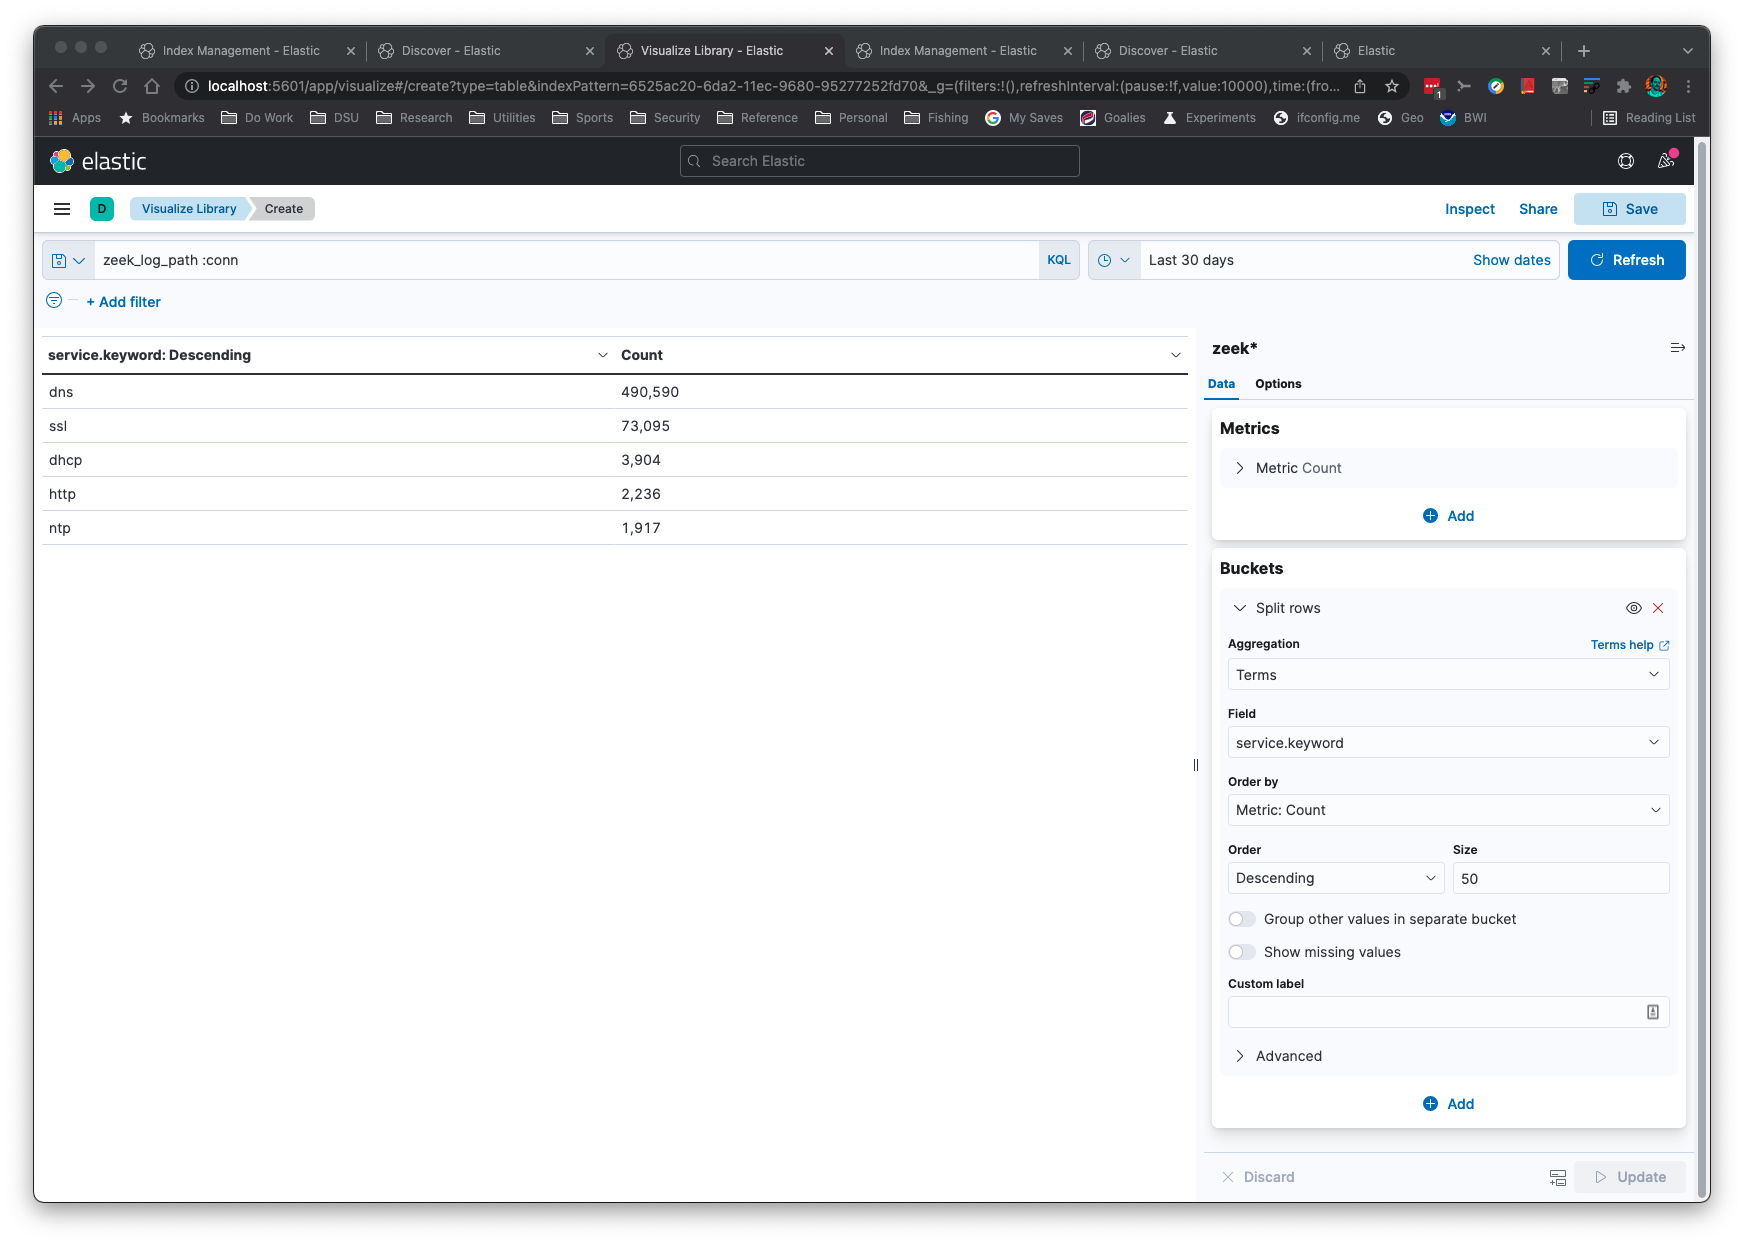
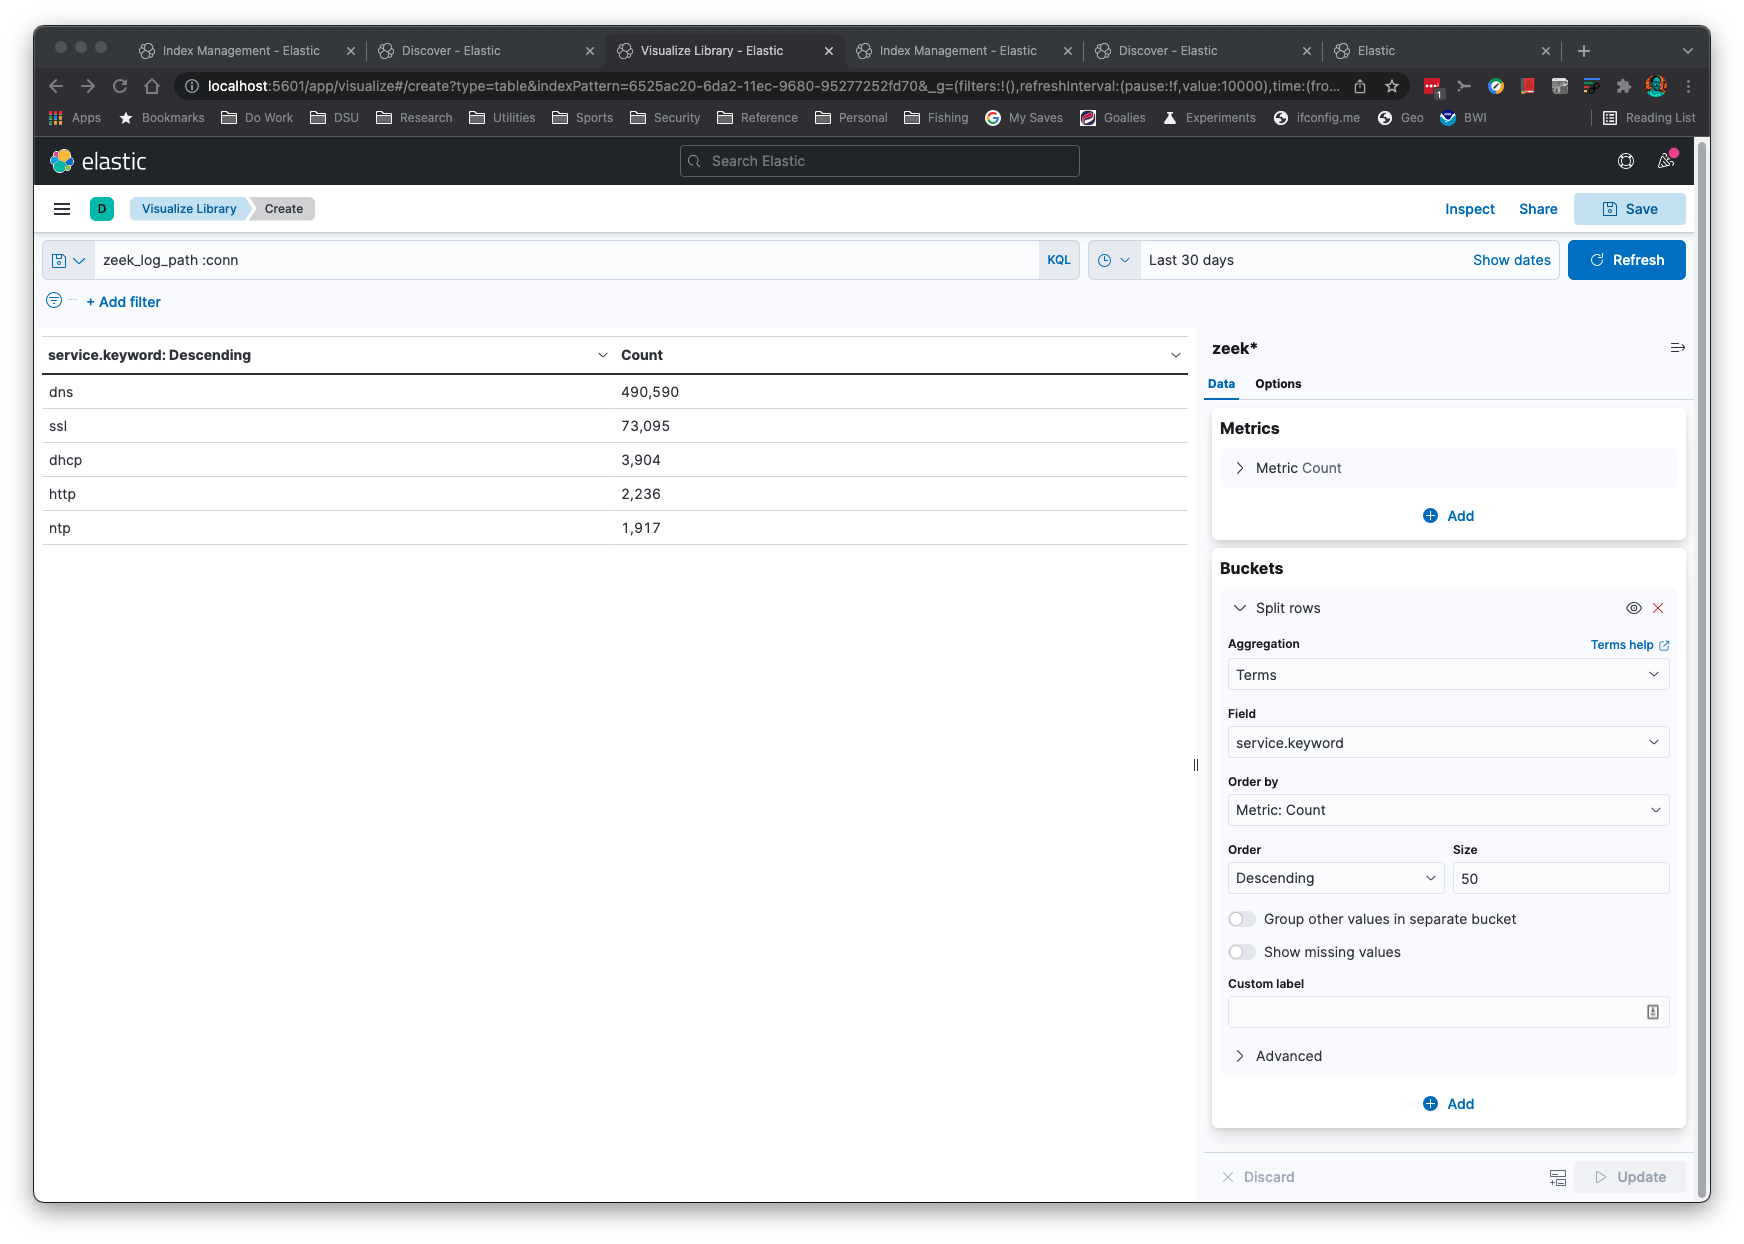
Агрегации просты и быстры:
Это приложение будет «просто работать» при изменении форматов логов Zeek. Логика читает имена полей и связанные типы, чтобы правильно настроить сопоставления в ElasticSearch.
Это приложение распознаёт gzip или несжатые логи. Приложение предполагает,
что ElasticSearch настроен на вашем localhost на порту по умолчанию.
Если у вас нет ElasticSearch, вы можете вывести JSON в stdout с помощью параметров командной строки -s -b,
чтобы обработать его приложением jq.
Вы можете добавить подполе keyword к текстовым полям с помощью параметра командной строки -k. Это полезно
для агрегаций в Kibana.
Если Python уже установлен в вашей системе, вам не нужно копировать на свою машину ничего дополнительного, кроме Elasticsearch, Kibana и zeek2es.py, если у вас уже установлена библиотека requests.
Если вы соответствуете требованиям, то установка не требуется. Вы просто
копируете zeek2es.py на свой хост и запускаете его с помощью Python. После импорта
логов Zeek с автоматической генерацией имени индекса (то есть, если вы не указали параметр -i)
вы обнаружите, что ваши индексы называются "zeek_zeeklogname_date", где zeeklogname — это имя лога, например conn,
а date — дата в формате YYYY-MM-DD. В этом случае задайте шаблон индекса Kibana, соответствующий zeek*. Если
вы назвали свой индекс с помощью параметра -i, вам нужно будет создать шаблон индекса Kibana, который
соответствует вашей схеме именования.
Если вы обновляете zeek2es, пожалуйста, обратитесь к разделу об обновлении zeek2es.
Если вы используете Elastic v8.0+, в нём по умолчанию включена безопасность. Это добавляет требование имени пользователя и пароля, а также HTTPS.
Если вы хотите иметь возможность удалять индексы/потоки данных с подстановочными знаками (как показано в примерах в этом readme),
отредактируйте elasticsearch.yml, добавив следующую строку:```
action.destructive_requires_name: false
Вам также нужно будет изменить команды curl в этом readme, чтобы они содержали `-k -u elastic:<password>`
где пароль пользователя `elastic` задаётся командой, подобной следующей:```
./bin/elasticsearch-reset-password -u elastic -i
Вы можете использовать zeek2es.py с опциями командной строки --user и --passwd, чтобы указать свои
учётные данные для ES. Вы также можете передать эти опции через дополнительные аргументы командной строки для вспомогательных
скриптов.
Вероятно, самый простой способ использовать этот код — через Docker. Все файлы находятся в каталоге docker.
Сначала вам нужно отредактировать строки с CHANGEME!!! в файле .env, чтобы они соответствовали вашему окружению.
Вам также нужно будет изменить пароль Elastic в docker/zeek2es/entrypoint.sh, чтобы он совпадал. Его можно найти после опции --passwd.
Затем вы можете перейти в каталог docker и ввести следующие команды, чтобы поднять
кластер zeek2es и Elasticsearch:```
docker-compose build
dockr-compose up
Теперь вы можете помещать логи в каталог `VOLUME_MOUNT/data/logs` (`VOLUME_MOUNT` вы задаёте в файле `.env`).
Когда в этом каталоге создаются логи, zeek2es начинает обрабатывать их и отправлять в Elasticsearch.
Затем вы можете войти на https://localhost:5601, используя имя пользователя и пароль, указанные в файле `.env`.
По умолчанию используется самозаверяющий сертификат, но вы можете изменить это, отредактировав файлы docker compose.  После входа в
Kibana перейдите в Stack Management->Data Views и создайте представление данных для `logs*` с временной меткой `@timestamp`.
Теперь вы сможете перейти в Discover и начать поиск по вашим логам!  Ваши данные сохраняются в указанном вами каталоге `VOLUME_MOUNT/data`.
Если вы хотите удалить все данные, просто выполните `rm -rf VOLUME_MOUNT/data`, подставив в эту команду тот каталог, который вы указали.
При следующем запуске кластера он будет совершенно чистым для новых данных.

## Обновление zeek2es <a name="upgradingzeek2es" />

Большинство обновлений сводится к простому копированию новой версии [zeek2es.py](https://github.com/corelight/zeek2es/blob/master/zeek2es.py) поверх
старой.  В некоторых случаях конвейер ingest ES, необходимый для опции командной строки `-g`,
может измениться при обновлении.  Поэтому настоятельно рекомендуется удалить
ваш [конвейер ingest](#esingestpipeline) перед запуском новой версии zeek2es.py.

### Конвейер ES Ingest <a name="esingestpipeline" />

Если вам нужно [удалить конвейер ES ingest "zeekgeoip"](https://www.elastic.co/guide/en/elasticsearch/reference/current/delete-pipeline-api.html)
используемый для геолокации IP-адресов с опцией командной строки `-g`, вы можете сделать это либо графически
через Kibana в разделе Stack Management->Ingest Pipelines, либо с помощью следующей команды:```
curl -X DELETE "localhost:9200/_ingest/pipeline/zeekgeoip?pretty"
Эта команда настоятельно рекомендуется при каждом обновлении вашей копии zeek2es.py.
