 aloshdenny/claude-awm
Обходит текстовые водяные знаки LLM, внедряя селекторы вариантов Unicode; включает генератор SynthID, детектор mean-g, защиту от нормализации и эксперименты с энтропией.

Да, но работает только одно семейство атак, и это не то, которое все предполагают.
Unicode вариационные селекторы (категория Mn, U+FE00–U+FE0F и U+E0100–U+E01EF) опускают детектор ниже порога и остаются там. Любая другая атака невидимыми символами, которую я пробовал, полностью откатывается одной строкой нормализации ввода. Вариационные селекторы — нет, потому что это значимые кодовые точки (представление эмодзи, варианты CJK), которые NFKC не будет и не должен сворачивать.
Воспроизведено на разных моделях и доменах:
| модель | домен | базовый z | после vs16_30 | доля правок |
|---|---|---|---|---|
| gpt-oss-20b | проза | 45.03 | 0.72 | 57% |
| gpt-oss-20b | код | 37.24 | 0.68 | 58% |
| Qwen3.8-27B | проза | 35.50 | -0.67 | 57% |
Порог — z = 2.33. Все три опускаются ниже него после атаки и остаются ниже после нормализации (0.09, 0.45, -0.78 соответственно). Текст выглядит для человеческого читателя идентично.
Вторая реальная находка не требует никакой атаки: текст с низкой энтропией изначально почти не маркируется. При отключённом режиме размышления чистый вывод кода Qwen3.8-27B без атаки даёт z = 4.31 — близко к порогу 2.33, хотя с ним ничего не делали. Включите размышление обратно, и та же модель, тот же домен, та же длина достигают z = 25.53, потому что вступительная часть рассуждений — это обычная проза, и она несёт метку нормально.
Всё в этом репозитории измерялось на этих моделях, и ни на чём другом:
| модель | параметры | где | что запускалось |
|---|---|---|---|
| Qwen3.5-0.8B | 0.8B | Mac (MPS) | полная лестница атак, 1k-8k |
| Qwen3.5-4B | 4B | Mac / 4090 | полная лестница атак + эксперимент с энтропией + стего raw/normalized |
| DeepSeek-R1-Distill-Qwen-14B | 14B | Mac (MLX, 4-bit) | водяной знак + детекция, трассы рассуждений |
| gpt-oss-20b | 20B | 3090 / 4090 / RunPod | полная лестница атак до 32k, проза + код, вариационные селекторы, закон масштабирования частоты вставки до 131k |
| Qwen3.8-27B | 27B | RunPod H100 / Modal H100 | проза + код, вариационные селекторы, контраст режима размышления |
| gpt-oss-120b | 120B | Modal H100 (MXFP4) / RunPod H100 | проза + код + рассуждения на 2k / 8k / 32k, частичное масштабирование частоты вставки до 65k |
| DeepSeek-V4-Flash | 284B MoE | RunPod 2x H200 (FP8) | проза + код на 2k / 8k |
Не каждый эксперимент запускался на каждой модели, и таблицы ниже указывают, что где запускалось. Более крупные модели добавлялись по мере сужения интересных вопросов, поэтому лестница атак широка на маленьких моделях, а работа с длиной и доменами сосредоточена на больших.
Anthropic (а до них Google DeepMind, статья SynthID-Text) маркирует сгенерированный текст, смещая выборку токенов с помощью турнира с ключом. Сигнал живёт в том, какие токены были выбраны, а не в каком-либо скрытом символе. Я хотел узнать, насколько это хрупко для мотивированного человека с функцией поиска и замены, поэтому собрал генератор плюс необученный детектор на основе среднего g и обрушил на него атаки.
Порог детектора — z = 2.33 (1% ложноположительных срабатываний). Выше этого = водяной знак обнаружен. Я генерировал помеченный текст, атаковал его, повторно токенизировал и оценивал. Каждая таблица результатов содержит контроль roundtrip (неатакованный помеченный текст), чтобы было видно, что детектор действительно работает в этой строке. Дважды за это исследование баг обнулял все z, и только контроль это выявил.
Поверхность атаки чётко делится по категории Unicode, и это, как оказалось, и есть вся история.
Работает (категория Mn, непробельные знаки):
| атака | что делает | доля правок | выживает после нормализации? |
|---|---|---|---|
vs16_30 | вариационный селектор после ~30% символов | 57% | да |
vs16 | вариационный селектор после ~10% символов | 23% | да (z 3.46) |
vs_supp | селекторы дополнительной плоскости (U+E0100+) | 24% | да (z 3.40) |
homoglyph | кириллическая а вместо латинской a (категория Ll) | 9% | да, но эффект слабый |
Не работает (категория Cf, форматирующие символы):
| атака | сырой z | нормализованный z | вердикт |
|---|---|---|---|
zwsp_30 | -0.09 | 35.68 | полностью откачено |
combo | 0.92 | 35.68 | полностью откачено |
bidi | 24.37 | 35.68 | полностью откачено |
nbsp | 41.04 | 46.51 | почти не сдвигается |
Символы Cf — это чистое форматирование без семантического содержания, поэтому нормализатор может вырезать их целиком, ничего не теряя. Селекторы вариаций Mn несут реальный смысл в эмодзи и тексте CJK, поэтому сплошное их удаление испортило бы легитимные документы. Именно эта асимметрия делает одно семейство защитимым, а другое — нет.
Практический масштаб: чтобы протолкнуть сильный базовый уровень ниже порога, нужно затронуть примерно 20% символов или больше, но вставленные символы невидимы, поэтому текст читается нормально при любой частоте правок. Визуальная идентичность проверена, см. src/fidelity_check.py. Четыре семейства вставляют только символы, которые ничего не отображают; гомоглифы — честное исключение (зависит от шрифта, невидимость не гарантируется).
Мой изначальный страх был скучным: что длинные тире, замена «and» на «&» и удаление markdown просто сработают, а водяной знак окажется театром безопасности. Многие в интернете предполагают именно это.
Это не работает. Вся лестница поверхностных правок на gpt-oss-20b вплоть до 32k токенов:
| атака | частота правок | z @ 1k | z @ 32k |
|---|---|---|---|
| roundtrip (контроль) | 0% | 25.7 | 104.3 |
| длинное тире → дефис | ~0% | 26.4 | 113.7 |
| удалить весь markdown | 13.6% | 27.2 | 103.3 |
| AmE → BrE + сокращения | 1.3% | ~28 | ~100 |
| удалить 40% каждого слова | 38% | 4.9 | 25.4 |
По трём моделям, на которых прогонялась эта лестница (0.8B, 4B, 20B = 294 ячейки), порог перешагнула ровно одна ячейка: удаление 39% каждого слова на самой короткой длине на 4B. Это не атака, это измельчение документа.
Всего измеренных ячеек по всему исследованию: 440 (294 из лестницы атак выше плюс 146 из развёртки по закону масштабирования ниже, расширяющей прозу до 131072 токенов).
Две вещи меня удивили:
Полный механизм и таблицы по каждой атаке — в docs/FINDINGS.md.
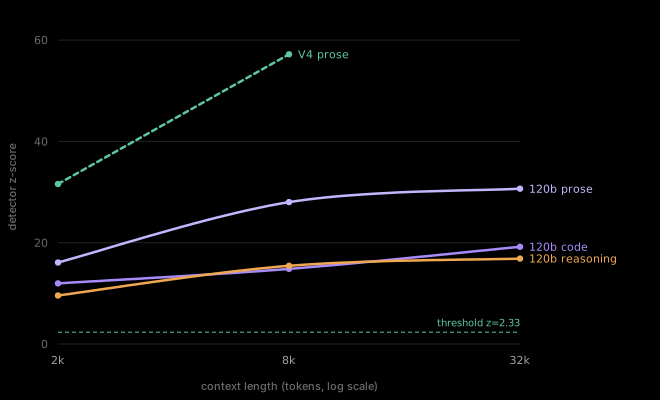
Уверенность водяного знака растёт с контекстом, тогда как сигнал на токен остаётся неизменным, поэтому более длинный документ сложнее атаковать, а не легче. Проза несёт самую сильную метку на любой длине; DeepSeek-V4-Flash (пунктир) воспроизводит тот же рост на 284B MoE.
