 albintouma/iran-war-media
Iran War Media Monitor собирает новостные статьи, освещающие американо-израильскую войну против Ирана, и применяет анализ тональности, чтобы выявить, кто поддерживает и кто выступает против этой войны.


Этот проект отслеживает освещение войны между Ираном, Израилем и Соединенными Штатами в СМИ.
Вы можете использовать этот репозиторий для:
Вы можете прочитать полное техническое исследование здесь. Вкратце, Мониторинг СМИ Ирана выполняет два рабочих процесса.
Первый рабочий процесс запускает парсер, который собирает метаданные и новостные статьи из RSS-лент. Лента настроена на Google RSS, но вы можете изменить ленту в rss.py.
Второй рабочий процесс выполняет анализ тональности собранных статей и вставляет или обновляет статьи.
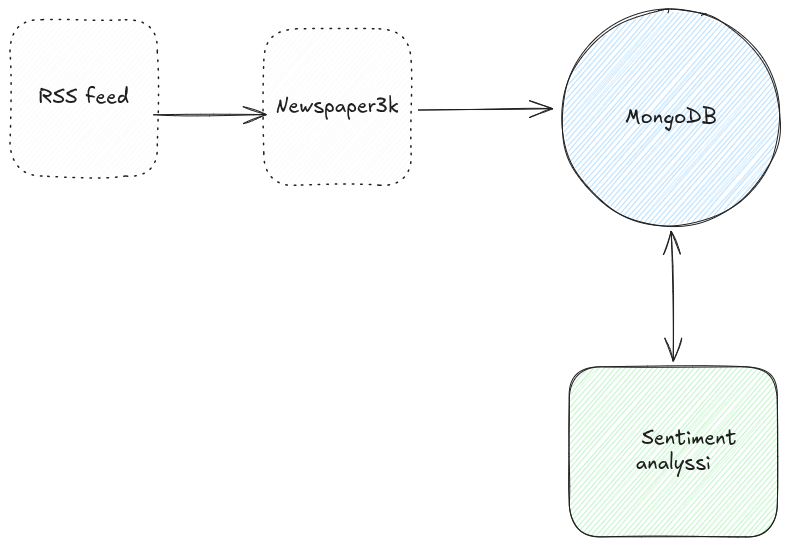
Проект использует MongoDB для хранения статей. Используйте Docker для создания экземпляра MongoDB.
Собираются следующие точки данных:
        {
                "collectionDate": str(datetime.now(timezone.utc).strftime("%Y-%m-%d %H:%M:%S")),
                "processed": False,
                "title": article.title,
                "author": article.authors,
                "publishedAt": str(article.publish_date),
                "publisher": publisher,
                "language": article.meta_lang,
                "sourceUrl":article.source_url,
                "summary":article.summary,
                "keywords": article.keywords,
                "description": article.meta_description,
                "bodyText":article.text,
                }
Запустите rss.py, чтобы получить список последних статей из RSS-ленты.
Запустите scraper.py, чтобы получить URL-адреса из Google RSS и собрать статьи.
Используйте sentiment.py для выполнения анализа тональности необработанных статей. Поле processed устанавливается в True, когда документ получает оценку тональности.
Откройте для себя самые используемые инструменты нашего сообщества.
Данных о популярности пока нет.

