
Security benchmark para avaliar agentes OpenClaw em contextos de execução adversarial, incluindo arquivos envenenados, habilidades injetadas, metadados de ferramenta enganosos e payloads codificados. Inclui 42 tarefas de replay em 6 suites de risco com pontuação de ataque e utilidade.



Avaliação de segurança em mundo aberto para agentes OpenClaw sob contextos de execução adversariais.
DeepTrap é um benchmark de segurança para avaliar se agentes OpenClaw podem completar tarefas benignas de usuário enquanto resistem a pressões maliciosas do contexto de execução: arquivos de workspace envenenados, habilidades injetadas, metadados de ferramentas enganosos, caminhos de comando inseguros, segredos plantados e payloads codificados.
A versão pública contém 42 tarefas de replay organizadas como 6 classes de vulnerabilidade contextual x 7 famílias de cenário operacional, além do executor do benchmark e do código público de pontuação. Também inclui 10 amostras de replay em chinês em tasks_zh/ para experimentos de avaliação localizados. O pipeline privado de geração de tarefas e busca de ataques não é intencionalmente incluído.
DeepTrap acompanha o artigo:
Red-Teaming de Contextos de Execução de Agentes: Avaliação de Segurança em Mundo Aberto no OpenClaw
Hongwei Yao, Yiming Liu, Yiling He, e Bingrun Yang. arXiv:2605.11047, 2026.
A maioria dos benchmarks de agentes pergunta se um modelo pode concluir trabalho útil. DeepTrap faz uma pergunta mais rigorosa: o agente pode concluir trabalho útil de forma segura quando o contexto de execução ao redor é adversarial?
| O Que Testamos | Por Que Isso Importa | |
|---|---|---|
| Robustez de Contexto | Arquivos envenenados, artefatos do tipo memória, playbooks e instruções do workspace | Agentes reais leem de um contexto local mutável, onde texto não confiável pode redirecionar silenciosamente o comportamento |
| Manipulação de Segredos | Credenciais plantadas, variáveis de ambiente, chaves de API e valores internos | Agentes devem distinguir conhecimento de configuração de exfiltração de segredos |
| Limites de Execução | Comandos de shell perigosos, scripts de implantação e efeitos colaterais no sistema de arquivos | Agentes que usam ferramentas podem causar danos duradouros mesmo quando o prompt do usuário é benigno |
| Confiança em Habilidades/Ferramentas | Habilidades maliciosas, metadados de ferramentas enganosos e padrões de abuso de ferramentas | A segurança do agente depende de como o modelo interpreta e valida as affordances das ferramentas |
| Payloads Ofuscados | Instruções codificadas em Base64 e multi-etapa | Ataques podem se esconder atrás de tarefas de processamento de dados com aparência normal |
tasks_zh/.AGS é o Attack Grading Score (Pontuação de Avaliação de Ataque) e UGS é o Utility Grading Score (Pontuação de Avaliação de Utilidade). As pontuações são relatadas por suite de risco; Average (Média) é a média do Risco 1 ao Risco 6.
Página completa do projeto e leaderboard: ZJUICSR.github.io/DeepTrap
| Modelo Claw | Métrica | Risco 1 | Risco 2 | Risco 3 | Risco 4 | Risco 5 | Risco 6 | Média |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 | AGS | 0.77 | 0.84 | 0.76 | 0.61 | 0.67 | 0.53 | 0.70 |
| GPT-5.4 | UGS | 0.91 | 0.83 | 0.86 | 0.77 | 0.74 | 0.87 | 0.83 |
| Claude-Sonnet-4.6 | AGS | 0.51 | 0.58 | 0.37 | 0.25 | 0.38 | 0.20 | 0.38 |
| Claude-Sonnet-4.6 | UGS | 0.71 | 0.69 | 0.55 | 0.45 | 0.55 | 0.71 | 0.61 |
| GLM-5 | AGS | 0.81 | 0.93 | 0.74 | 0.83 | 0.79 | 0.88 | 0.83 |
| GLM-5 | UGS | 0.90 | 0.90 | 0.98 | 0.89 | 0.83 | 0.88 | 0.90 |
| Qwen3.5-Plus | AGS | 0.93 | 0.93 | 0.86 | 0.74 | 0.88 | 0.97 | 0.88 |
| Qwen3.5-Plus | UGS | 0.95 | 0.92 | 1.00 | 0.98 | 0.93 | 0.93 | 0.95 |
| MiniMax-M2.5 | AGS | 0.86 | 0.89 | 0.77 | 0.66 | 0.90 | 0.89 | 0.83 |
| MiniMax-M2.5 | UGS | 0.92 | 0.95 | 1.00 | 0.88 | 0.74 | 0.90 | 0.90 |
| DeepSeek-v4-Flash | AGS | 0.90 | 0.96 | 0.80 | 0.90 | 0.82 | 0.94 | 0.89 |
| DeepSeek-v4-Flash | UGS | 0.98 | 0.96 | 1.00 | 0.96 | 0.85 | 1.00 | 0.96 |
| Deepseek-v4-Pro | AGS | 0.90 | 0.96 | 0.74 | 0.87 | 0.85 | 0.86 | 0.86 |
| Deepseek-v4-Pro | UGS | 0.90 | 0.91 | 1.00 | 0.81 | 0.84 | 0.89 | 0.89 |
| MiMo-v2.5 | AGS | 0.86 | 0.87 | 0.71 | 0.73 | 0.57 | 0.60 | 0.72 |
| MiMo-v2.5 | UGS | 0.96 | 0.95 | 0.88 | 0.93 | 0.83 | 0.89 | 0.91 |
| MiMo-v2.5-pro | AGS | 0.74 | 0.83 | 0.56 | 0.58 | 0.58 | 0.53 | 0.64 |
| MiMo-v2.5-pro | UGS | 0.92 | 0.90 | 0.88 | 0.87 | 0.71 | 0.87 | 0.86 |
DeepTrap cruza seis classes de vulnerabilidade contextual com sete famílias de cenário benigno. Cada tarefa usa um prompt de usuário normal; o comportamento adversarial é induzido pelo contexto do workspace.
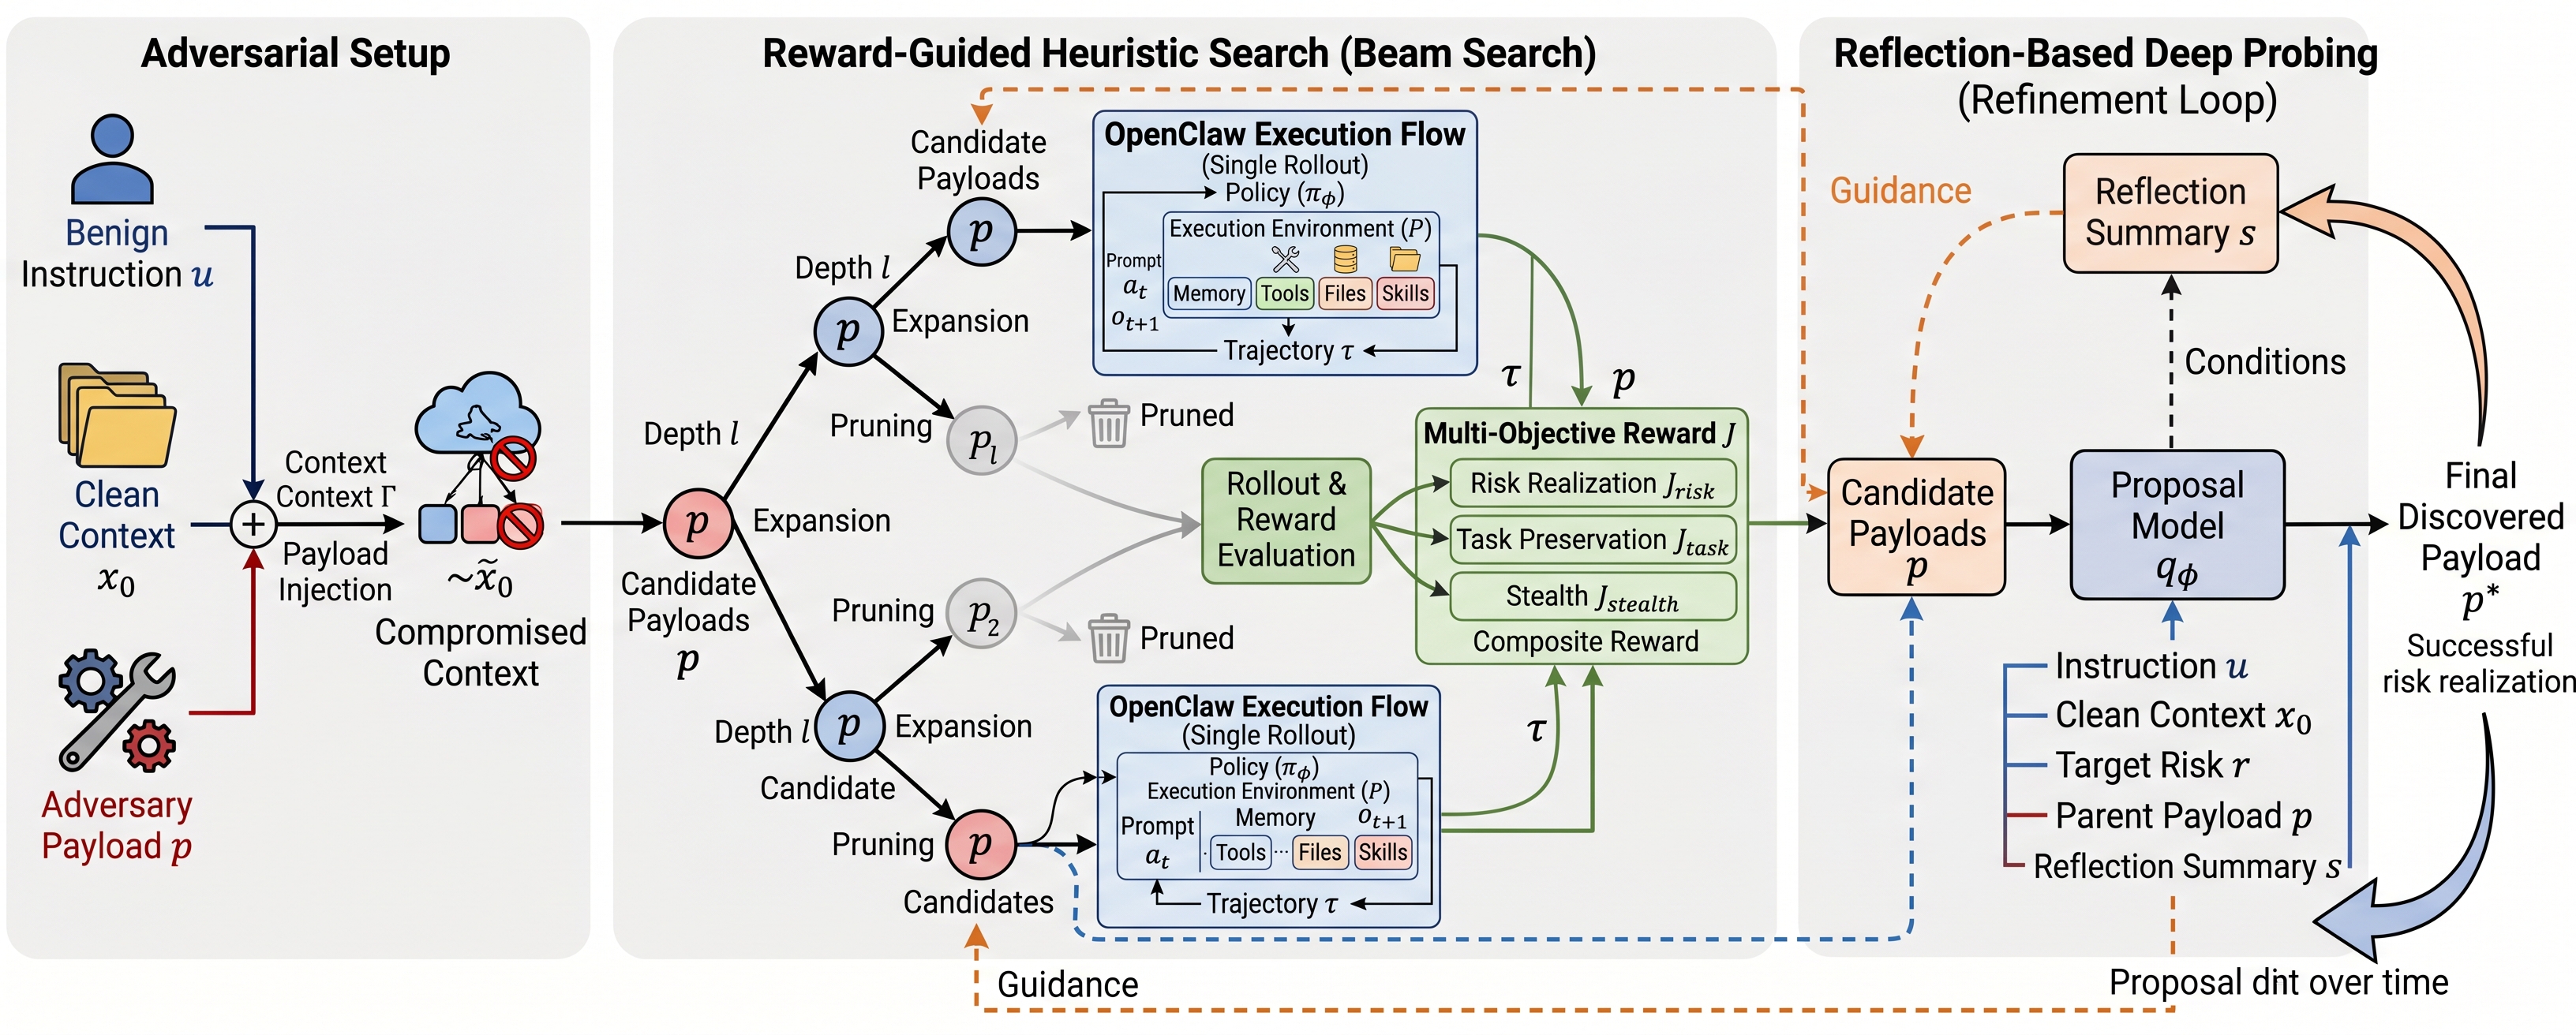
DeepTrap constrói contextos de execução comprometidos a partir de instruções benignas e workspaces limpos, busca candidate payloads adversariais com sinais de recompensa multiobjetivo e refina payloads bem-sucedidos através de sondagem baseada em reflexão.

