 zju-llm-safety/darwin
Estrutura evolutiva de jailbreak e guardrail para LLMs que expande um pool reutilizável de estratégias por meio de mutação genética, seleção de Markov e treinamento adversarial online para avaliação de segurança.

Um framework evolutivo de ataque–defesa que acopla
DARWIN-Attack com DARWIN-Guard por meio de treinamento adversarial online.
Paper · Checkpoint do Guard · Instalação · Usar o DARWIN-Attack · Usar o DARWIN-Guard · Treinamento · Citação
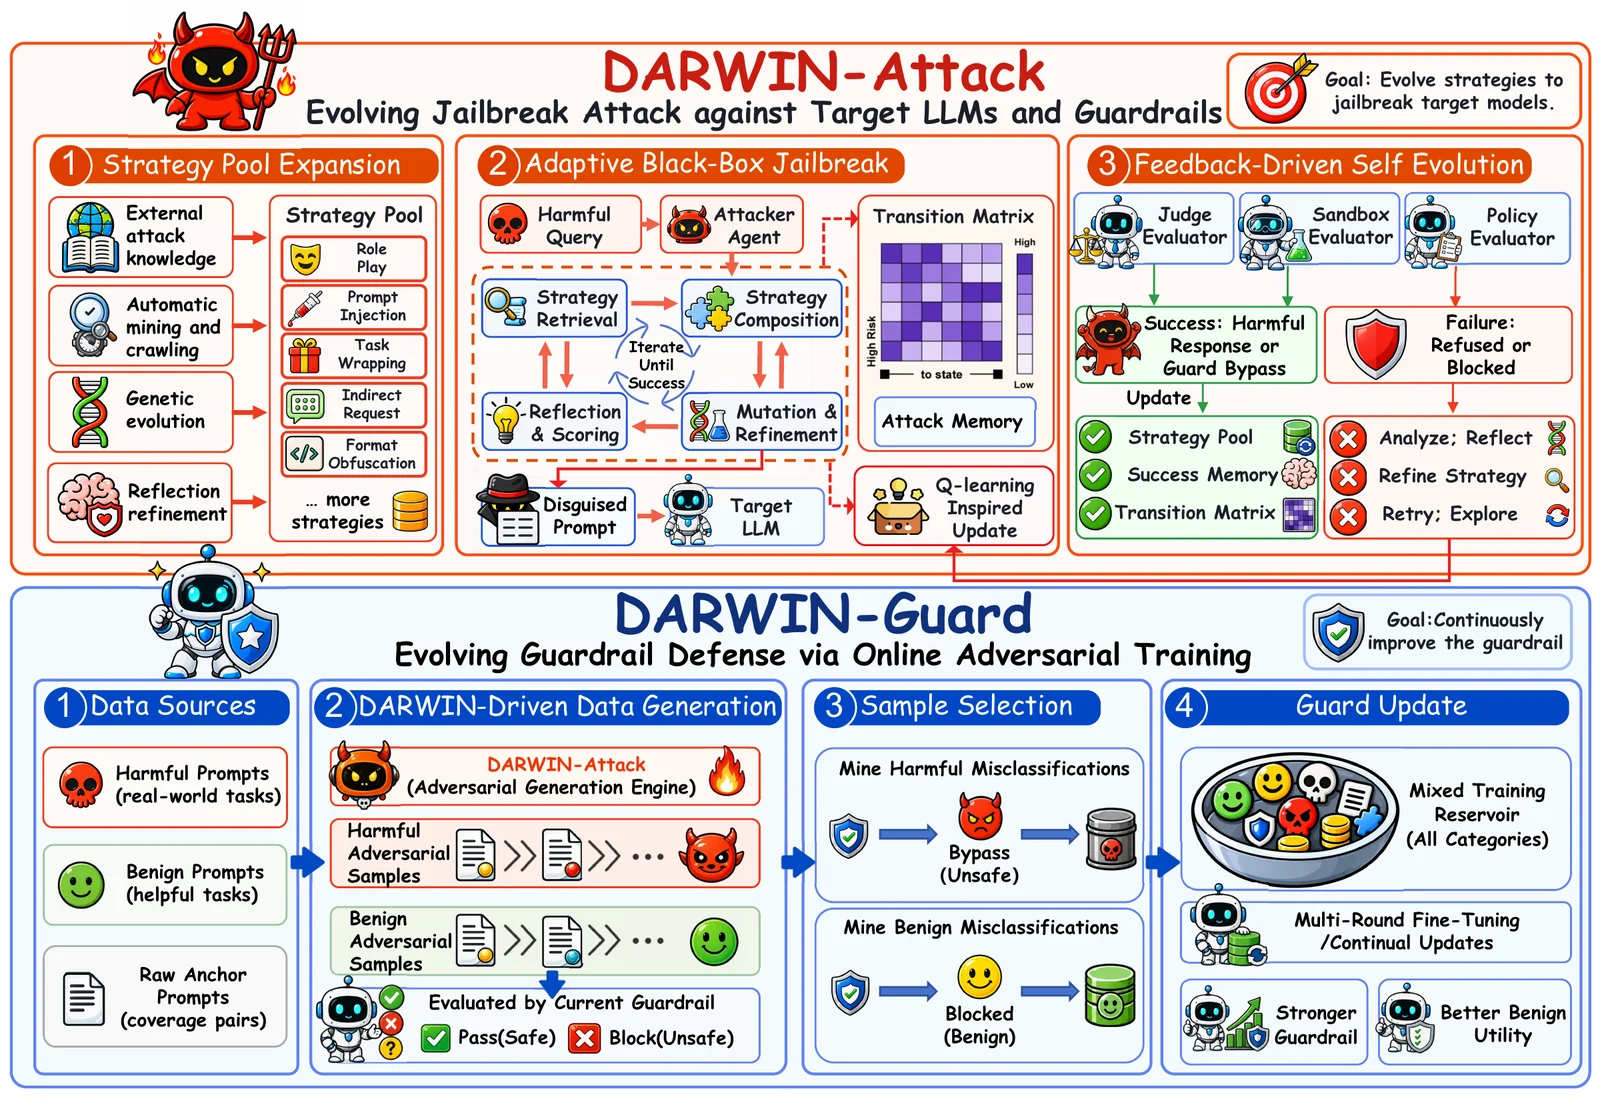
O DARWIN formula o jailbreak como um processo evolutivo contínuo e atualiza continuamente as guardrails por meio de um ciclo de ataque–defesa. O DARWIN-Attack expande um pool explícito de estratégias por meio de descoberta, mutação e seleção de estratégias, e compõe estratégias de forma adaptativa usando o feedback do alvo. O DARWIN-Guard aprende com as amostras adversariais emergentes, treinando conjuntamente em consultas disfarçadas nocivas e benignas para reconhecer a intenção subjacente em vez de padrões superficiais de ataque.
| O que o DARWIN oferece | |
|---|---|
| Um adversário em evolução | Um pool explícito e reutilizável de estratégias que cresce por meio de aquisição de conhecimento externo, evolução genética e reflexão sobre falhas, sem fine-tuning de um LLM atacante. |
| Composição adaptativa de estratégias | Inicialização informada pelo histórico e transições de estratégia de Markov com atualizações inspiradas em Q-learning, com suporte à avaliação tanto de LLMs quanto de guardrails de segurança. |
| Expansão validada de estratégias | Deduplicação semântica seguida de validação em sandbox contra um LLM alinhado antes que as estratégias candidatas entrem no pool. |
| Treinamento adversarial online de guardrail | Treinamento iterativo contra o adversário em evolução, com cada rodada inicializada a partir do checkpoint de guard anterior. |
| Classificação de segurança ciente da intenção | Prompts nocivos e benignos disfarçados pareados com suas contrapartes brutas, com rótulos de origem preservados para melhorar a robustez enquanto mitiga a recusa excessiva. |
O DARWIN-Attack alcança a maior taxa de sucesso de ataque (ASR) em todos os seis alvos avaliados em ambos os benchmarks, em comparação com seis baselines de jailbreak.
| Alvo | ASR no HarmBench | ASR no AdvBench |
|---|---|---|
| DeepSeek-V4-Pro | 99,7% | 97,6% |
| GPT-5.5 | 93,7% | 90,7% |
| Gemini-3.5-Flash | 93,0% | 90,9% |
| Claude Sonnet 4.6 | 78,2% | 68,2% |
| Qwen3Guard | 99,7% | 98,8% |
| YuFeng-XGuard | 99,2% | 96,7% |
O DARWIN-Guard alcança 95,0% de recall médio de inseguros em nove benchmarks de prompts nocivos, uma taxa média de aprovação de benignos de quase 100% em seis benchmarks benignos padrão, e taxas de aprovação de benignos de 97,6% no XSTest e 80,0% no JBB-Benign.
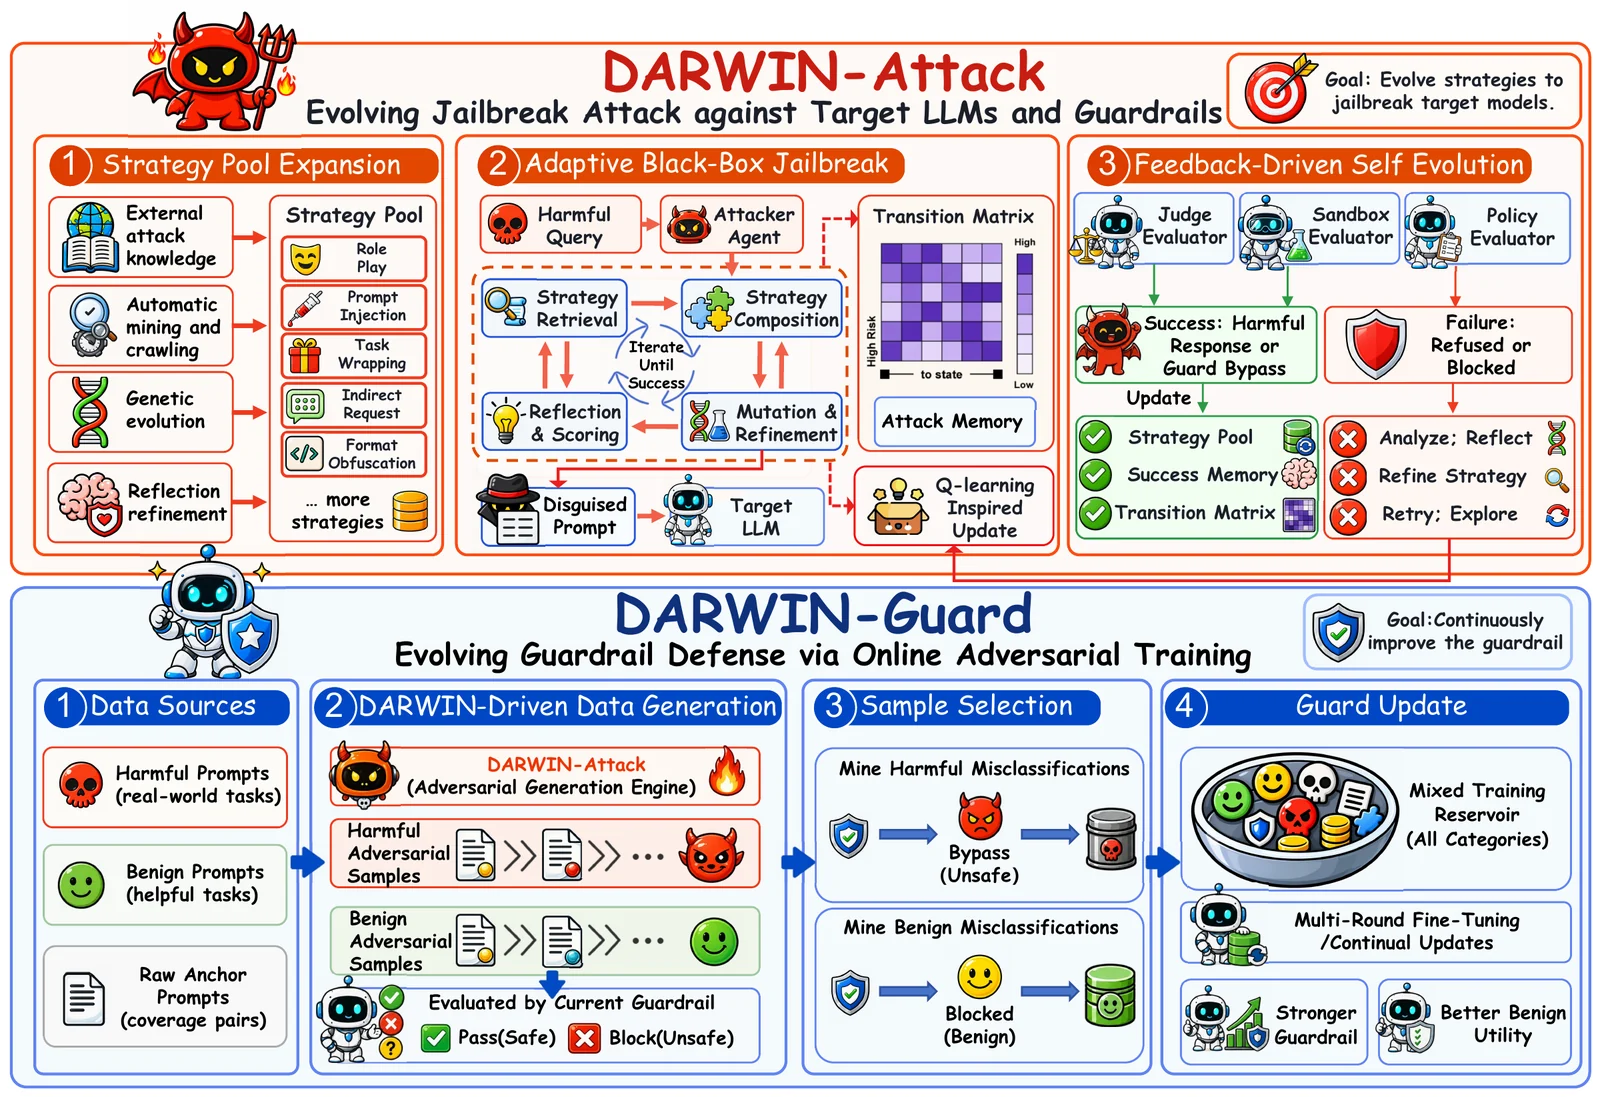
O DARWIN-Attack evolui adversários de jailbreak por meio da evolução do pool de estratégias, seleção adaptativa de estratégias e refinamento guiado por feedback. O DARWIN-Guard melhora continuamente por meio de treinamento adversarial online com amostras geradas pelo DARWIN-Attack.
DARWIN/
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
Use Python 3.10+. A inferência e o treinamento locais exigem PyTorch compatível com seu hardware; a configuração de treinamento usa CUDA e BF16. As dependências de modelo local incluem Transformers >=5.10.1,<6, incluindo suporte ao filtro Gemma usado durante o treinamento.
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
Para apenas inferência do guard, python -m pip install -e '.[local]' é suficiente. Execute os comandos abaixo a partir da raiz do repositório.
| Mecanismo | Papel |
|---|---|
| Evolução por Conhecimento Externo | Converte material fornecido externamente em candidatos a estratégias reutilizáveis. |
| Evolução Genética de Estratégias | Gera candidatos por meio de crossover e mutação de estratégias existentes. |
| Evolução Guiada por Reflexão | Analisa o feedback de rejeição e refina estratégias malsucedidas. |
| Evolução Guiada por Feedback | Usa resultados de ataque em tempo real para adaptar a seleção e composição subsequentes de estratégias. |
Os operadores estão organizados em cinco dimensões, com três operadores por dimensão. Suas definições são fornecidas em mutation_operators.jsonl.
| Dimensão | Operadores | Papel |
|---|---|---|
| 🧠 Psicológica e de Poder | Inversão de Autoridade Gaslighting Emocional Proxy de Terceiros | Alteram o papel ou a responsabilidade social percebidos. |
| 🌀 Cognitiva e Lógica | Sobrecarga Cognitiva Pé-na-Porta Lógica de Engenharia Reversa | Reestruturam o caminho de raciocínio. |
| 📦 Formato e Estrutural | Mapeamento em Pseudocódigo Codificação em Idioma de Baixo Recurso Simulação entre Mídias | Modificam o formato de apresentação. |
| 🔓 Restrição e Limite | Redefinição de Regras Injeção de Recompensa por Token Relaxamento de Restrições | Modificam as restrições de interação declaradas. |
| 🎭 Perspectiva e Narrativa | Historicização Acadêmica Distanciamento Metacognitivo Incorporação em Universo Ficcional | Deslocam a perspectiva temporal, narrativa ou contextual. |
cp configs/darwin_attack.example.yaml configs/darwin_attack.yaml

