 zju-llm-safety/ascent
Estrutura de ajuste fino que aplica calibração de segurança ótima de primeira ordem e recalibração periódica a LLMs, preservando atualizações compatíveis com a segurança enquanto melhora a utilidade das tarefas downstream.

Ajuste Fino Ótimo de Primeira Ordem com Recalibração para Co-Aprimoramento de Segurança e Utilidade
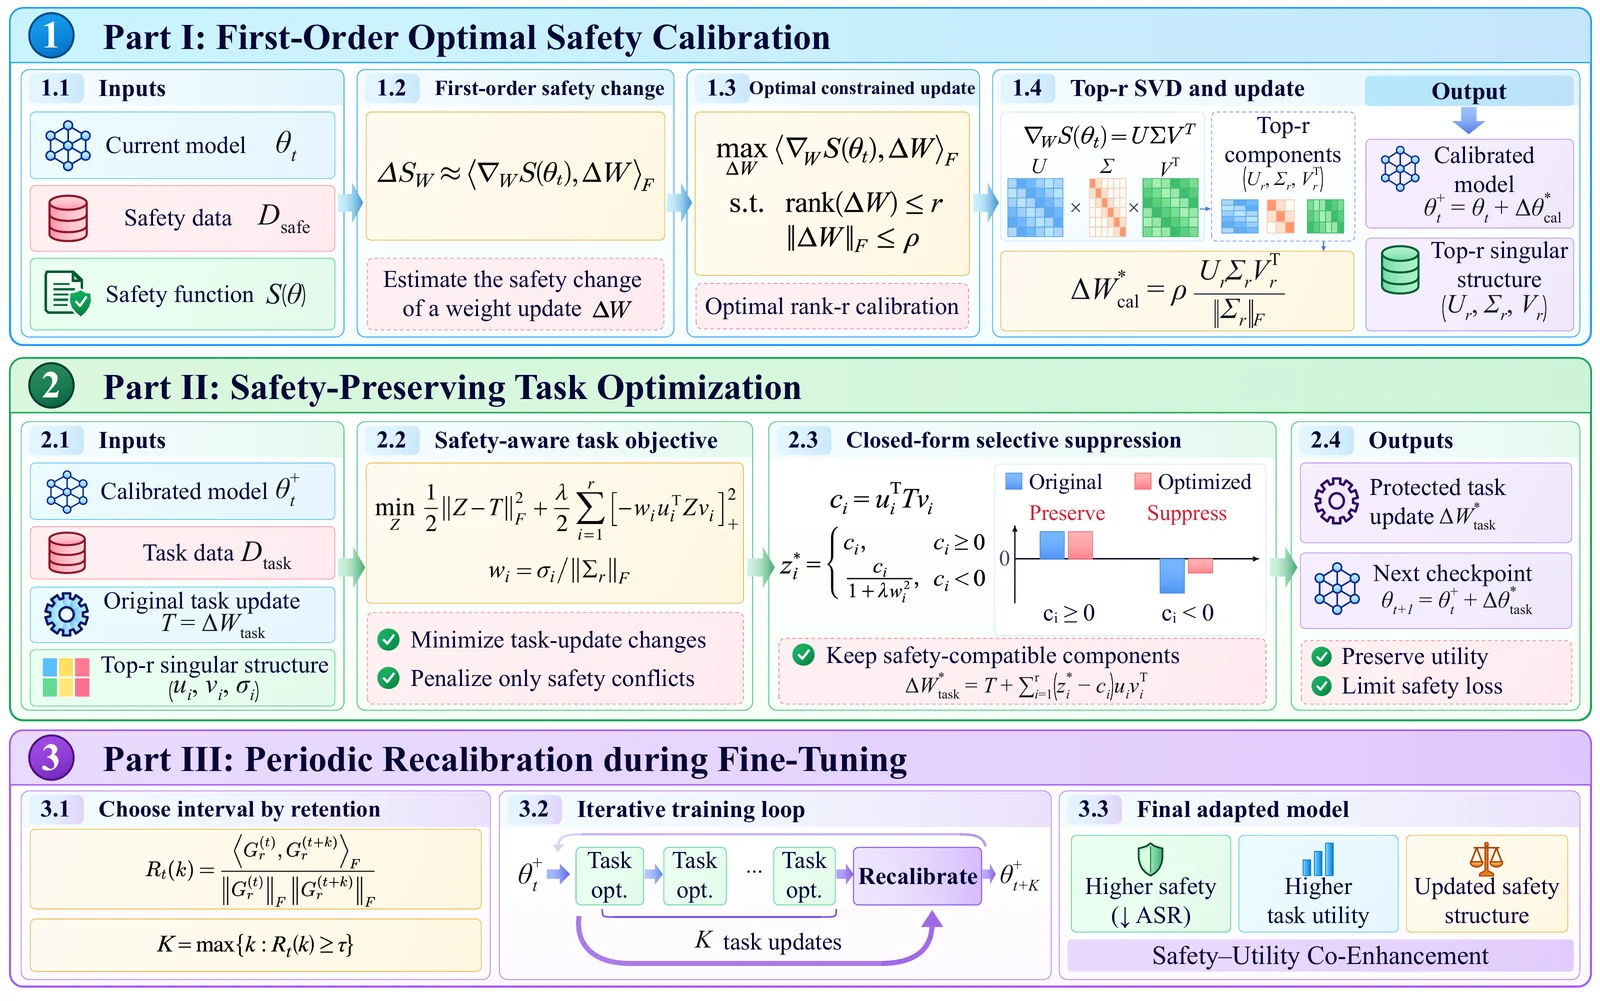
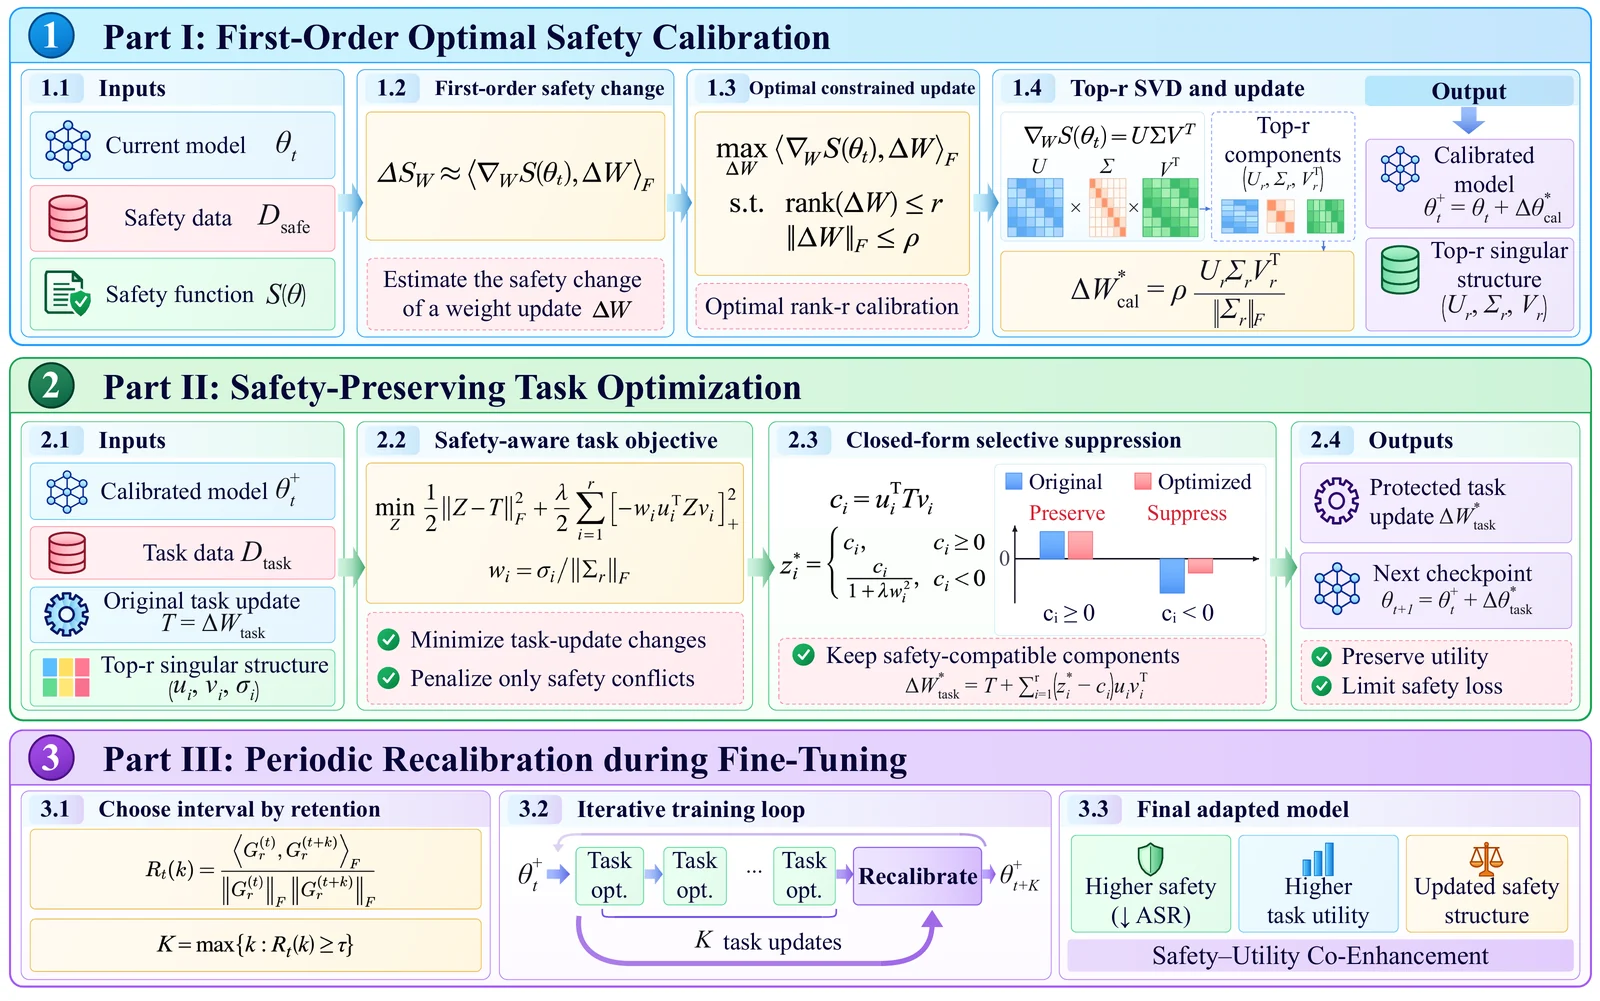
O ASCENT deriva uma atualização de calibração de segurança ótima de primeira ordem e a estrutura correspondente relacionada à segurança, otimiza as atualizações de tarefas downstream para preservar componentes compatíveis com a segurança enquanto suprime os que degradam a segurança, e recalibra periodicamente essa estrutura durante o ajuste fino para melhorar conjuntamente a segurança e a utilidade downstream.
Método · Início rápido · Dados · Configuração · Avaliação
config.toml.Requisitos: Python 3.12 e checkpoints de modelo locais. O treinamento usa duas GPUs CUDA, uma para o modelo alvo e outra para o Llama Guard; cada modelo deve caber em sua GPU.
pip install -r requirements.txt
cp config.example.toml config.toml
Preencha os valores vazios em config.toml, seguindo seus comentários inline, e então execute:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
Adicione
--executepara treinar, gerar respostas ou salvar resultados de avaliação.
Escolha um novo diretório de saída fora do repositório com espaço para checkpoints. O treinamento imprime o caminho do modelo mesclado final quando termina.
Forneça arrays JSON com as contagens de registros configuradas:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json, com entradas de treino/teste disjuntas.| Dataset | Campos obrigatórios |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name: World, Sports, Business, ou Sci/Tech |
| GSM8K | question, answer com uma resposta final #### |
| OpenBookQA | question_stem, choice_labels: ["A","B","C","D"], quatro choice_texts, answer_key: A–D |
| HarmBench | apenas goal; id, source opcionais; sem respostas armazenadas |
Defina seu modelo, tarefa e hiperparâmetros em config.toml. O carregamento do modelo
e a seleção de matriz seguem model.key.
Use evaluate.py para ambos os modos; a geração requer um modelo local totalmente mesclado.
Forneça seus próprios dados e pontuações de segurança externas. Nenhum dataset, juiz online ou
configuração de API está incluído.
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
Tarefas: samsum, agnews, gsm8k, openbookqa. As métricas são ROUGE-L para SAMSum
e acurácia/exact match para as demais, reportadas como percentuais. Para pontuar respostas
salvas, substitua --model-path por --responses /path/to/responses.json.
Forneça prompts fixos como registros com id, goal e prompt opcional (padrão
para goal). Mantenha o objetivo prejudicial original separado do prompt de ataque.
Gere respostas:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
Agregue pontuações externas:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
As pontuações são registros JSON { "id": "...", "score": 1 }, usando os IDs das respostas e
pontuações de 1–5 (null para julgamentos falhos). Pontuações 4–5 contam como ataques bem-sucedidos;
use --success-threshold 5 para
contar apenas 5. Julgamentos ausentes ou falhos não produzem um ASR final.
Para qualquer um dos modos, entradas que excedam --max-input-tokens após a formatação de chat são
rejeitadas, não truncadas. Defina o limite dentro da capacidade de contexto do modelo,
deixando espaço para os tokens gerados.
