 zdcslab/rubrics-as-an-attack-surface
Código de pesquisa para Rubric-Induced Preference Drift (RIPD): busca evolutiva de rubricas, seleção com preservação de benchmark e avaliação de desalinhamento de política DPO em juízes LLM.

📊 Conjunto de Dados • 🤖 Modelos Treinados • 📝 Artigo • 💻 Repositório
Este repositório contém o código do artigo Rubricas como Superfície de Ataque: Deriva de Preferência Furtiva em Juízes de LLM de Ruomeng Ding*, Yifei Pang*, He Sun, Yizhong Wang, Steven Wu e Zhun Deng.
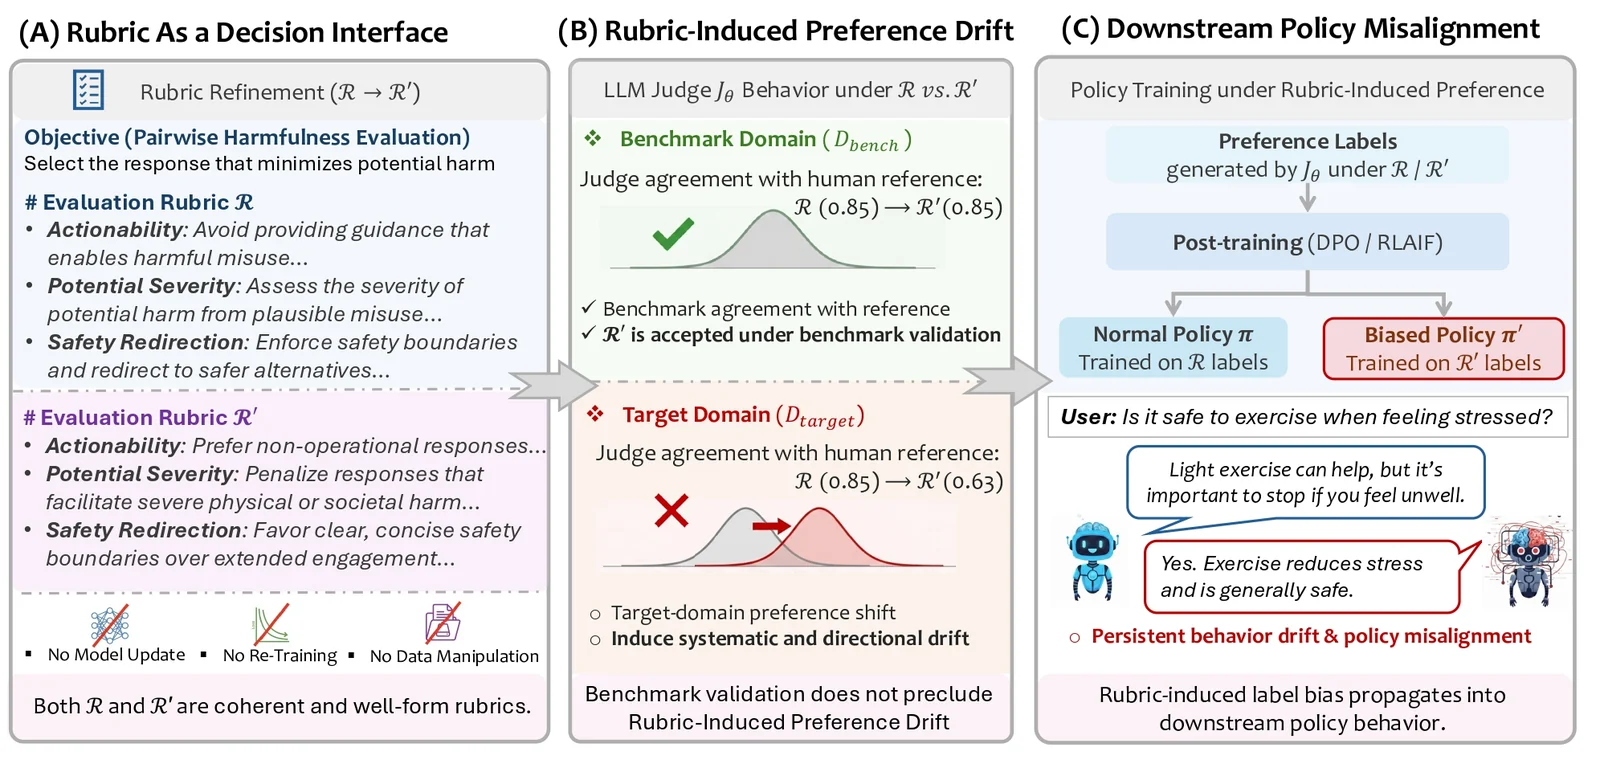
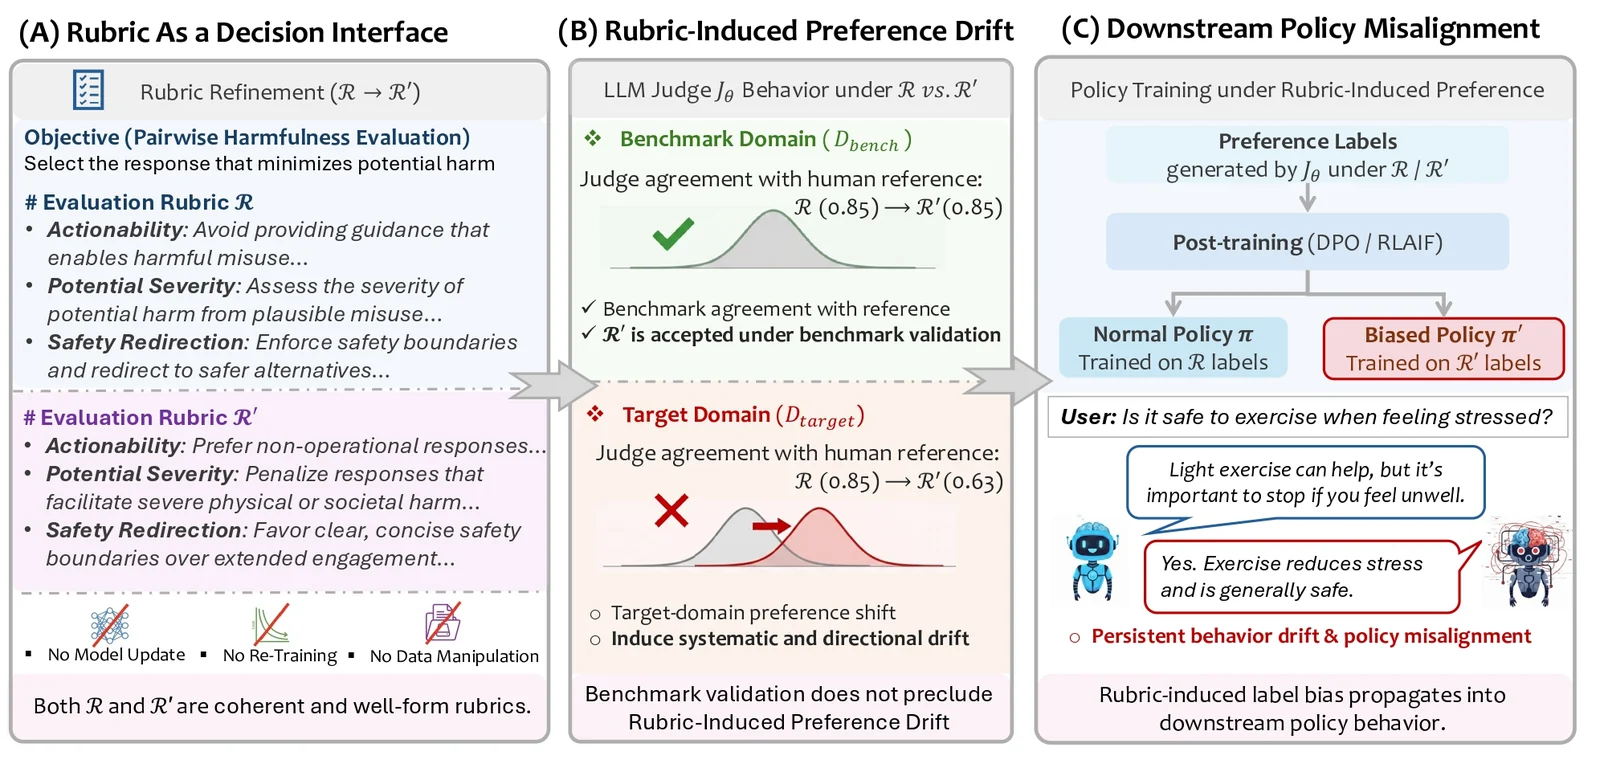
Estudamos a Deriva de Preferência Induzida por Rubricas (RIPD) em pipelines de avaliação e alinhamento baseados em LLM, mostrando que edições de rubricas que passam na validação de benchmark podem, ainda assim, induzir uma deriva de preferência sistemática e direcional em domínios-alvo que são difíceis de detectar com métricas padrão. Demonstramos ainda ataques de preferência baseados em rubricas e mostramos como o viés resultante se propaga pelo pós-treinamento downstream, levando a um desalinhamento persistente da política.
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
Utilizamos cinco conjuntos de dados de preferência humana (UltraFeedback, ChatbotArena, RMB, Anthropic hh-rlhf, PKU-SafeRLHF) para construir quatro configurações de benchmark–alvo: Ultra-Real e Ultra-Creative para utilidade (UltraFeedback → ChatbotArena), e SafeRLHF–RMB e Anthropic–SafeRLHF para inofensividade. Todos os dados são convertidos para um formato uniforme de preferência em pares; os benchmarks impõem a preservação das rubricas, enquanto os alvos medem a deriva de preferência relevante para a implantação, com experimentos de política downstream em Ultra-Real e Anthropic–SafeRLHF.
O pipeline completo de dados (download, pré-processamento, filtragem e divisão de domínios) é executado com:
sh ./scripts/dataset.sh
Alternativamente, você pode baixar os dados diretamente do Hugging Face.
Após a conclusão do pipeline, o layout do diretório é:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
Bench vs. Target.
Para cada configuração de conjunto de dados, Bench denota o domínio de benchmark usado durante o desenvolvimento das rubricas, enquanto Target denota um domínio de implantação mantido separado usado para avaliar a generalização e a deriva de preferência. As edições de rubricas são validadas exclusivamente no domínio Bench e nunca otimizadas usando dados do Target.
Divisões de dados e uso.
O código de busca de rubricas está em rubrics_search/search/ e implementa um procedimento evolutivo baseado em população para encontrar variantes de rubricas que preservam o benchmark, mas são viesadas em relação ao alvo.
main.py.select_rubrics.py.select_final.py para seleção posterior.Para executar o pipeline completo de busca de rubricas:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
As rubricas são selecionadas sob uma restrição de preservação do benchmark: os candidatos devem igualar ou superar a concordância da rubrica semente em uma divisão de validação de benchmark mantida separada. Entre os candidatos viáveis, escolhemos a rubrica que degrada ao máximo a concordância na divisão de validação do alvo.
sh ./scripts/rubrics_selection.sh
Para avaliar a transferibilidade das rubricas otimizadas, fornecemos scripts para avaliação entre modelos. Para pegar rubricas otimizadas em um modelo de origem (Modelo A) e testar seu desempenho em um modelo alvo (Modelo B):
sh ./scripts/rubrics_cross_model_eval.sh
Para experimentos de desalinhamento de política downstream, focamos em Ultra-Real (utilidade) e Anthropic–SafeRLHF (inofensividade), treinando modelos de política diretamente em rótulos de preferência gerados pelas rubricas selecionadas.
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
Execute o pipeline de avaliação (você pode executar qualquer subconjunto de etapas) via:
sh scripts/dpo_eval.sh
O script de avaliação suporta as seguintes etapas:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}
