 xoreaxeaxeax/skitter-creek-bath-salts
Desbloqueando _tudo_ na CPU com DRAM scrambling

Desbloqueando tudo na CPU com embaralhamento de DRAM — PSP, C6, microcódigo, SMM, e qualquer outra coisa que as especificações deixaram de fora.
&x == &x.
Normalmente.
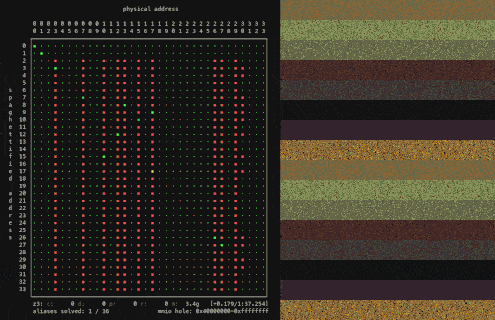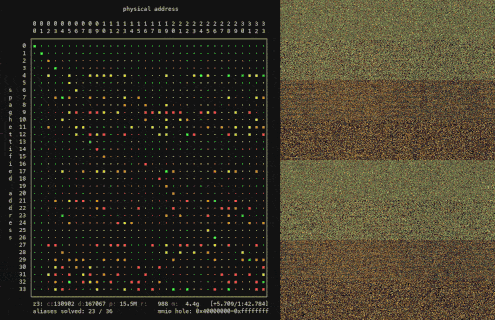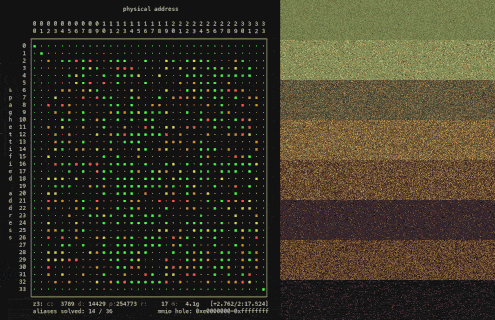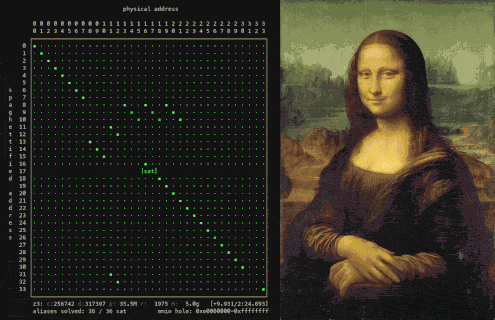
Cutuque o controlador de DRAM e um endereço pode ser feito para aterrissar onde você quiser na
memória. skitter-creek-bath-salts modifica as camadas inferiores da hierarquia de memória
para religar as traduções de endereços físicos da DRAM. Isso embaralha a
memória da plataforma, expondo regiões protegidas da DRAM — carveouts invisíveis até
para o kernel. Quando as traduções de endereços quebram, as primitivas de segurança
construídas sobre elas também quebram, e nós desbloqueamos tudo.
Desenvolvido e testado em CPUs AMD Family 16h, a última geração cujos
datasheets documentam os registradores de tradução do controlador de DRAM — e mostram que
eles não podem ser bloqueados. 17h e além simplesmente omitem essa informação. A
odisseia de *p é semelhante entre gerações e
arquiteturas, e as transformações subjacentes se estendem até a ARM, RISC-V, e
além; skitter-creek-bath-salts nos mostra apenas como começar.
*pÉ um longo caminho para baixo.
A memória é construída sobre camadas de abstração tão profundas que se tornam quase absurdas. Quando
seu código desreferencia *p, ele parece acessar a DRAM em p. Não acessa —
p é um endereço virtual, e antes que um único bit da DRAM seja tocado, ele deve
sobreviver à provação abaixo:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
Este projeto atua nos níveis mais profundos do pipeline `*p`, a camada MCT/DCT
— onde um endereço físico proveniente do data fabric/interconnect entra no
controlador de memória e é reescrito uma última vez nas coordenadas brutas da DRAM que são
emitidas para o DIMM.

---

## Espaguetificando a DRAM

> Endereços físicos são, na verdade, mais uma sugestão.```nasm
xor dword [0xf80c2094], 0x00400000
Esse é o exploit. Todo ele.
