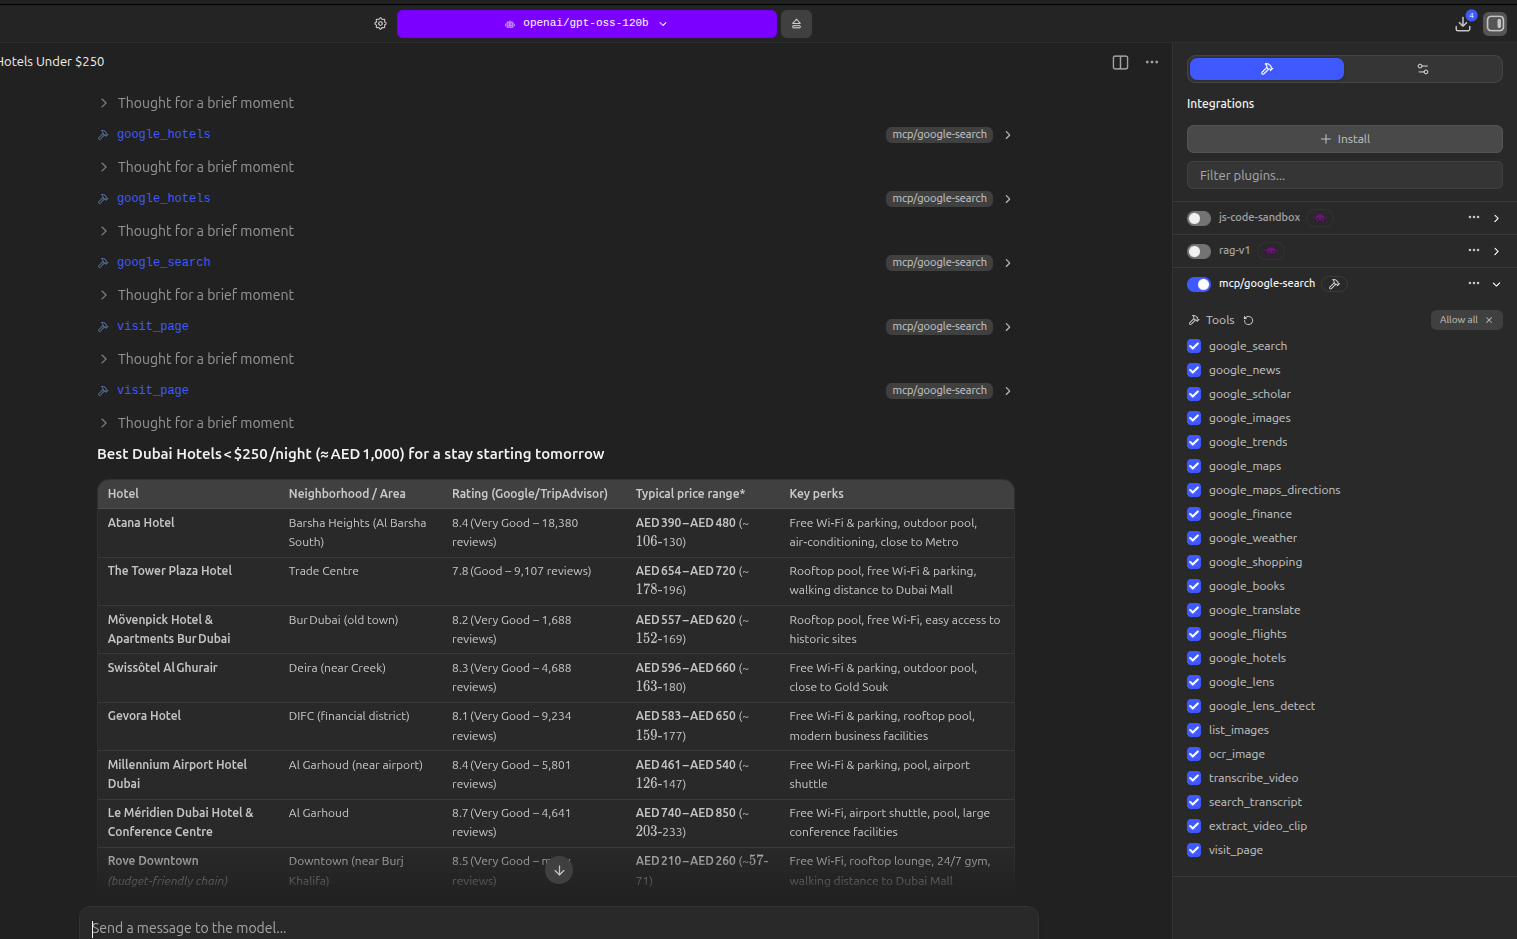
 vincentkaufmann/noapi-google-search-mcp
Servidor MCP para pesquisa no Google e obtenção de páginas usando Chromium headless

Se quiser apoiar o noapi-google-mcp ou o gpt-oss-20B/120B-Vision e outros modelos open source em desenvolvimento, por favor contribua para o meu fundo de computação GPU: cerca de $3000 são necessários.
Se achar útil, considere apoiar o desenvolvimento contínuo e novas funcionalidades.
BTC:16DT4AHemLyn7C6P116YepjY518gu9wUUH
ETH:
0x7287D1F9c77832cFF246937af0443622bFdACD04
38 ferramentas. Zero chaves de API. Dê a qualquer LLM local pesquisa real do Google, feeds ao vivo, visão, OCR e compreensão completa de vídeo.
Um servidor MCP que transforma seu LLM local num assistente totalmente conectado. Resultados reais do Google, feeds de notícias e redes sociais ao vivo, pesquisa reversa de imagens, OCR offline, transcrição do YouTube e extração de clipes — tudo rodando localmente através do Chromium headless e modelos de ML open source. Sem chaves de API, sem limites de uso, sem dependência de nuvem.
Funciona com LM Studio, Claude Desktop, OpenClaw, Ollama e qualquer cliente compatível com MCP.
O Google começou a detetar navegadores Chromium headless e a apresentar CAPTCHAs em vez de resultados de pesquisa (#2). Resolvemos isso corretamente e depois adicionámos um solucionador de CAPTCHA com rede neural só porque pudemos.
Patches de ocultação:
navigator.webdriver, plugins de navegador falsos, chrome.runtime e remove impressões digitais do Playwrightaarch64, agora corresponde ao binário real do Chromium)Solucionador de CAPTCHA com rede neural (MobileNetV2 + OpenCV):
Resolverá todos os CAPTCHAs? Não. Mas passará por alguns deles, e honestamente construímo-lo principalmente porque podíamos.
Um pipeline completo de recuperação aumentada local para o YouTube. Subscreva qualquer canal, e quando verificar os feeds o servidor baixa automaticamente o áudio, transcreve-o com Whisper e armazena a transcrição completa em SQLite com pesquisa de texto completo FTS5. Cada palavra de cada vídeo torna-se pesquisável — faça uma pergunta ao seu LLM e ele puxa a resposta do vídeo certo.
Encontrou algo interessante? Peça ao LLM para extrair esse segmento como um clipe. Ele lê a transcrição, encontra os timestamps exatos e corta o vídeo por si. Este é o início da edição de vídeo com IA/LLM — o seu LLM compreende o conteúdo e corta clipes com base no que está a ser dito, não apenas nos timestamps.
Como funciona:
subscribe a um canal do YouTube — pelo handle (@3Blue1Brown), URL ou ID do canalcheck_feeds — novos vídeos são obtidos e auto-transcritos localmente com faster-whisper. As transcrições são escritas na base de dados para pesquisa instantânea. Até 5 vídeos por verificação, em cache para que nada seja baixado novamente.search_feeds — pesquisa de texto completo em todas as transcrições. Suporta AND, OR, NOT e frases entre aspas. O seu LLM encontra o vídeo e a passagem exatos que respondem à sua pergunta.extract_video_clip — diga ao LLM o que lhe interessa e ele corta o clipe do vídeo. O LLM usa a transcrição para encontrar o segmento certo e extrai-o automaticamente.```
"Subscribe to @AndrejKarpathy on YouTube"
"Check my feeds"
"Search my feeds for backpropagation explained"
"What did Karpathy say about tokenization?"
"Extract the part where he explains gradient descent"
"Cut a clip of the hardware comparison section"Sem embeddings, sem banco de dados vetorial, sem API — apenas Whisper + SQLite FTS5 rodando na sua máquina.
> **Roteiro:** A extração de clipes é o primeiro passo para a edição de vídeo totalmente orientada por IA. Versões futuras adicionarão sobreposição de música/áudio, remix de vídeo, compilação de múltiplos clipes, reformatação vertical para TikTok/Reels/Shorts e resumos automáticos de destaques — tudo impulsionado pela sua LLM entender o conteúdo.
---
### Assinaturas de Feeds ao Vivo
Inscreva-se em notícias, Reddit, Hacker News, canais do YouTube, perfis do Twitter/X, repositórios do GitHub, artigos do arXiv e podcasts. O conteúdo é buscado, armazenado localmente no SQLite com pesquisa de texto completo e disponível para sua LLM instantaneamente.
| Nova Ferramenta | O Que Faz |
|----------|-------------|
| `subscribe` | Adicionar qualquer fonte — RSS de notícias, Reddit, HN, GitHub, arXiv, YouTube, podcasts, Twitter/X |
| `unsubscribe` | Remover uma assinatura e seu conteúdo armazenado |
| `list_subscriptions` | Ver todos os feeds ativos com contagens de itens |
| `check_feeds` | Consultar todas as assinaturas, buscar novo conteúdo, transcrever automaticamente vídeos do YouTube |
| `search_feeds` | Pesquisa de texto completo em tudo que seus feeds coletaram |
| `get_feed_items` | Navegar por itens recentes, filtrados por fonte ou tipo |
**Fontes de notícias pré-configuradas** — inscreva-se com uma palavra: `bbc`, `cnn`, `nyt`, `guardian`, `npr`, `aljazeera`, `techcrunch`, `ars`, `verge`, `wired`, `reuters`
**Atalhos do arXiv** — `ai`, `ml`, `cv`, `nlp`, `robotics`, `crypto`, `systems`, `hci````
"Subscribe to BBC News, r/LocalLLaMA, and Hacker News"
"Follow @elonmusk on Twitter"
"Subscribe to the YouTube channel @3Blue1Brown"
"Watch anthropics/claude-code on GitHub for new releases"
"Subscribe to the machine learning arXiv category"
"Check my feeds"
"Search my feeds for transformer architecture"
"What's new in my Reddit feeds?"
Transcreva reuniões, converta formatos, leia documentos — tudo local, sem nuvem.
| Nova Ferramenta | O Que Faz |
|---|---|
transcribe_local | Transcreva qualquer arquivo de áudio ou vídeo local com Whisper (mp3, wav, mp4, mkv, etc.) |
convert_media | Conversão de formato FFmpeg — vídeo para áudio, formato para formato, vídeo para GIF |
read_document | Extraia texto de PDF, DOCX, HTML, CSV, JSON e mais de 30 formatos de texto |
Baixe e-mails, gere códigos QR, encurte URLs, arquive páginas, consulte a Wikipédia, faça upload para S3.
