 ucsb-mlsec/vulnllm-r
LLM de raciocínio especializado para detecção de vulnerabilidades em código-fonte em C/C++ e Python, com construção de conjuntos de dados, treinamento SFT/DPO e scripts de reprodução de resultados.

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
python plots/plot_language_comparison_models.py --results-dir results/test_data
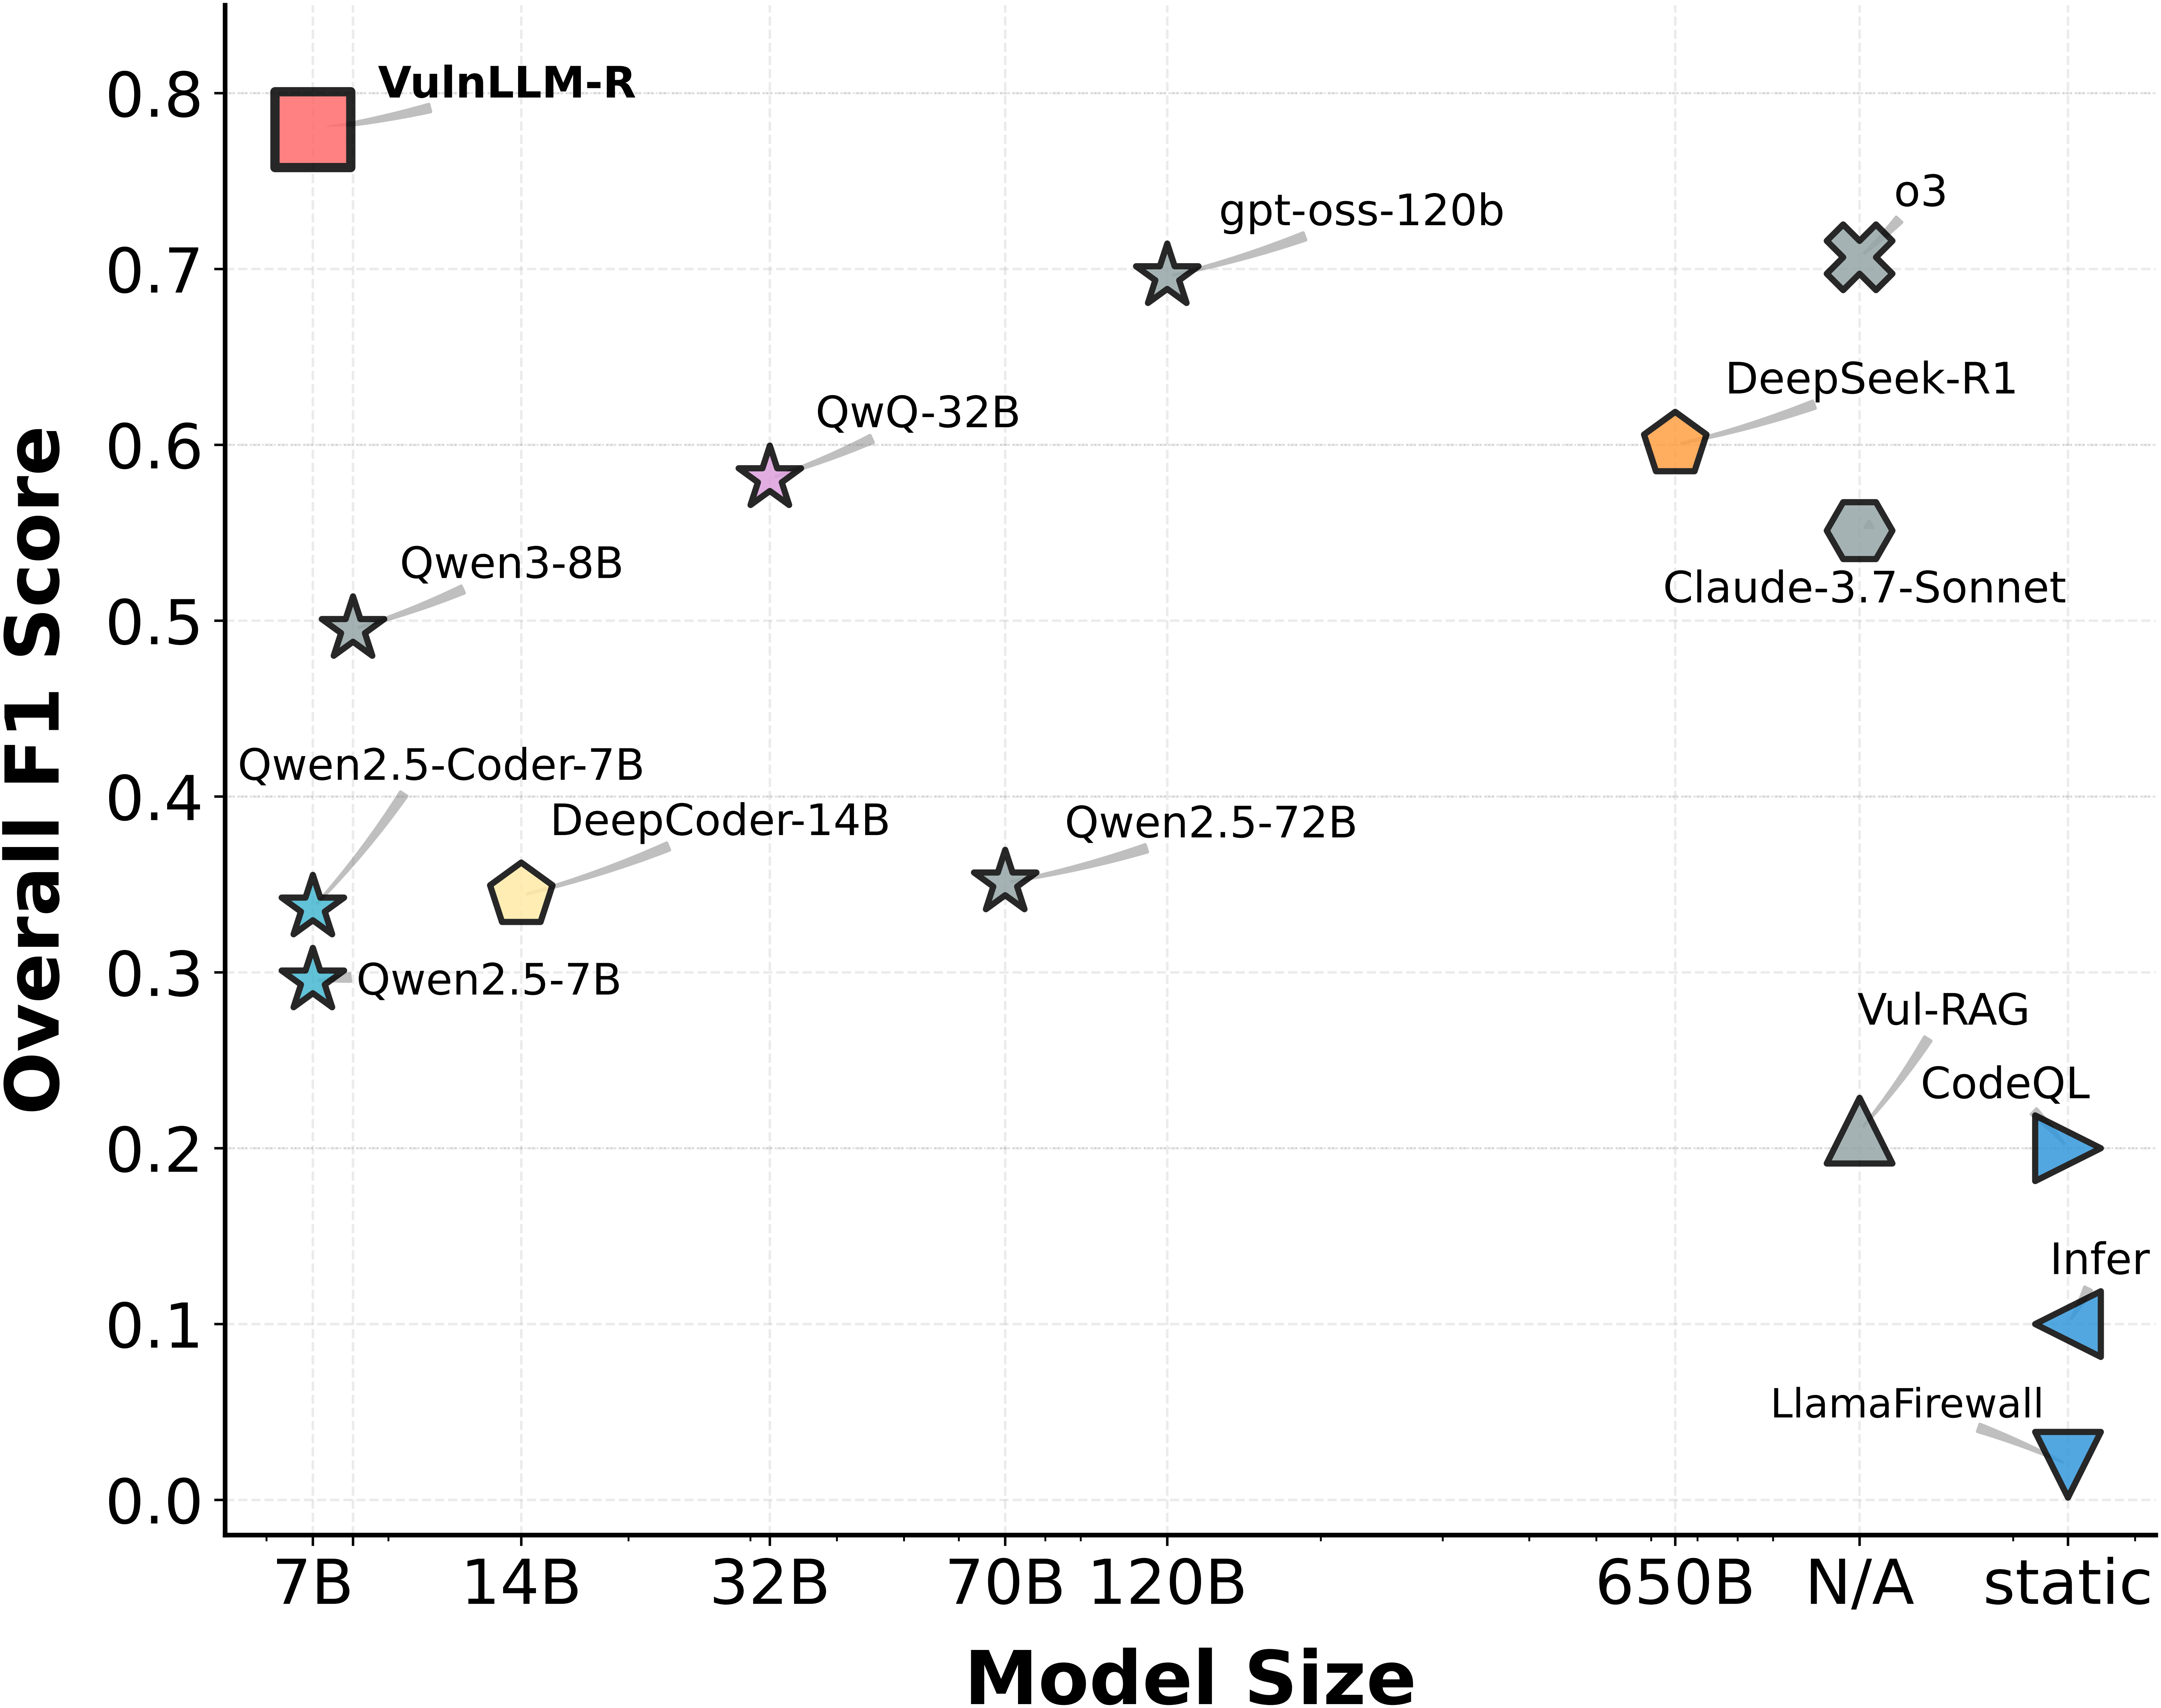
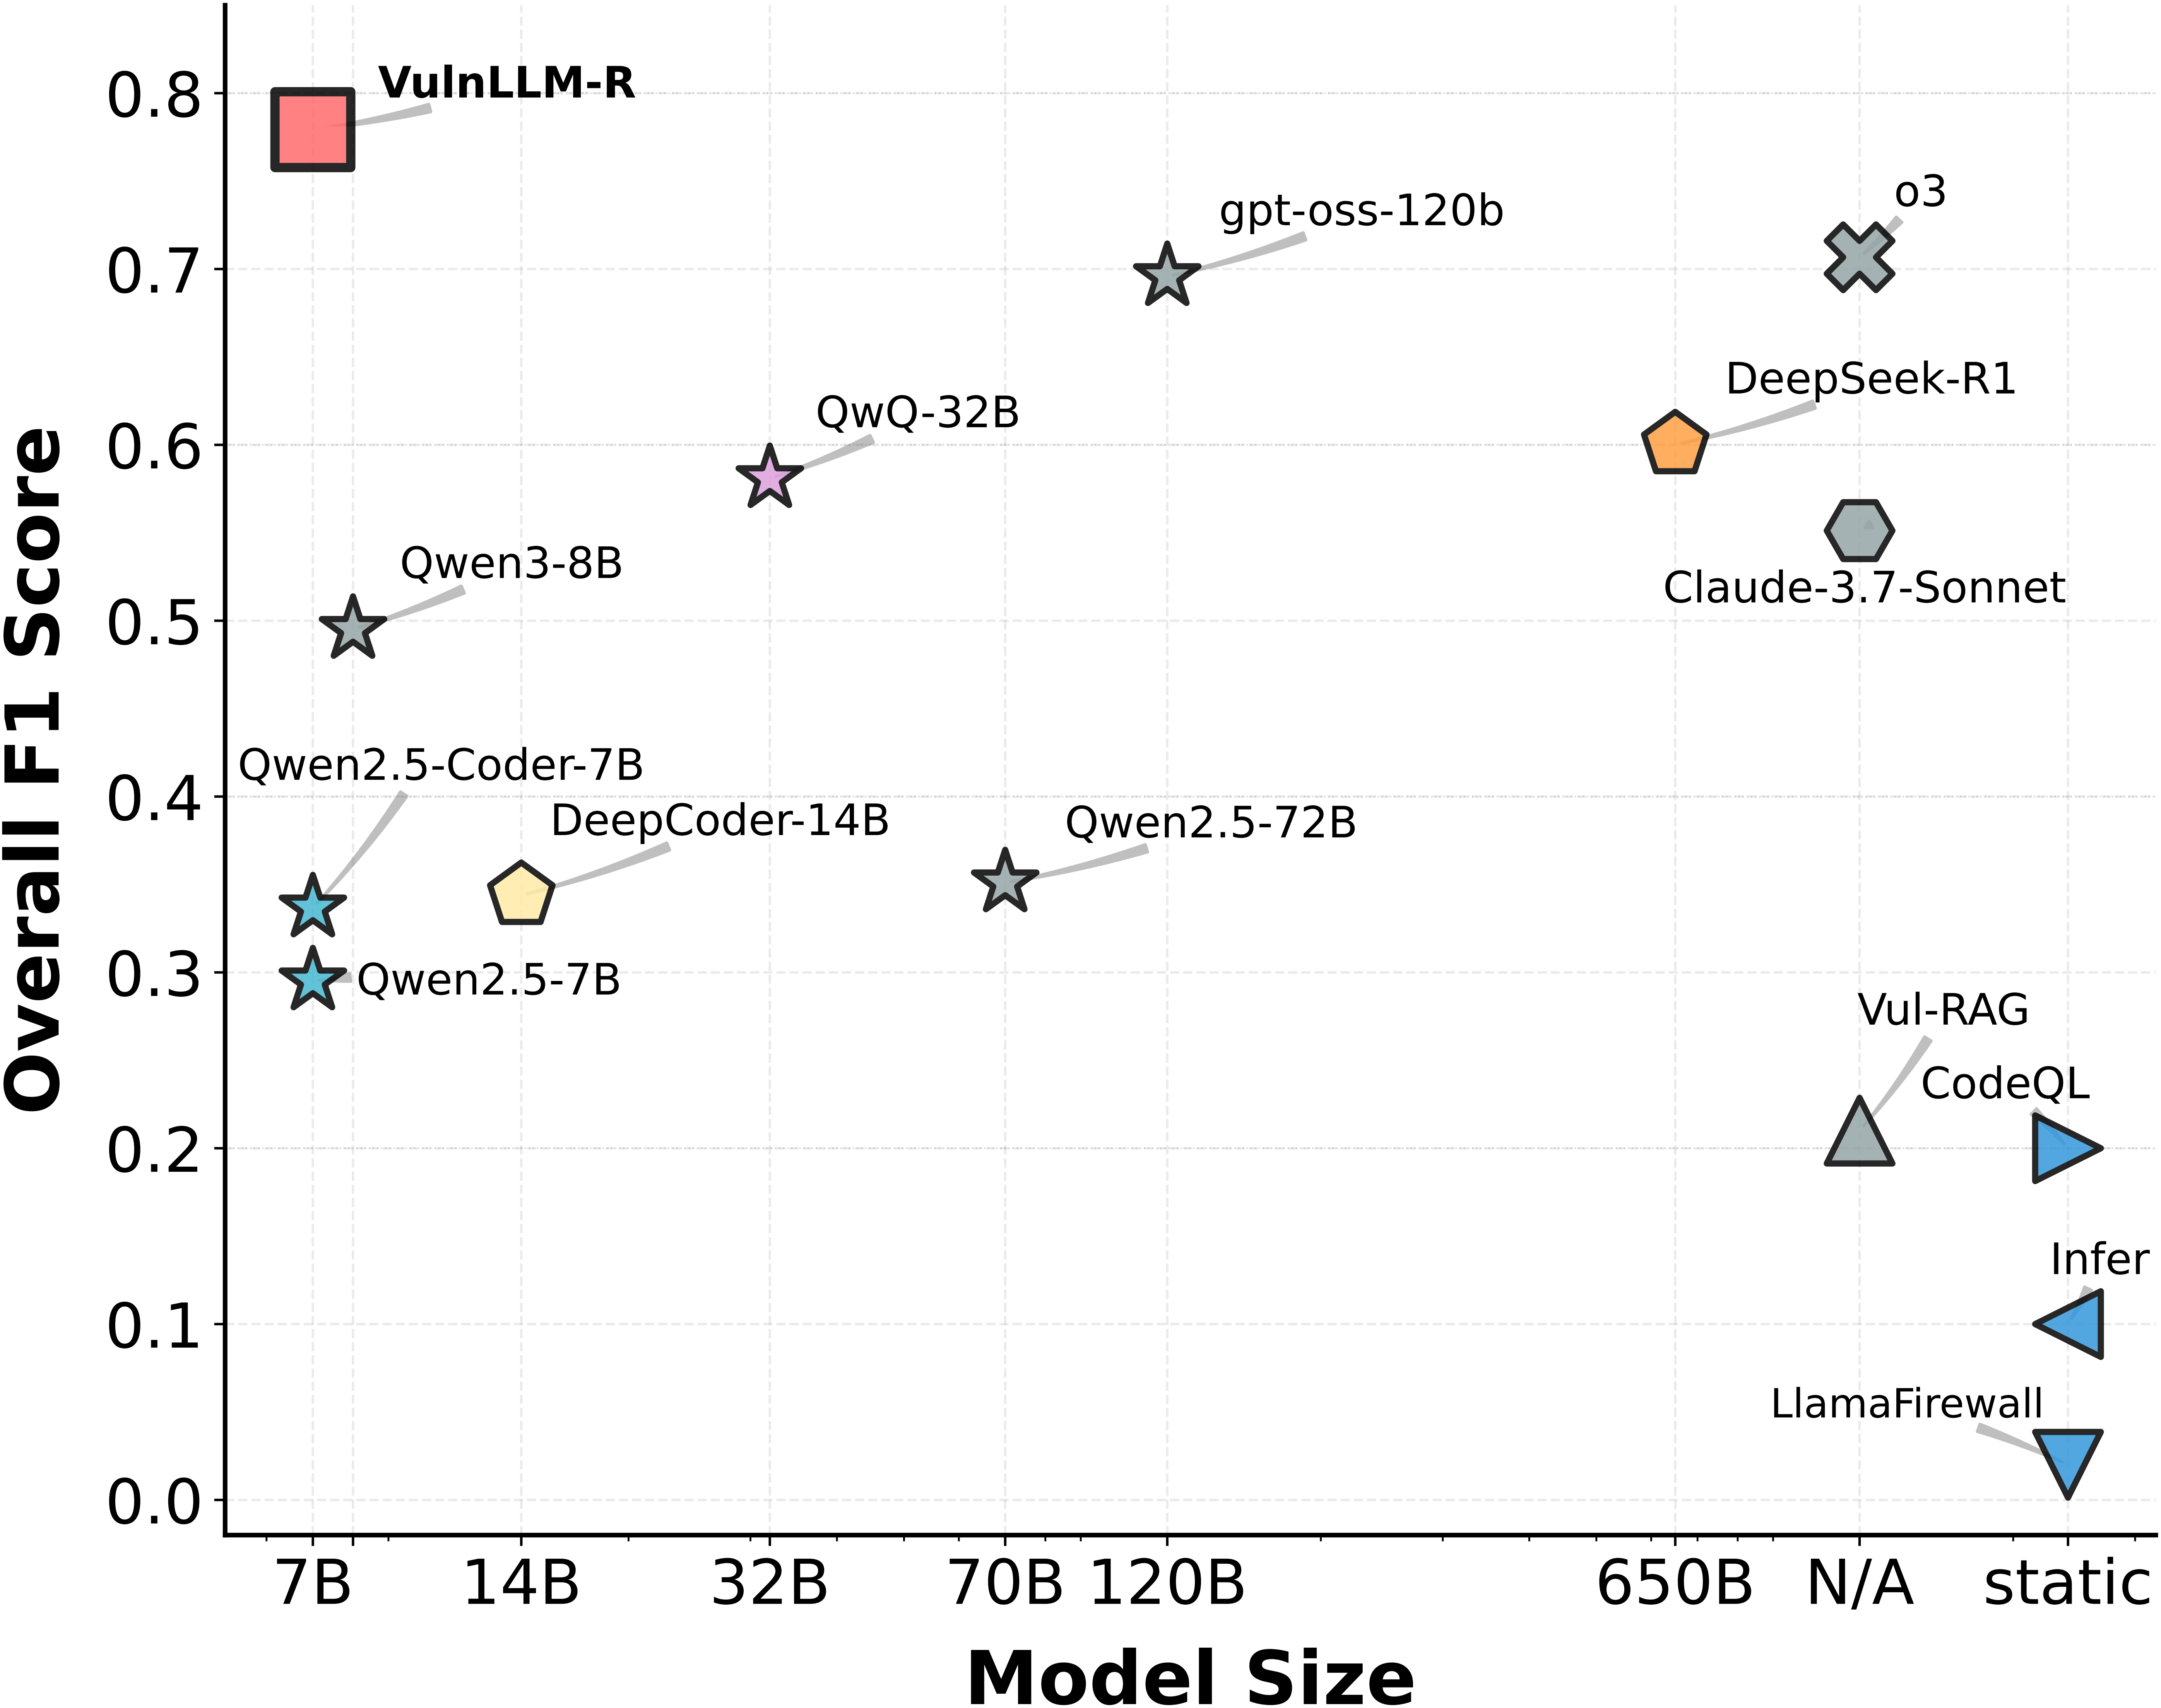
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
Também fornecemos a versão de raciocínio reduzido dos conjuntos de dados destilados:
Combine conjuntos de dados existentes de detecção de vulnerabilidades em nível de função: PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4], e Arvo [5]. Dentre esses conjuntos, o PrimeVul possui as funções mais complicadas. Criamos dois conjuntos de treinamento: limpo (sem PrimeVul) e ruidoso (com PrimeVul), para que possamos treinar em conjuntos relativamente simples e testar no complexo conjunto PrimeVul. Observe que nomeamos o conjunto de treinamento com PrimeVul como ruidoso não significa que o conjunto seja ruidoso. É um nome relativamente arbitrário que usamos no início.
vulscan/data_process/data_utils possui um conjunto de scripts para processar e combinar os
conjuntos de dados.
raw_to_us.py: Combina os dados brutos no nosso conjunto de dados e remove dados redundantescheck_cwe_correct.py: Calcula a precisão de cada categoria CWEgenerate_arvo_raw_data.py: Gera dados brutos estruturados a partir do conjunto de dados arvoarvo_to_us.py: Reformata os dados brutos estruturados do arvo para o formato do nosso conjunto de dadossplit_good_bad_for_juliet.py: Extrai dados do conjunto de dados bruto Juliet 1.3 e os converte para o formato
necessário, formando parte do nosso clean_dataset cadd_sven_to_clean_dataset.py: Extrai dados do conjunto de dados Sven, formando parte do nosso clean dataset Csync_large_small.py: Sincroniza as modificações de noisy_dataset/large_train/c para
noisy_dataset/small_train/cremove_testing_from_training.py: Adiciona a tag human a cada dado, significando que o ponto foi verificado por
humanos e usado como dado de teste
-data_utils.py: Adiciona o campo related_cwe ao conjunto de dados.datasets/clean_dataset: os dados de treinamento sem PrimeVul
datasets/clean_dataset/python contém os dados de SVEN e SecCodePLTdatasets/clean_dataset/c contém os dados de Juliet e SVENdatasets/noisy_dataset
datasets/noisy_dataset/small_train: Contém os dados de treinamento de PrimeVul e SVEN com CWEs selecionadas (
usamos os dados do PrimeVul neste conjunto como treinamento)datasets/noisy_dataset/large_train: Contém os dados de treinamento de PrimeVul, SVEN e SecCodePLT com
mais CWEs (Este conjunto pode ser usado posteriormente para treinar modelos maiores)datasets/noisy_dataset/test: Um pequeno conjunto de teste do PrimeVul verificado por humanosdatasets/test
datasets/test/test_clean: Os dados de teste de SVEN, SecCodePLT e Juliet; com CWEs OOD que não fazem
parte do conjunto de treinamentodatasets/test/test_primevul_pair: Os dados de teste originais do PrimeVulvulscan/data_process/data_utils/get_cwe_stat.py para obter o histograma do conjunto de dados| Dataset | Linguagem | Treinamento/Teste | CWE | # Benigno | # Vulnerável | comprimento médio |
|---|---|---|---|---|---|---|
| Limpo (seccodeplt) | Python | Treinamento | 20 | 1281 | 1281 | 741 |
| Limpo (juliet) | C/C++ | Treinamento | 22 | 1716 | 1653 | 3689 |
| Difícil (primevul filtrado) | C/C++ | Treinamento | 26 | 2717 | 2952 | 4689 |
| Contexto Longo (Oss-fuzz) | C/C++ | Treinamento | 3 | 475 | 604 | 12761 |
| Simples (seccodeplt) | Python | Teste | 24 (6 ood) | 74 | 74 | 814 |
| Simples (juliet) | C/C++ | Teste | 38 (14 ood) | 358 | 376 | 2575 |
| Difícil (PrimeVul, SecLLMHolmes) | C/C++ | Teste | 13 (5 ood) | 145 | 152 | 4545 |
| Contexto Longo (Oss-fuzz) | C/C++ | Teste | 3 (0 ood) | 0 | 320 | 18929 |
| teste primevul (ruidoso) | C/C++ | Teste | 56 (34 ood) | 421 | 422 | 5341 |
