 suraj-ranganath/stealthrl
StealthRL: framework de RL para parafrasear adversariamente texto de IA para testar a robustez do detector.

Paper (arXiv)
Demo
Modelo (Hugging Face)
Conjunto de Dados de Benchmark (Hugging Face)
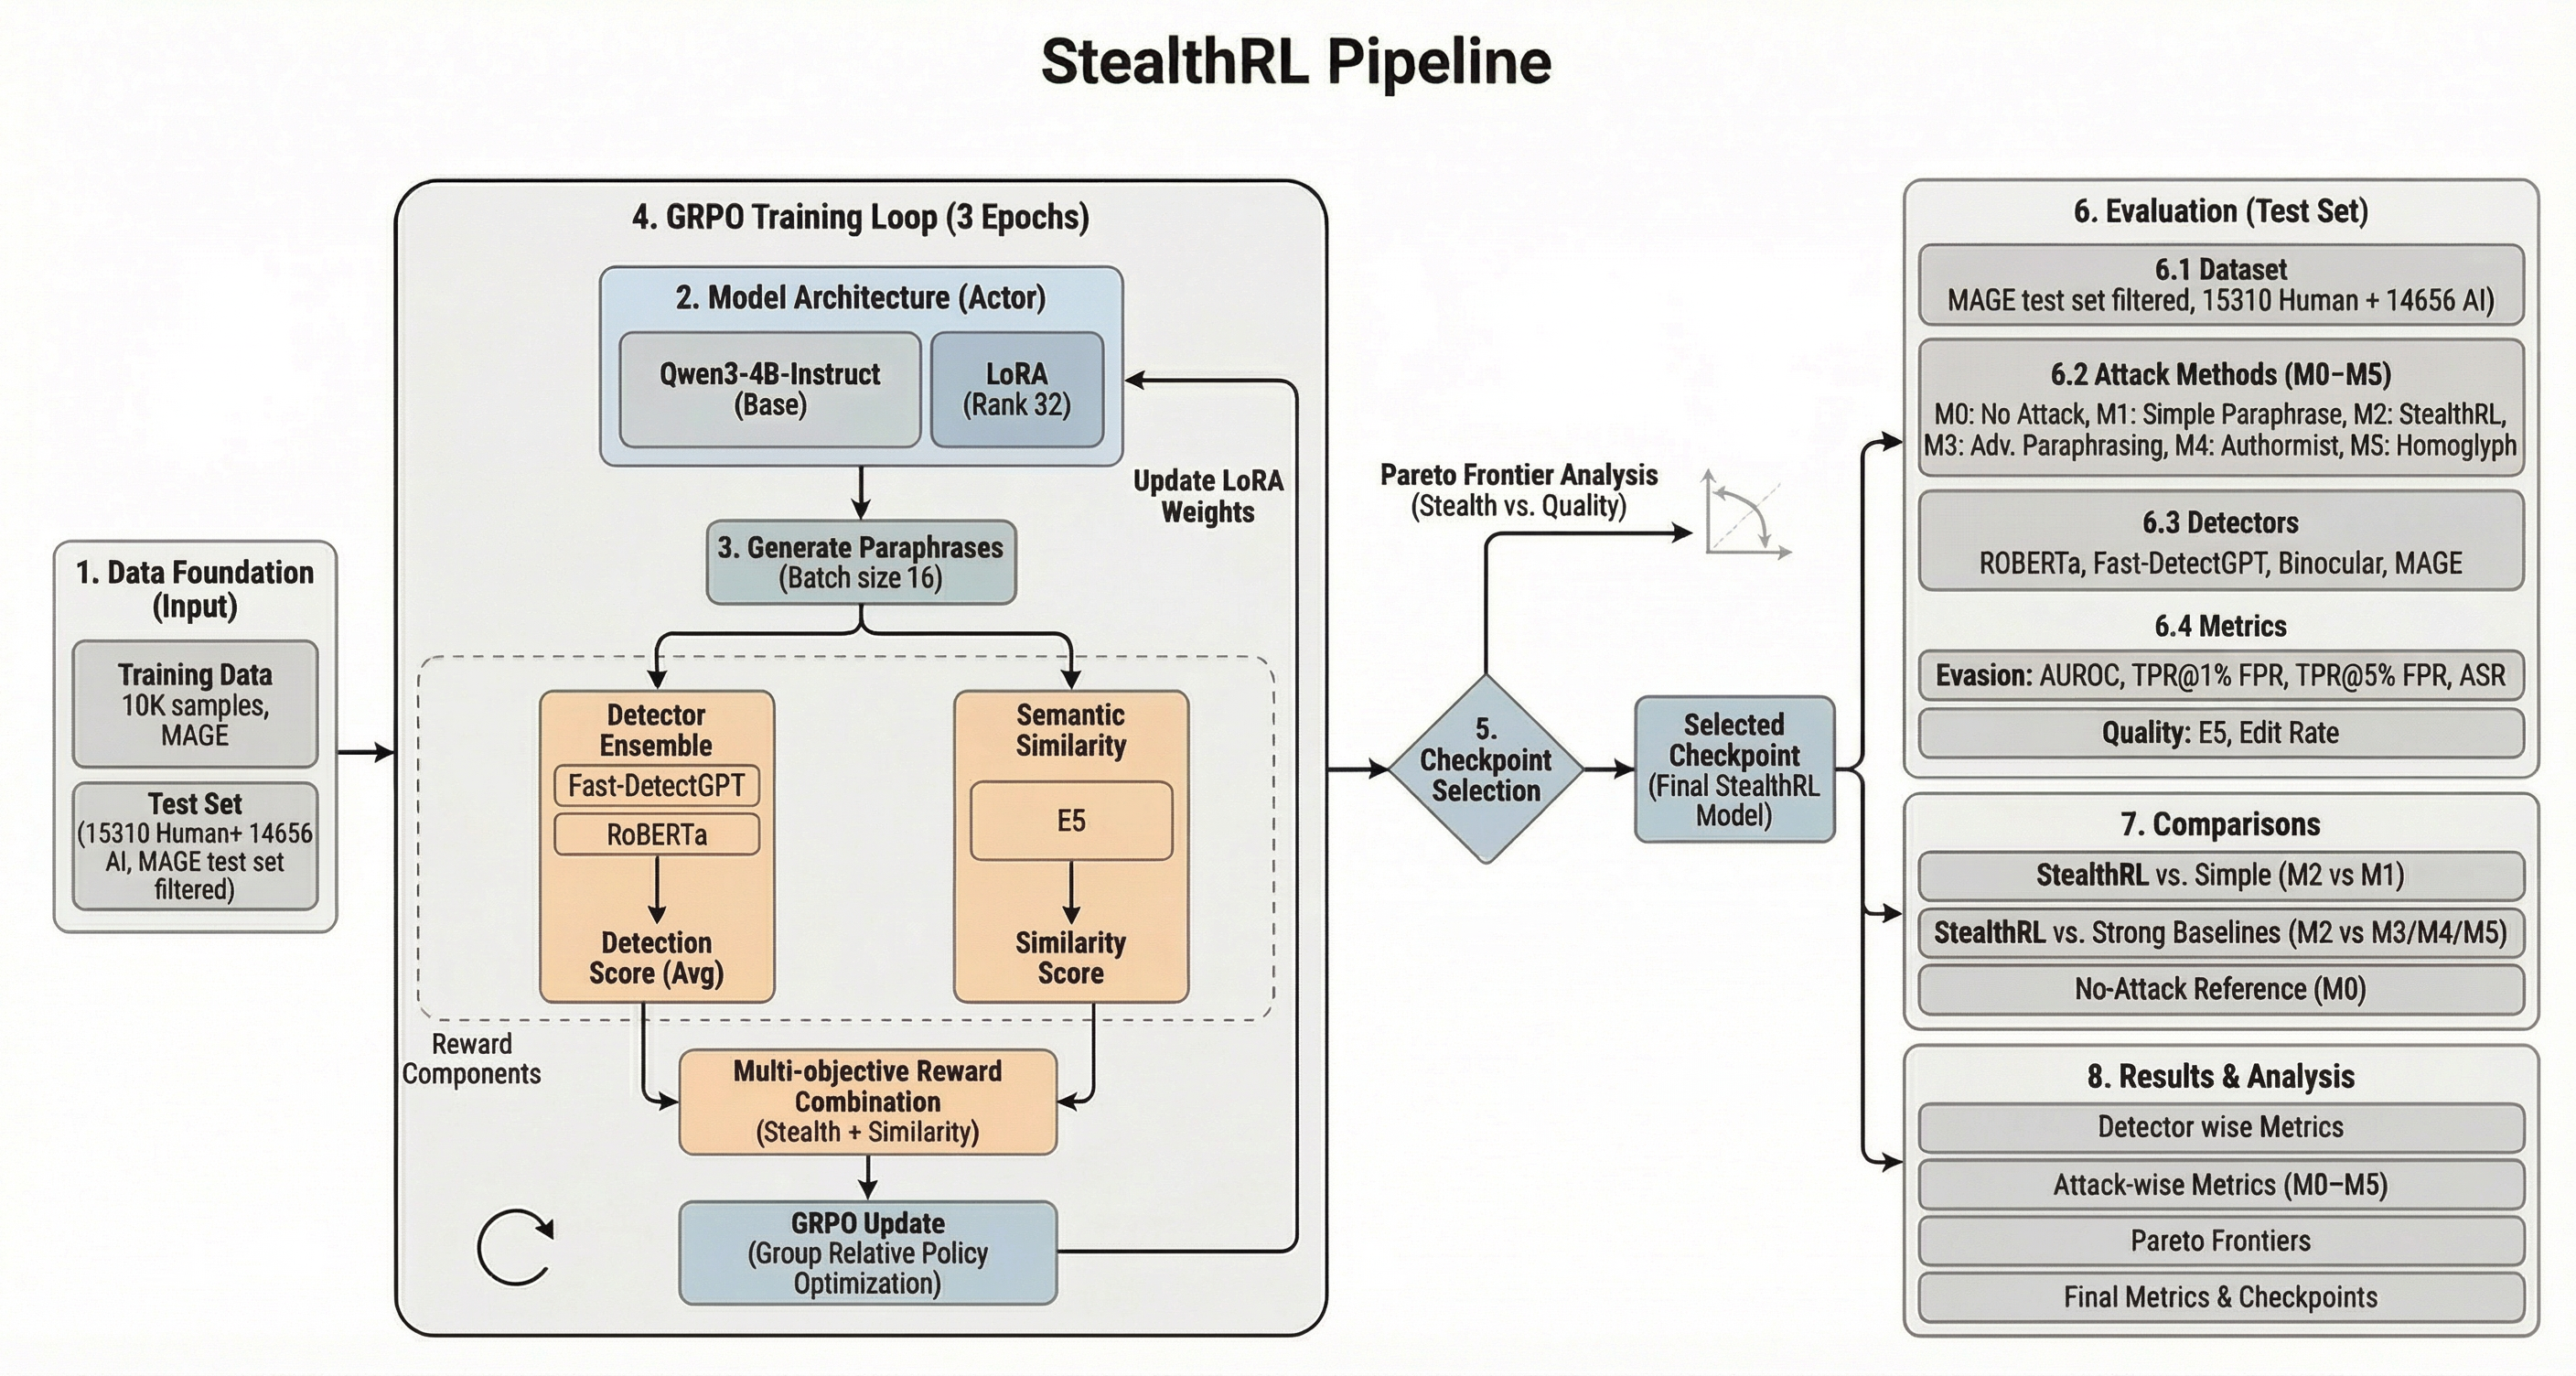
Detectores de texto de IA são cada vez mais usados em contextos de alto risco, mas sua robustez a reescritas adversariais que preservam o significado permanece incerta. Apresentamos o StealthRL, uma estrutura de aprendizado por reforço para testar a resistência de detectores de texto de IA com ataques de paráfrase adaptativos. O StealthRL treina uma política de paráfrase contra um conjunto de detectores, preservando o conteúdo semântico, e então avalia a transferência para famílias de detectores não utilizadas no treinamento. No pool completo de teste MAGE filtrado (15.310 amostras humanas / 14.656 amostras de IA), o StealthRL reduz a AUROC média de 0,79 para 0,43 e atinge um TPR médio de 0,024 @ 1%FPR entre RoBERTa, Fast-DetectGPT, Binoculars e MAGE. O ataque transfere-se para dois detectores não utilizados durante o treinamento, expondo vulnerabilidades compartilhadas, em vez de uma falha em um único detector. Analisamos ainda as distribuições das pontuações dos detectores e avaliamos a qualidade com E5, BERTScore e classificações Likert baseadas em LLM. Nossos resultados mostram que os atuais detectores de texto de IA permanecem frágeis sob pressão realista de paráfrase e fornecem um protocolo reproduzível para avaliação de robustez adversarial.
Este repositório é a base de código de pesquisa e engenharia por trás do StealthRL. Ele contém:
O repositório pretende ser um ponto de partida útil para pesquisadores que desejam:
stealthrl/: código de treinamento, wrappers de detectores, recompensas, utilitários de dados e o pacote original StealthBencheval/: harness de avaliação de nível de pesquisa usado para os resultados do artigoscripts/: pontos de entrada executáveis para treinamento, avaliação, orquestração, gráficos e utilitáriosconfigs/: configurações YAML para treinamento, avaliação e ablaçõesfigures/: diagramas do pipeline e ativos estáticostests/: testes de integração e sanidadeanalysis/: auxiliares de análise ad hoc e utilitários pontuaispython -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
Dependendo de quais partes do projeto você deseja executar, também pode ser necessário:
pip install tinker
pip install openai
pip install vllm
Observações:
tinker é necessário para o caminho de inferência de checkpoint StealthRL baseado em nuvem usado pelo M2.openai é necessário apenas para a etapa de avaliação de qualidade GPT/Likert.vllm é recomendado para geração local rápida nas linhas de base do artigo.Variáveis de ambiente típicas usadas pelo repositório:
export HF_HOME=$HOME/.cache/huggingface
export TRANSFORMERS_CACHE=$HF_HOME
export OPENAI_API_KEY=...
export TINKER_API_KEY=...
Para o pipeline de avaliação em estágios do artigo, usamos um arquivo env mais um JSON descritor de checkpoint. Os scripts públicos permitem substituir ambos os caminhos explicitamente:
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_eval.py --quick
python scripts/run_stealthbench.py --config configs/stealthbench.yaml
Isso agora carrega os arquivos de texto configurados, executa os detectores configurados, salva saídas CSV e gera gráficos de comparação. O antigo stub apenas com TODO foi removido.
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_public \
  --gpus 0 1 2 3
O repositório inclui um site de demonstração baseado em FastAPI em demo/. Ele serve uma interface de usuário estática polida e expõe POST /api/paraphrase com suporte a chave de API mais uma cota pública de 20/dia para usuários não autenticados.
pip install -r demo/requirements.txt
uvicorn demo.stealthrl_demo.app:app --reload --port 8080
Por padrão, a demo executa em modo mock de custo zero para teste de interface. Para usar o amostrador StealthRL real, defina STEALTHRL_DEMO_INFERENCE_BACKEND=tinker, STEALTHRL_DEMO_CHECKPOINT_JSON e TINKER_API_KEY. Consulte demo/README.md para notas sobre chave de API, cota, Docker e implantação AWS.
O artigo relata resultados no pool de avaliação MAGE completo filtrado:
O pipeline de avaliação de nível de pesquisa é implementado no módulo eval/ mais os scripts em estágios em scripts/.
Prepare as credenciais e metadados do checkpoint.
Crie um arquivo env contendo OPENAI_API_KEY e TINKER_API_KEY, e um JSON de checkpoint descrevendo o caminho do amostrador Tinker do StealthRL.
Execute a verificação pré-voo.
python scripts/preflight_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_repro \
  --gpus 0 1 2 3
Inspecione as saídas dos métodos gerados, pontuações dos detectores, métricas e gráficos no diretório de execução escolhido.
Se você precisar apenas reexecutar o julgamento de qualidade baseado em GPT em saídas em cache:
python scripts/run_gpt_quality_only.py \
  --run-root outputs/eval_runs/full_mage_repro \
  --env-file ~/.config/stealthrl/eval.env
python scripts/compute_bertscore_for_run.py \
  --run-dir outputs/eval_runs/full_mage_repro/assembled \
  --device cuda:0 \
  --batch-size 16 \
  --chunk-size 512
O script BERTScore atualiza quality.parquet e quality.csv imediatamente após cada bloco, para que execuções interrompidas possam ser retomadas sem recalcular linhas concluídas. Use --limit-per-method para um pequeno teste de fumaça e --force apenas quando for necessário recalcular colunas BERTScore existentes intencionalmente.
