 rodricios/wxpath
wxpath - raspagem web declarativa com XPath; uma Linguagem de Consulta Web (WQL)


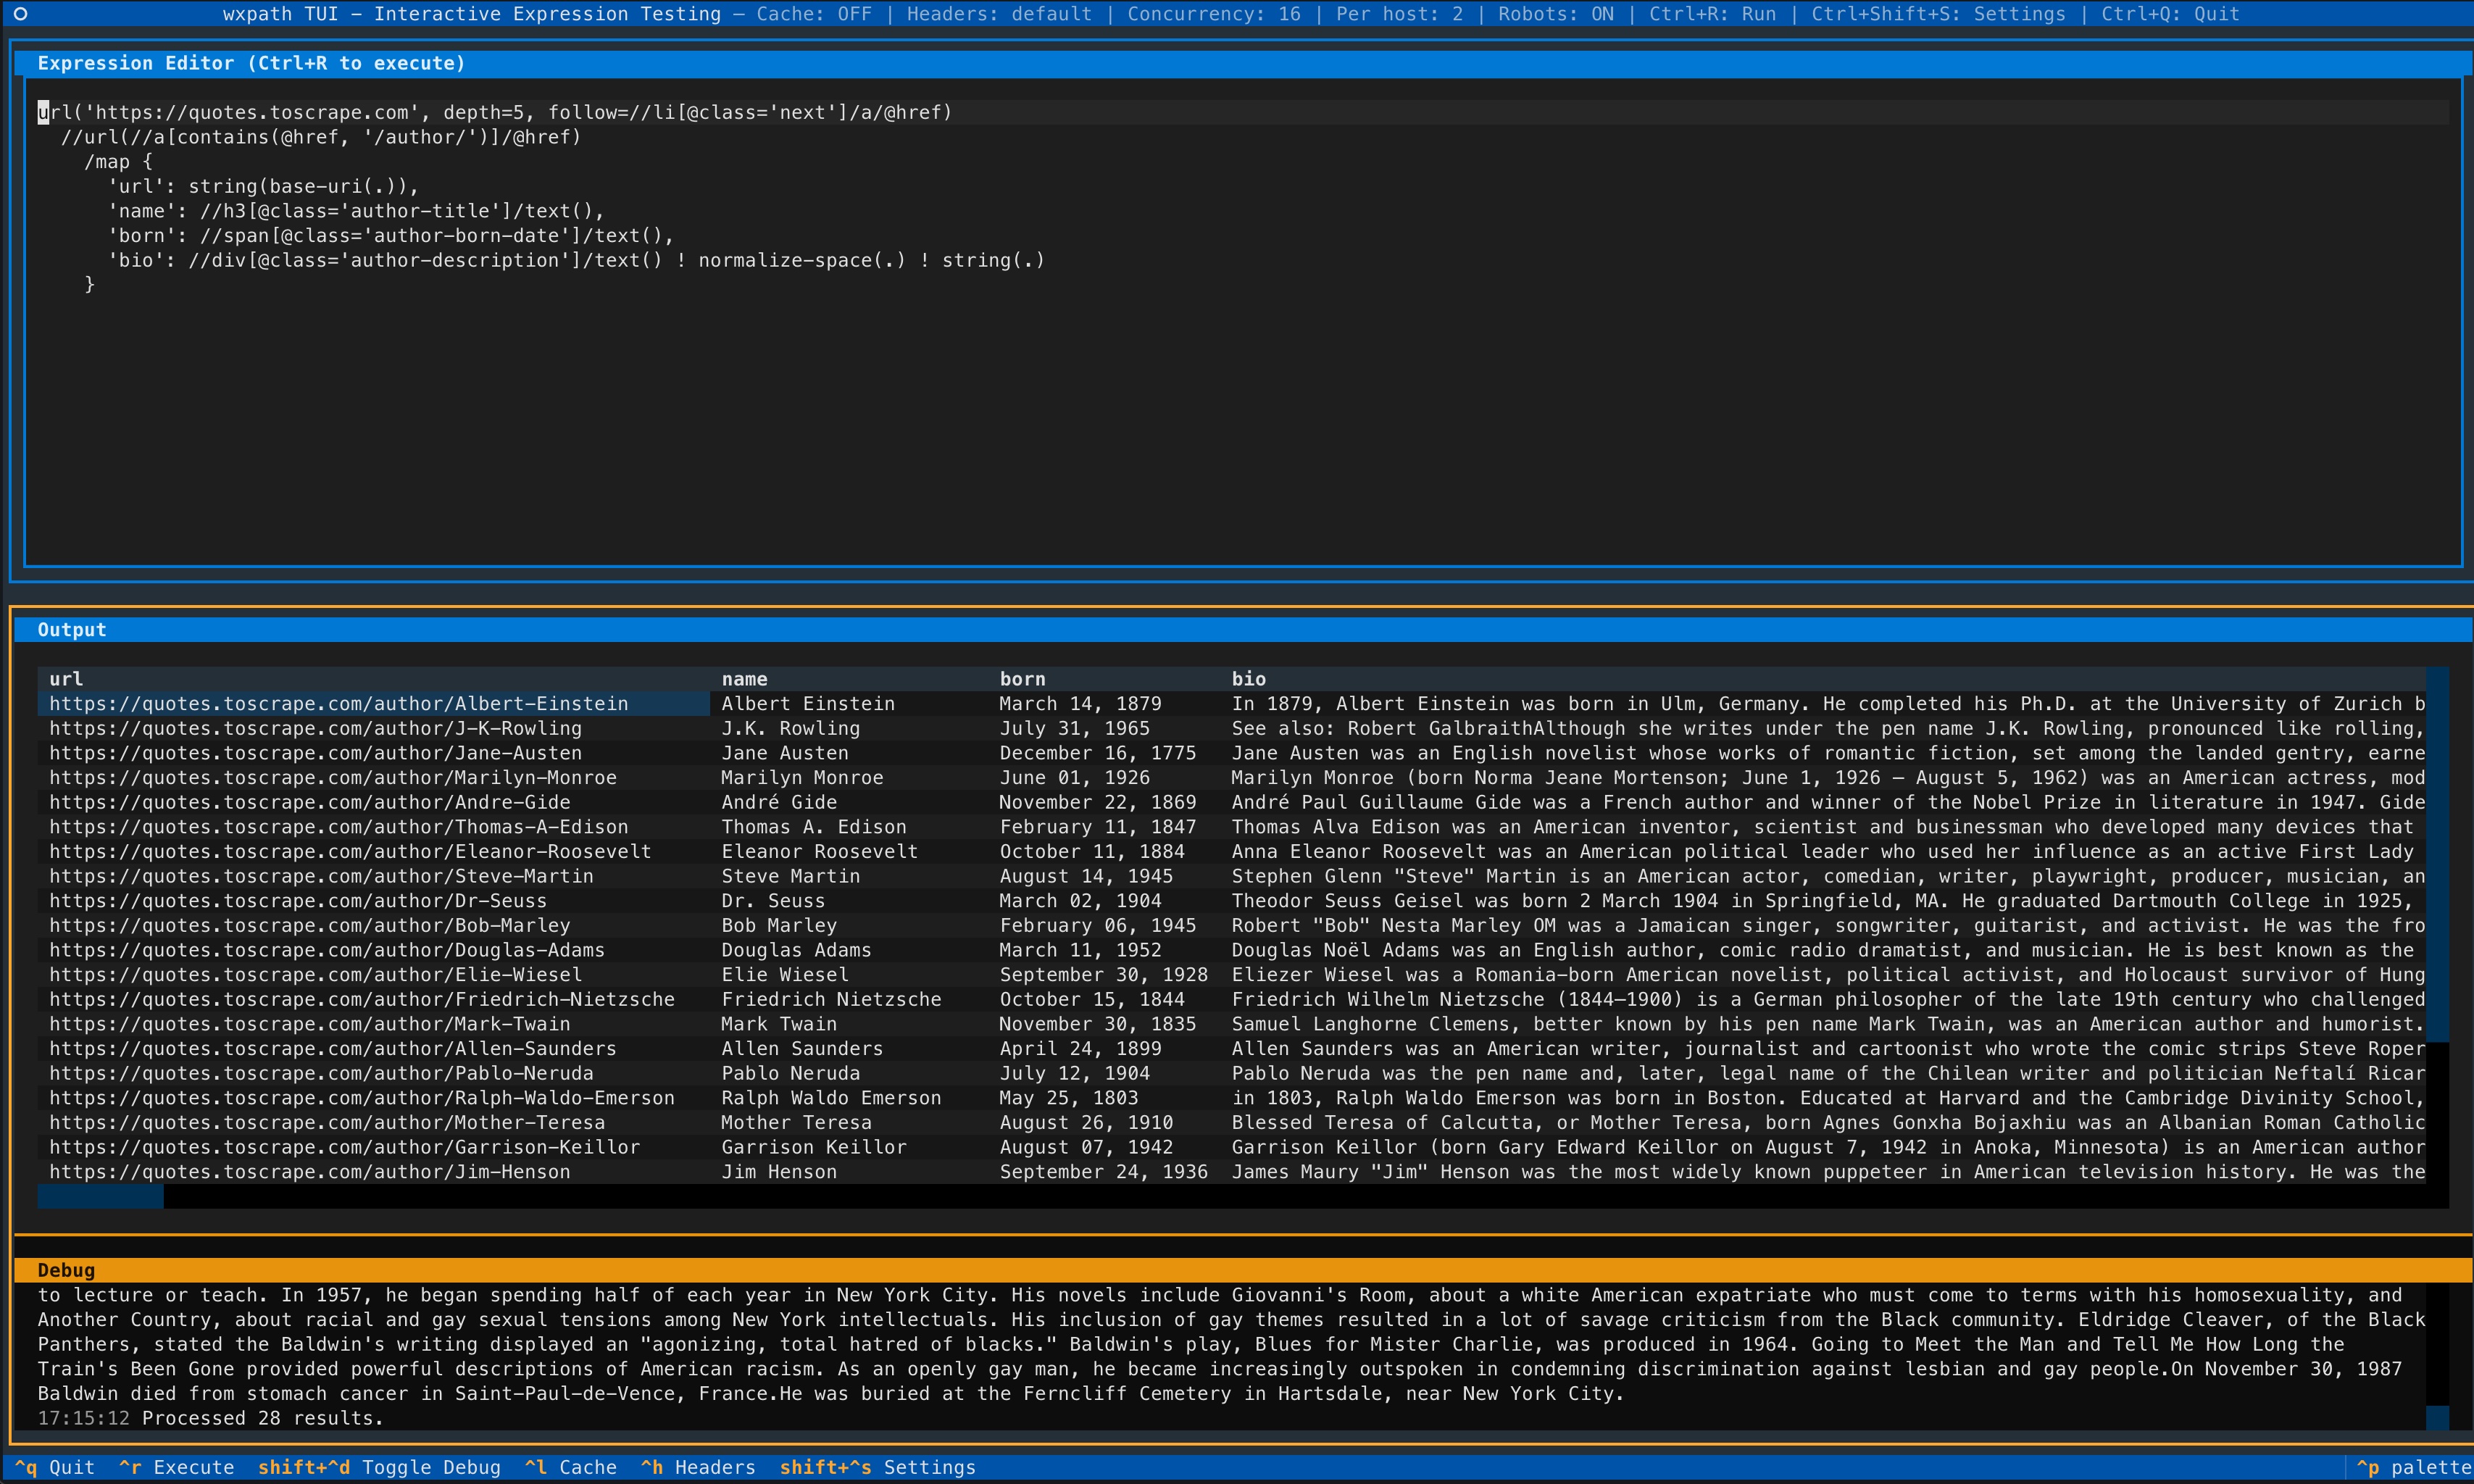
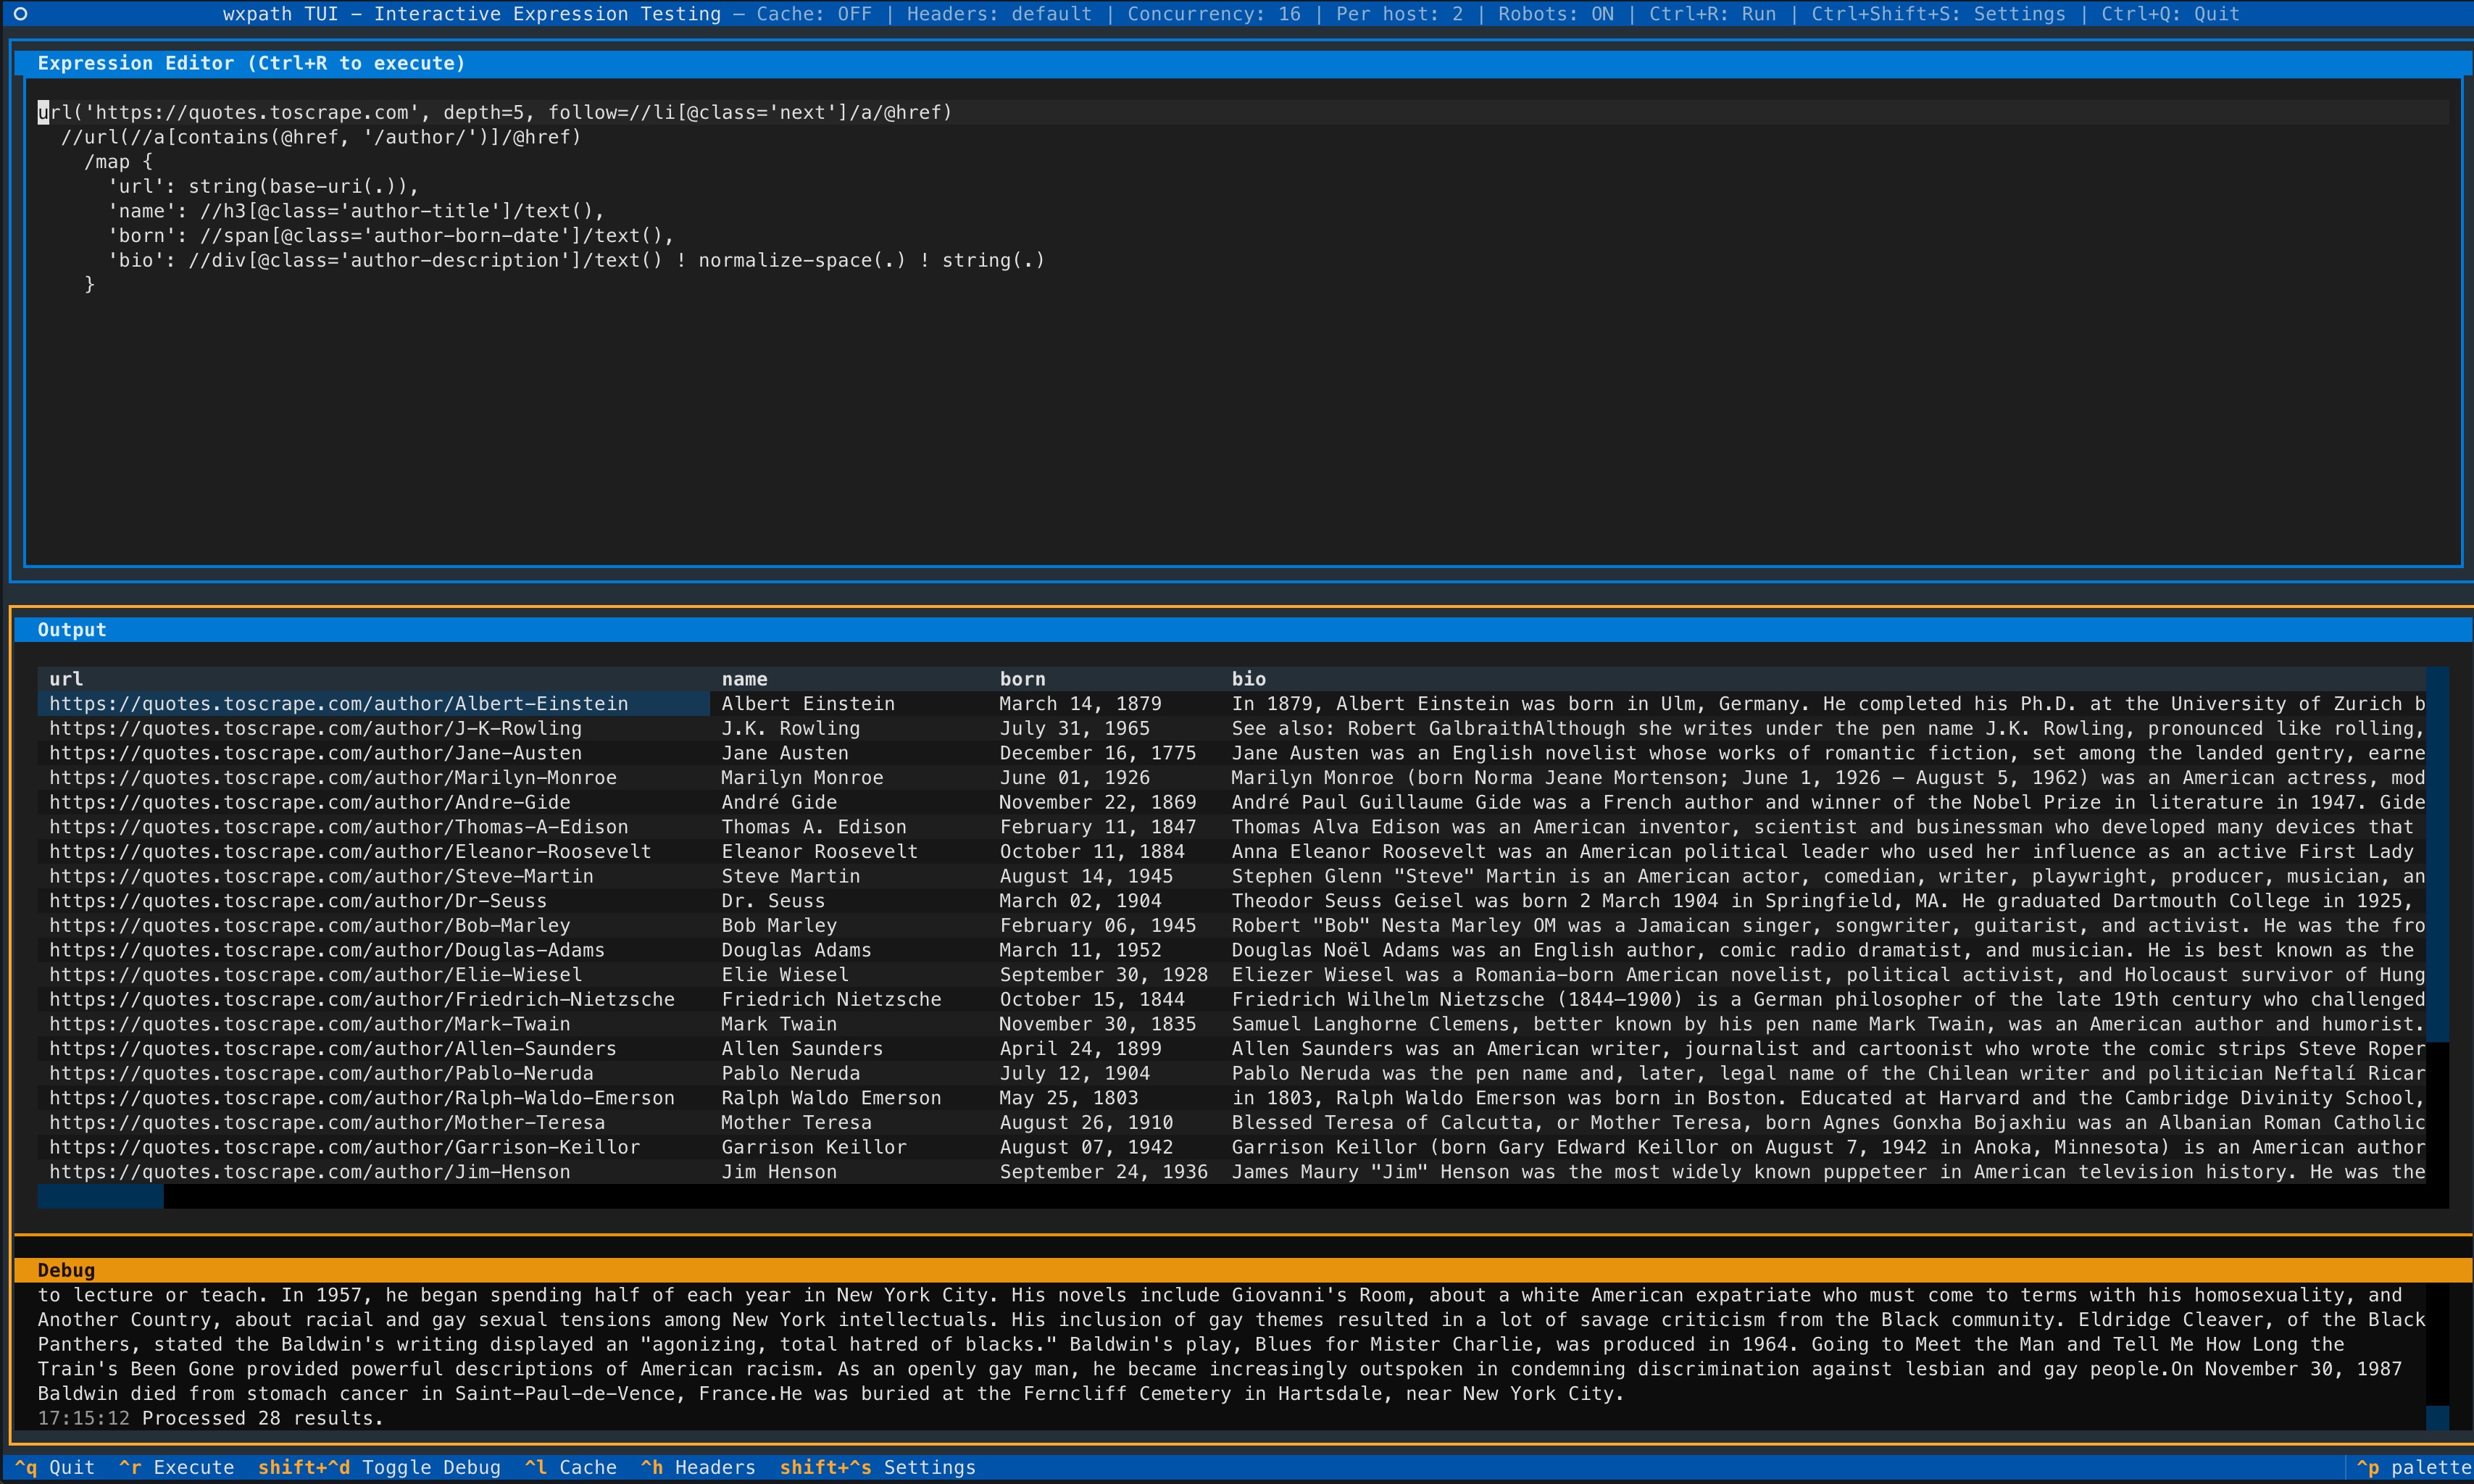
NOVO: TUI - Interface de terminal interativa (alimentada por Textual) para testar expressões wxpath e exportar dados.
Requer Python 3.10+.
pip install wxpath
# Para suporte TUI:
pip install "wxpath[tui]"
# Inicie imediatamente a TUI via uv:
uvx --from "wxpath[tui]" wxpath-tui
wxpath é um rastreador web declarativo onde a travessia é expressa diretamente em XPath. Em vez de escrever loops de rastreamento imperativos, wxpath permite descrever o que seguir e o que extrair em uma única expressão. wxpath executa essa expressão concorrentemente, de forma aproximadamente breadth-first, e transmite os resultados à medida que são descobertos.
Esta expressão busca uma página, extrai links e os transmite concorrentemente - nenhum loop de rastreamento necessário:
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
Ao introduzir o operador url(...) e a sintaxe ///, o mecanismo do wxpath é capaz de realizar rastreamento e extração recursivos (ou paginados):
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
A maioria dos scrapers web força você a escrever o fluxo de controle do rastreamento primeiro, e a extração depois.
wxpath converge essas duas etapas em uma:
Extraia hierarquias JSON limpas e estruturadas diretamente do grafo - alimente seus LLMs com sinal, não ruído. Consulte Integração com LangChain para mais detalhes.
wxpath é determinístico (leia-se: não alimentado por LLMs). Embora não possamos garantir que a rede seja estável, podemos garantir que a travessia é.
A documentação agora está disponível aqui.
url(...) e ///url(...) Explicadosimport wxpath
from wxpath.settings import CRAWLER_SETTINGS
# Custom headers for politeness; necessary for some sites (e.g., Wikipedia)
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contact: [email protected])'}
# Crawl, extract fields, build a knowledge graph
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
Nota: Alguns sites (incluindo a Wikipedia) podem bloquear requisições sem cabeçalhos adequados.
Consulte Avançado: Configuração do Mecanismo e Rastreador para definir um User-Agent personalizado.
A expressão acima faz o seguinte:
https://en.wikipedia.org/wiki/Expression_language.<main> que começam com /wiki/ e não contêm dois pontos (:).url(...) e ///url(...) Explicadosurl(...) é um operador personalizado que busca o conteúdo da URL especificada pelo usuário ou gerada internamente e o retorna como um lxml.html.HtmlElement para processamento XPath adicional.///url(...) indica um rastreamento profundo. Diz ao mecanismo de tempo de execução para continuar seguindo links até a max_depth especificada. Ao contrário de saltos repetidos com url(), permite que uma única expressão descreva uma exploração de grafo mais profunda. AVISO: Use com cautela e restrições (via max_depth ou predicados XPath) para evitar explosão de travessia.Consulte DESIGN.md para detalhes do design da linguagem. Você verá os conceitos centrais e projetará a linguagem desde o início.
wxpath avalia uma expressão como uma lista de etapas de travessia e extração (internamente chamadas de Segments).
url(...) cria tarefas de rastreamento estaticamente (via uma URL fixa) ou dinamicamente (via uma URL derivada da expressão XPath). URLs são deduplicadas globalmente, na melhor das hipóteses - não por profundidade.
Segmentos XPath operam em documentos buscados (buscados via as operações url(...) imediatamente anteriores).
///url(...) indica rastreamento profundo - prossegue de forma aproximadamente breadth-first até max_depth.
Os resultados são gerados assim que estão prontos.
wxpath é focado em asyncio/aiohttp, fornecendo uma API assíncrona para rastrear e extrair dados.
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
wxpath também fornece uma API assíncrona em sincronia, permitindo rastrear várias páginas concorrentemente enquanto mantém a simplicidade do código síncrono. Isso é particularmente útil para rastreamentos em ambientes de execução estritamente síncronos (ou seja, não dentro de um loop de eventos asyncio) onde o desempenho é uma preocupação.
from wxpath import wxpath_async_blocking_iter

path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
items = list(wxpath_async_blocking_iter(path_expr, max_depth=1))
