 renatus-cartesius/reconswarm
Amplie seu reconhecimento com o poder da nuvem

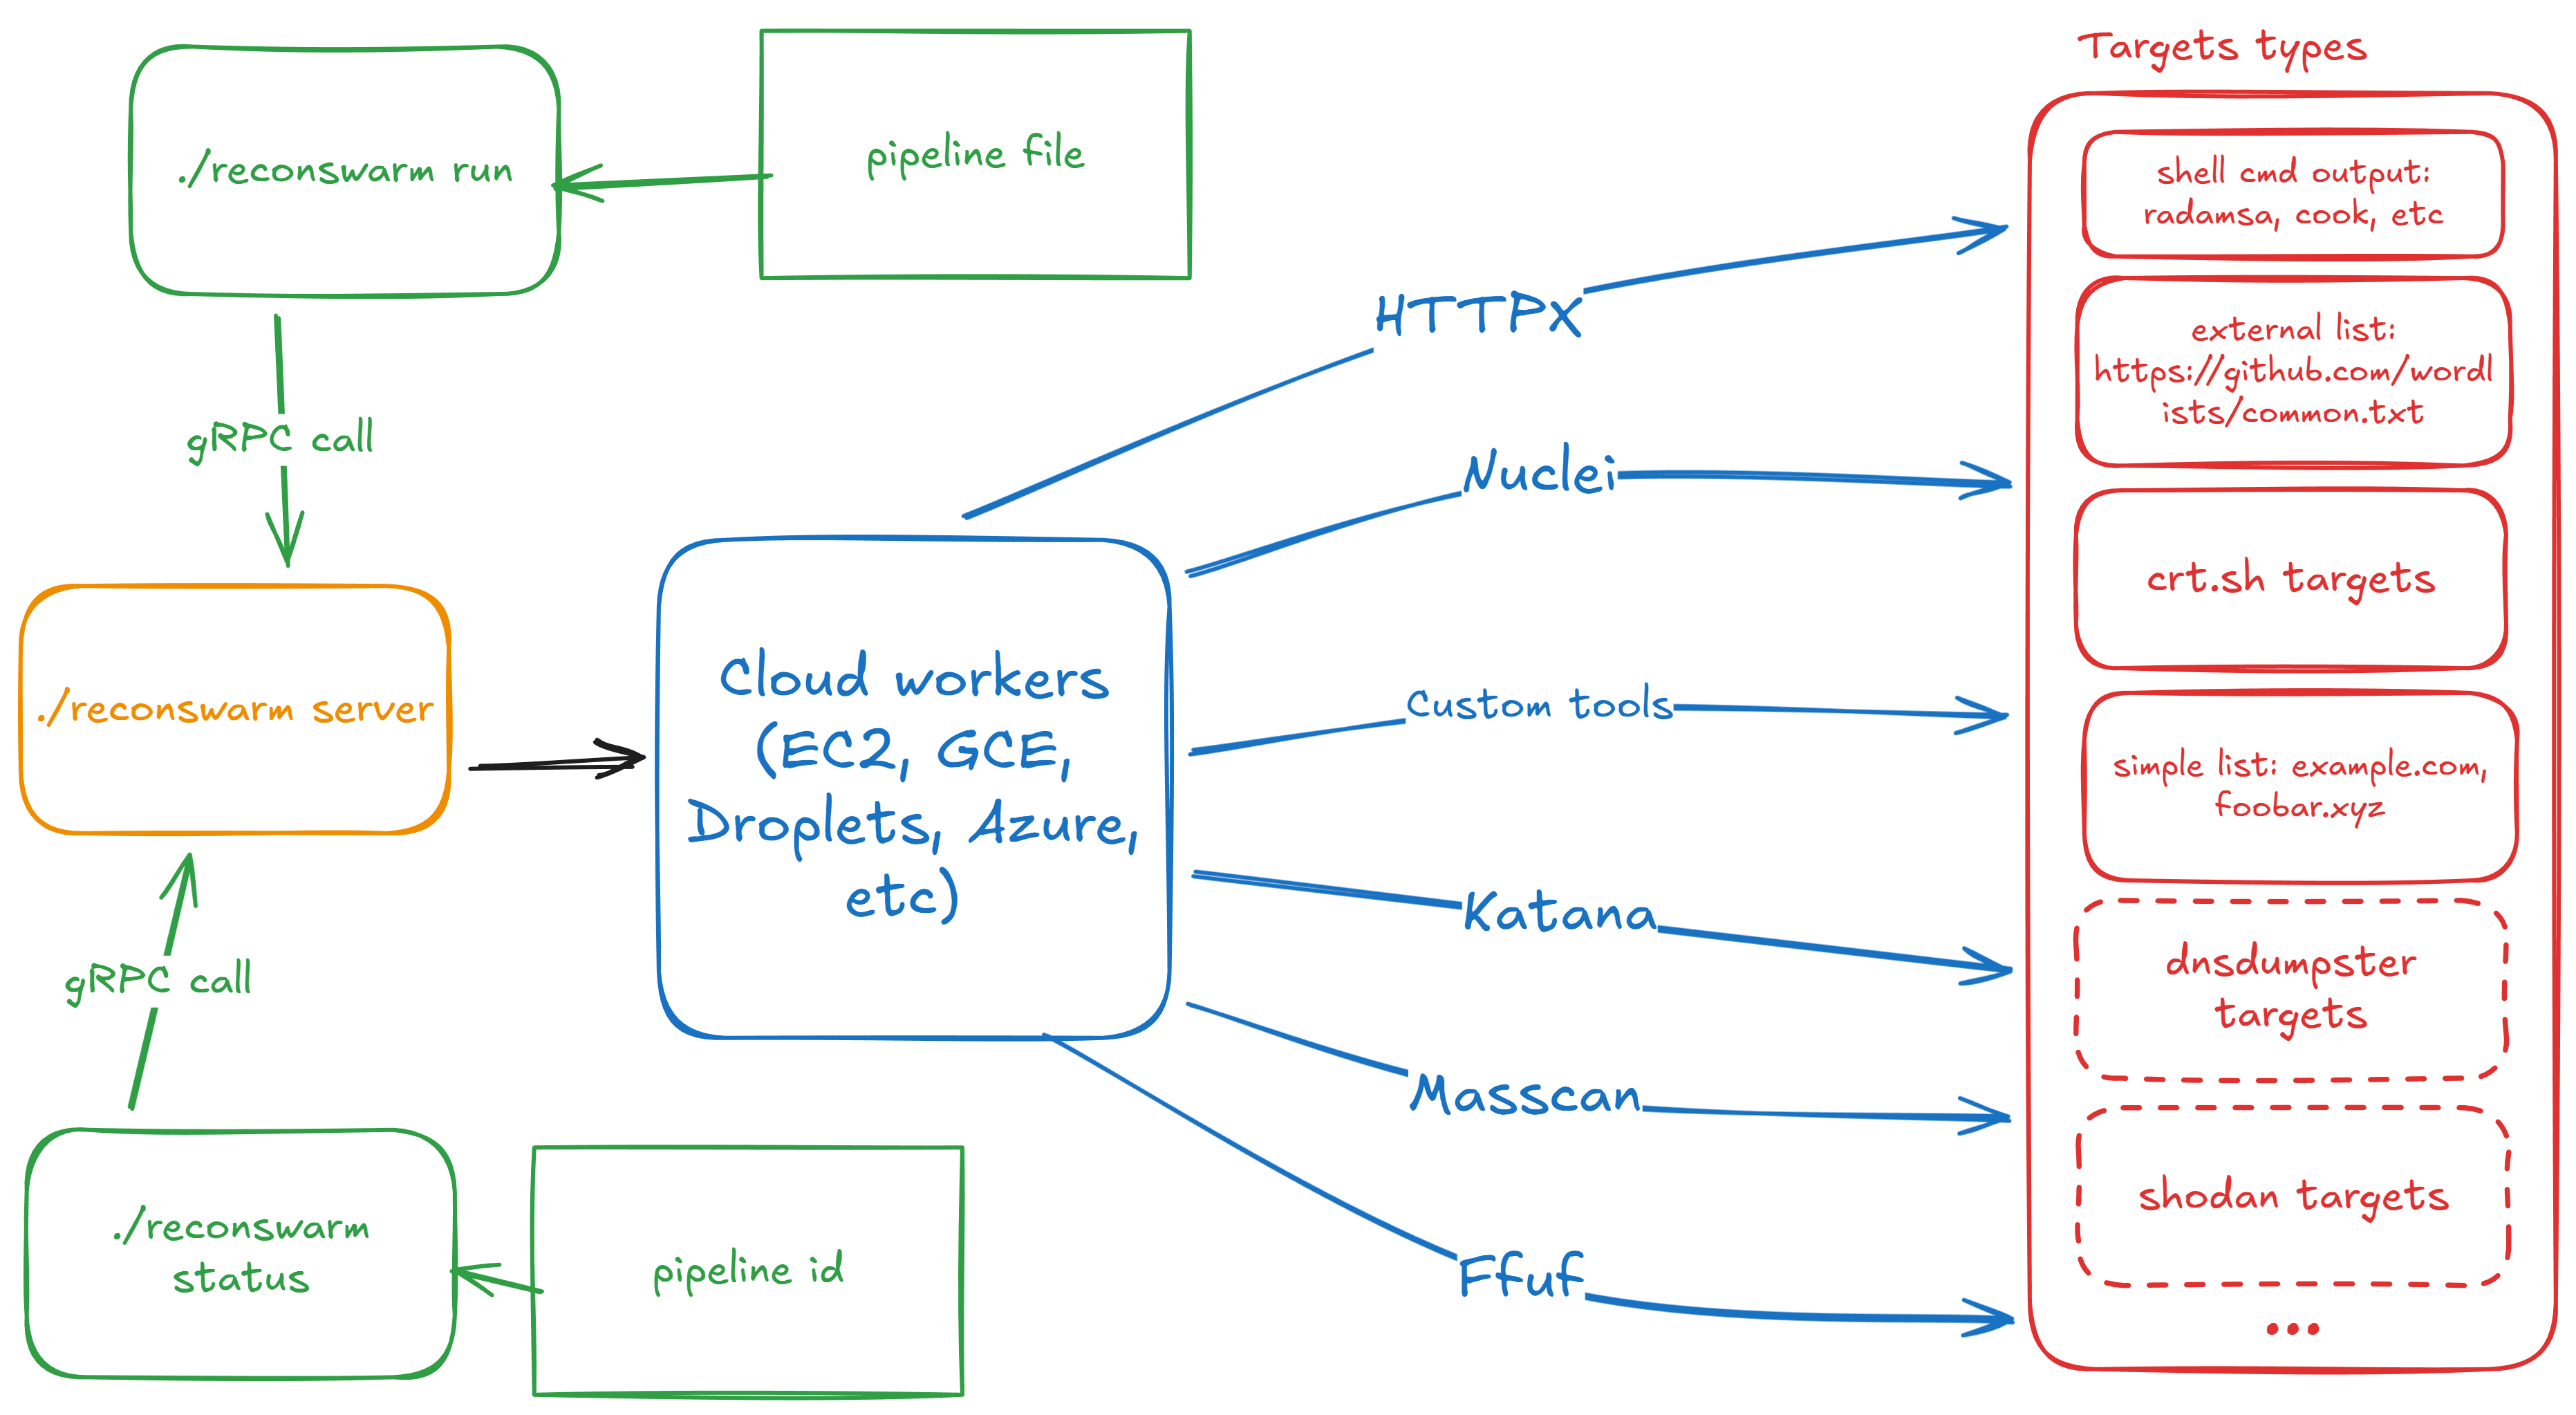
ReconSwarm é um framework modular de automação de reconhecimento projetado para testes de segurança distribuídos. Ele provisiona infraestrutura em nuvem, executa pipelines de reconhecimento em paralelo e coleta resultados com sobrecarga mínima de configuração.
ReconSwarm é adequado para caçadores de recompensas de bugs, testadores de penetração, engenheiros DevSecOps e pesquisadores de segurança que precisam de fluxos de trabalho de reconhecimento escaláveis e automatizados, sem gerenciamento manual de infraestrutura.
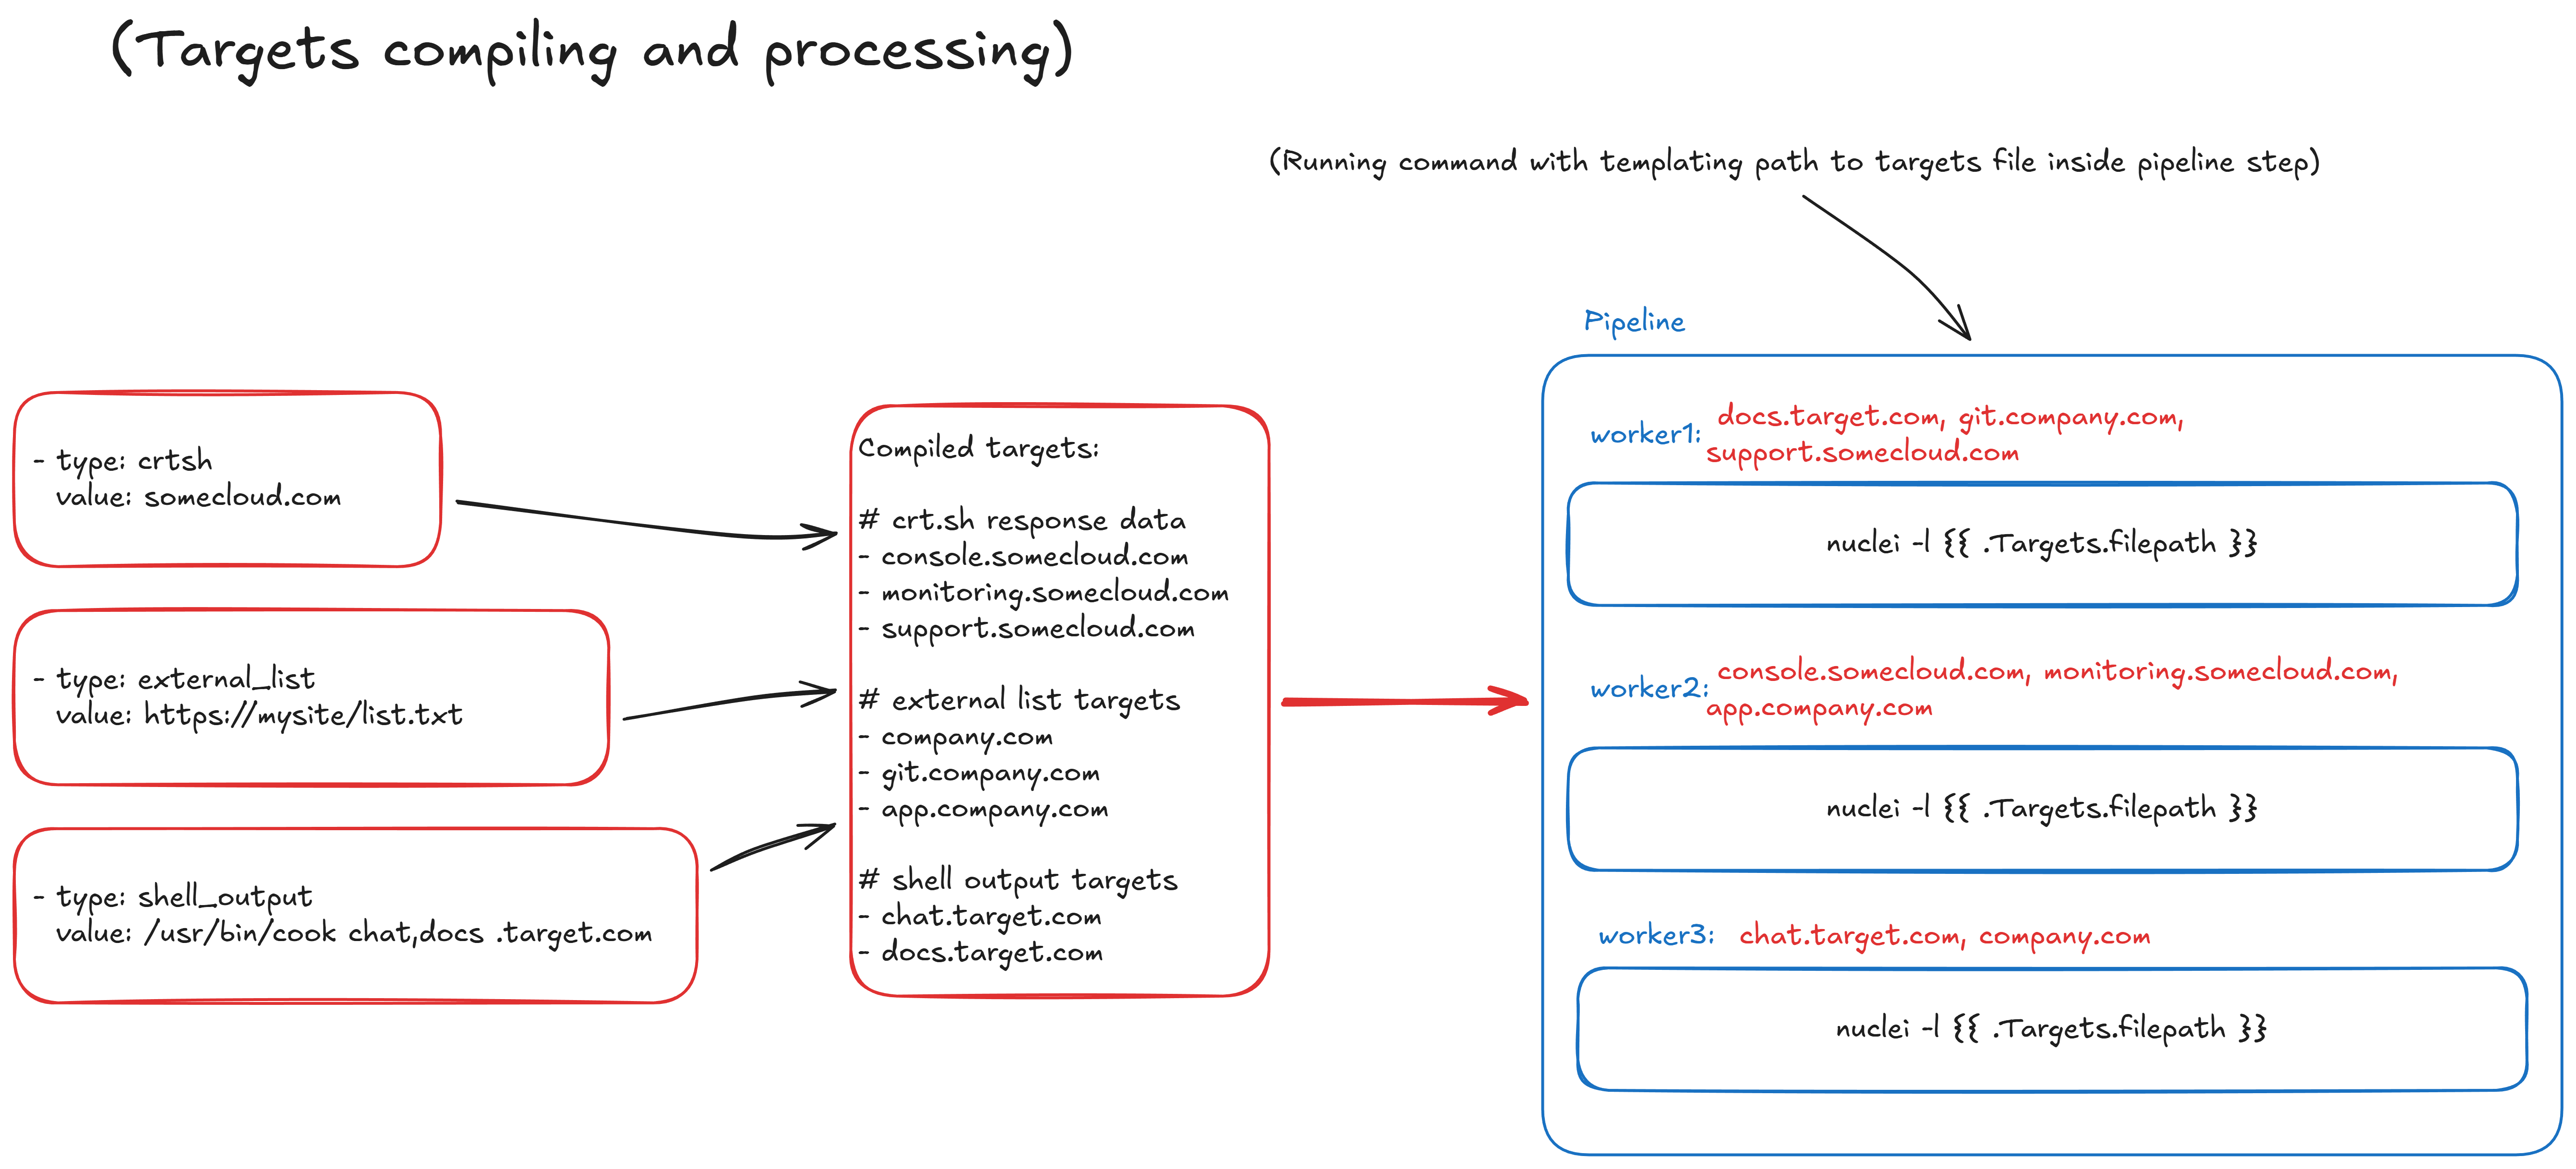
ReconSwarm segue uma arquitetura modular com separação clara de responsabilidades entre provisionamento em nuvem, controle remoto de sistemas, execução de pipelines e gerenciamento de configuração.
ReconSwarm usa um padrão de união discriminada para provisionadores de nuvem. O campo provisioner.type determina qual configuração de provedor está ativa:
provisioner:
  type: yandex_cloud  # Campo discriminador
  yandex_cloud:       # Ativo quando type: yandex_cloud
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    # ... configurações específicas do provedor
Provedores de nuvem adicionais podem ser integrados implementando a interface Provisioner e adicionando um novo tipo à fábrica.
Estágios são componentes extensíveis que executam operações nas VMs workers:
Todos os campos dos estágios suportam renderização de templates. Novos tipos de estágio podem ser adicionados para estender a funcionalidade.
O servidor ReconSwarm é completamente stateless — todo o estado é persistido no etcd:
Esta arquitetura permite:
| Capacidade | Descrição |
|---|---|
| Escalabilidade horizontal | Executar múltiplas instâncias do servidor atrás de um balanceador de carga |
| Reinicializações sem downtime | Reiniciar o servidor sem perder o estado do pipeline |
| Recuperação de falhas | Uma nova instância do servidor continua de onde a anterior parou |
| Inspeção de estado | Consultar o etcd diretamente para depuração e monitoramento |
Configuração de Alta Disponibilidade:
                    ┌─────────────┐
                    │   Cliente   │
                    └──────┬──────┘
                           │
                    ┌──────▼──────┐
                    │Balanceador  │
                    │ de Carga    │
                    └──────┬──────┘
              ┌────────────┼────────────┐
              │            │            │
       ┌──────▼──────┐ ┌───▼───┐ ┌──────▼──────┐
       │ Servidor 1  │ │Ser v2│ │ Servidor 3  │
       └──────┬──────┘ └───┬───┘ └──────┬──────┘
              │            │            │
              └────────────┼────────────┘
                           │
                    ┌──────▼──────┐
                    │cluster etcd │
                    └─────────────┘
Todos os servidores compartilham o mesmo cluster etcd e podem lidar com qualquer requisição. Se um servidor falhar no meio de um pipeline, outro servidor pode continuar a execução após ler o estado do etcd.
Nota: A implementação atual executa pipelines em memória após carregar do etcd. A recuperação completa de falhas com retomada de pipeline está planejada para versões futuras.
git clone <repositório>
cd reconswarm
go mod download
task build
ReconSwarm separa a configuração do servidor da configuração do pipeline:
| Tipo de Config | Arquivo | Descrição |
|---|---|---|
| Servidor | reconswarm.yaml | Provedor de nuvem, etcd, configurações do pool de workers |
| Pipeline | Arquivo YAML separado | Alvos e estágios, passado via flag -f |
A configuração do servidor é armazenada em reconswarm.yaml (configurável via variável de ambiente CONFIG_PATH). Todos os valores de string suportam expansão de variáveis de ambiente usando a sintaxe ${VAR} ou $VAR.
# Configurações do servidor
server:
  port: 50051

# Conexão etcd para gerenciamento de estado
etcd:
  endpoints:
    - "localhost:2379"
  dial_timeout: 5  # segundos
  username: ""     # opcional, suporta ${ETCD_USER}
  password: ""     # opcional, suporta ${ETCD_PASSWORD}

# Provisionador de nuvem (união discriminada)
provisioner:
  type: yandex_cloud  # Seletor de provedor

  # Configuração Yandex Cloud (ativa quando type: yandex_cloud)
  yandex_cloud:
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    default_zone: "ru-central1-b"
    default_image: "fd8b1cmhmncn7lt4tqn4"
    default_username: "root"
    default_cores: 2
    default_memory: 2      # GB
    default_disk_size: 20  # GB

# Configurações do pool de workers
workers:
  max_workers: 5
  setup_commands:
    - "apt update"
    - "apt install -y docker.io"
A configuração do pipeline é armazenada em um arquivo YAML separado e passada via flag -f. Ambos os formatos, encapsulado e não encapsulado, são suportados:
Formato encapsulado (recomendado):
# pipeline.yaml
pipeline:
  targets:
    - value: "example.com"
      type: crtsh
    - value: ["sub1.example.com", "sub2.example.com"]
      type: list
  stages:
    - name: "Executar scanner"
      type: exec
      steps:
        - "nmap -sC -sV -iL {{.Targets.filepath}} -oN /opt/recon/scan.txt"
    - name: "Coletar resultados"
      type: sync
      src: "/opt/recon/scan.txt"
      dest: "./results/{{.Worker.Name}}.txt"
