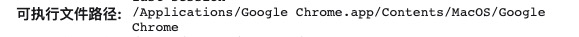
 qianlitp/crawlergo
Um poderoso rastreador de navegador para scanners de vulnerabilidades web


Um poderoso rastreador de navegador para scanners de vulnerabilidades web
Documento em Inglês | Documento em Chinês
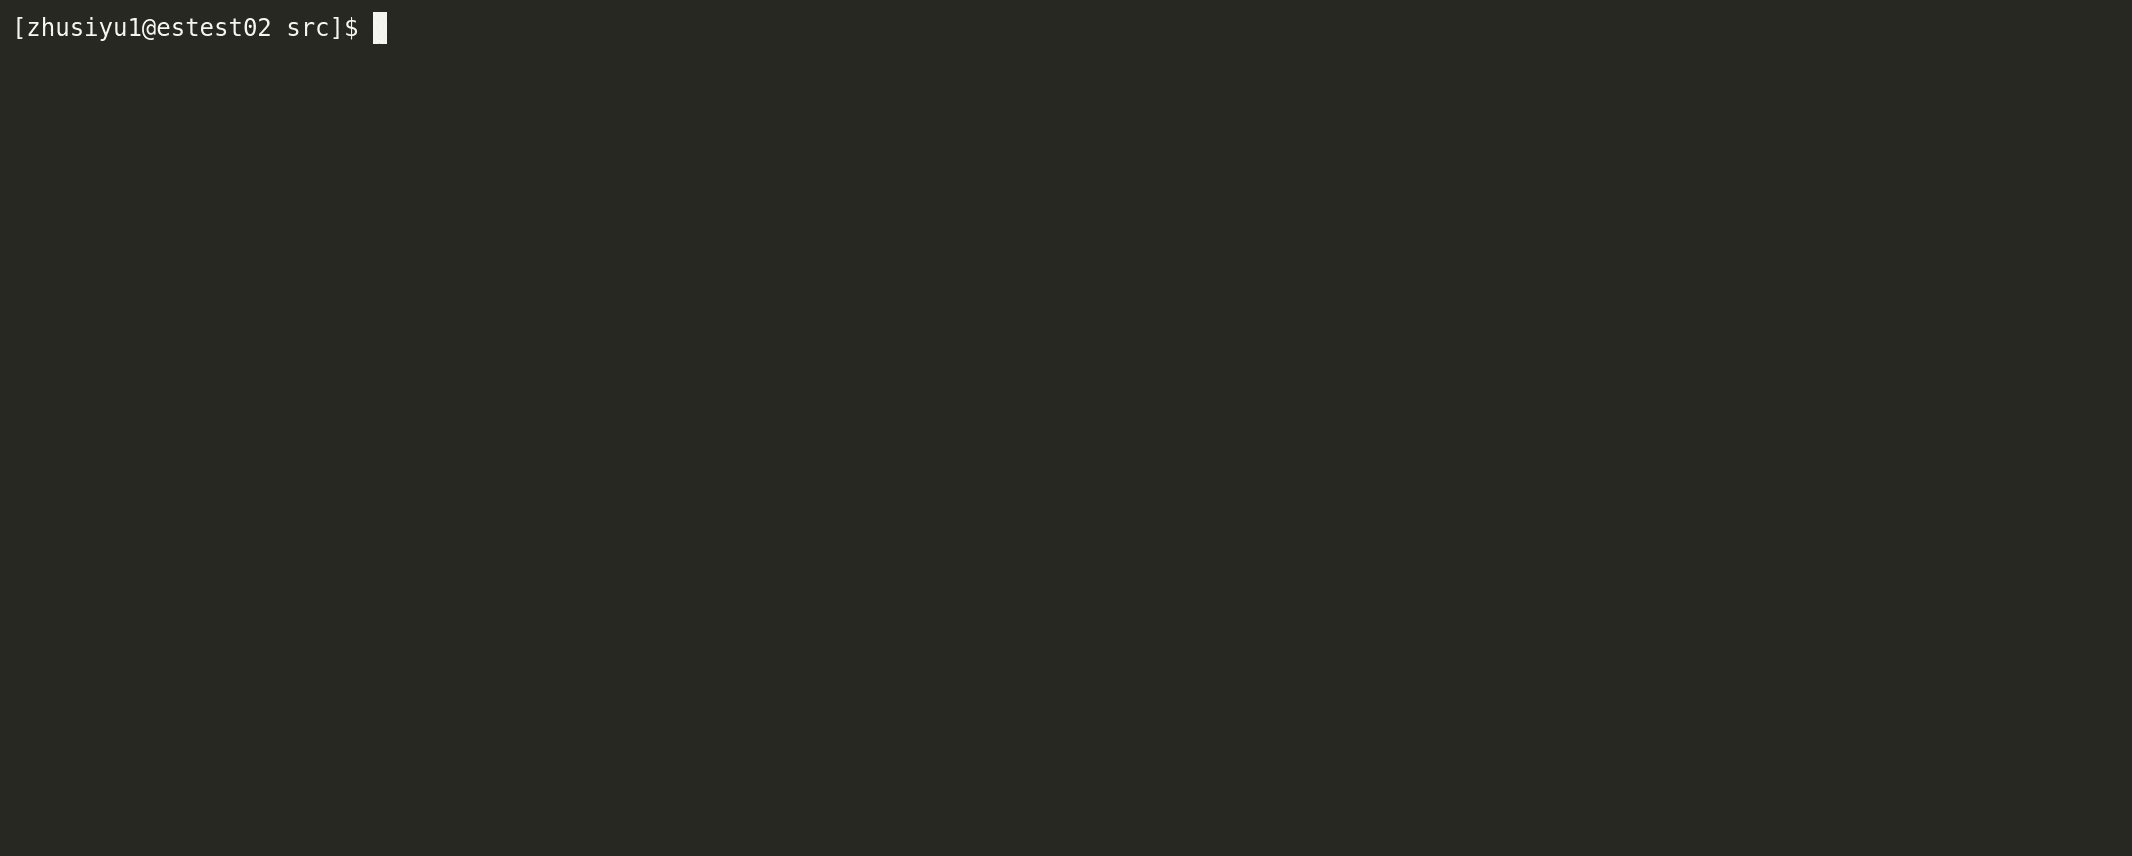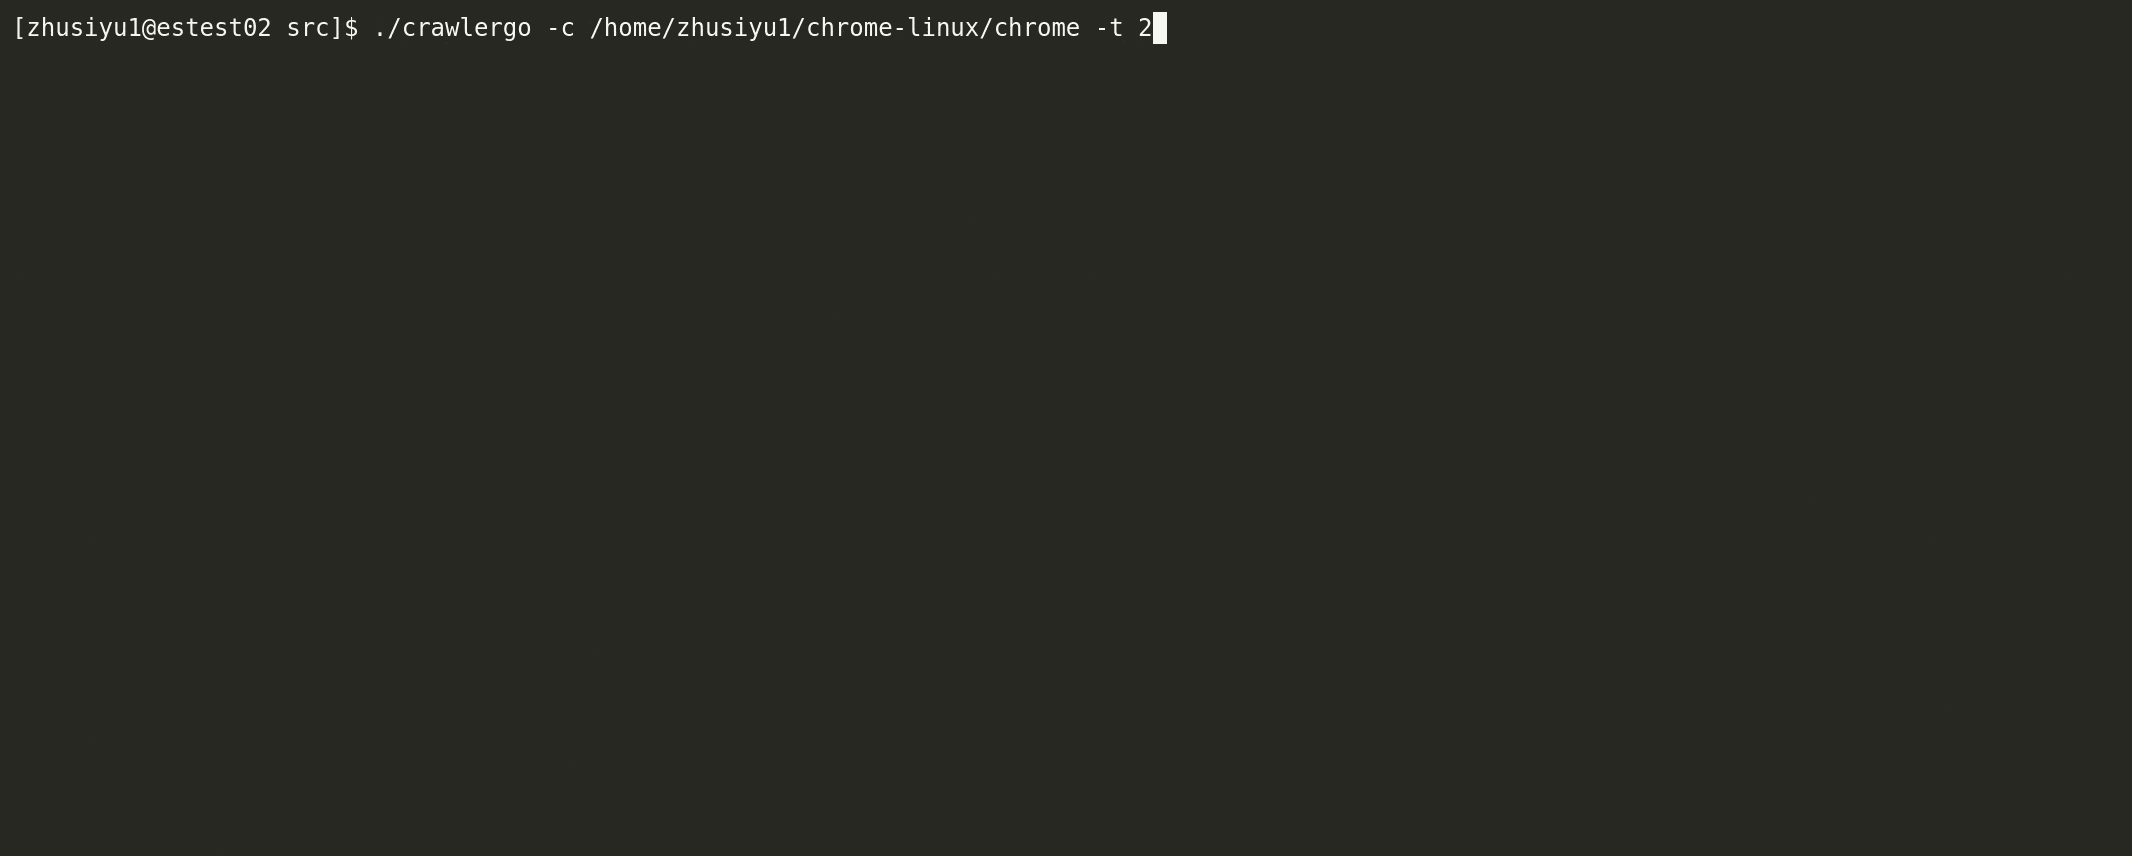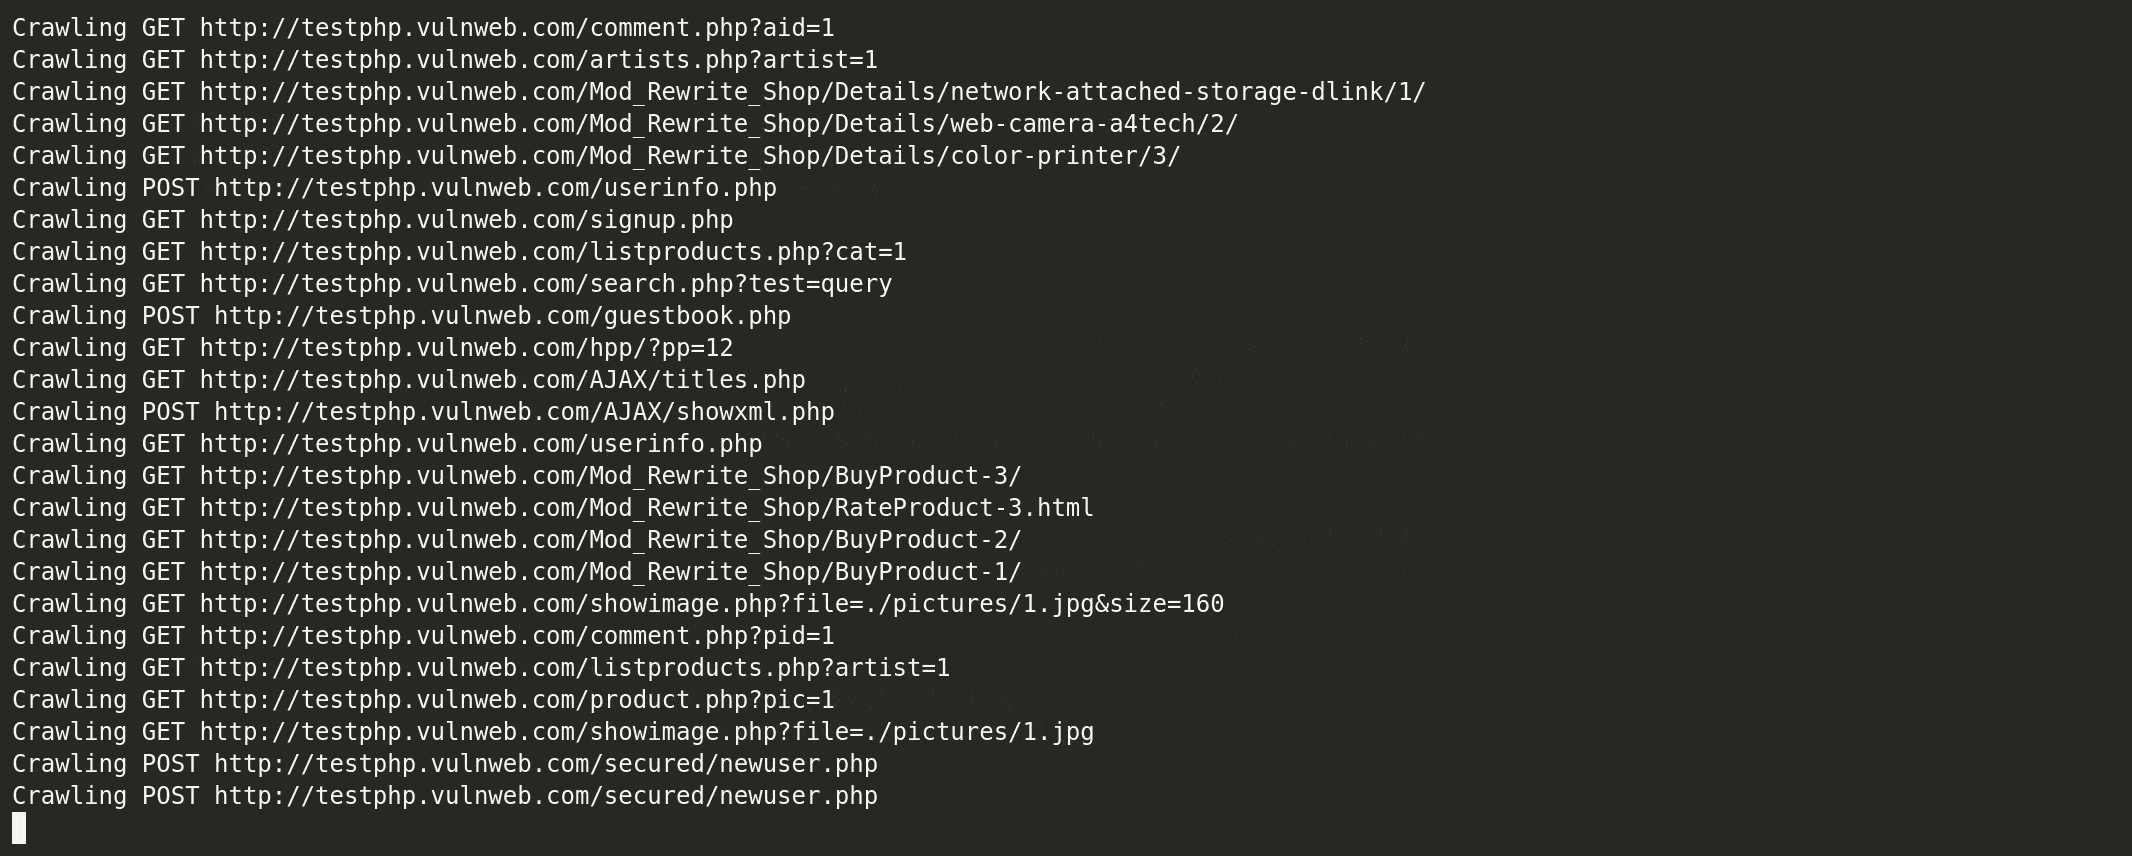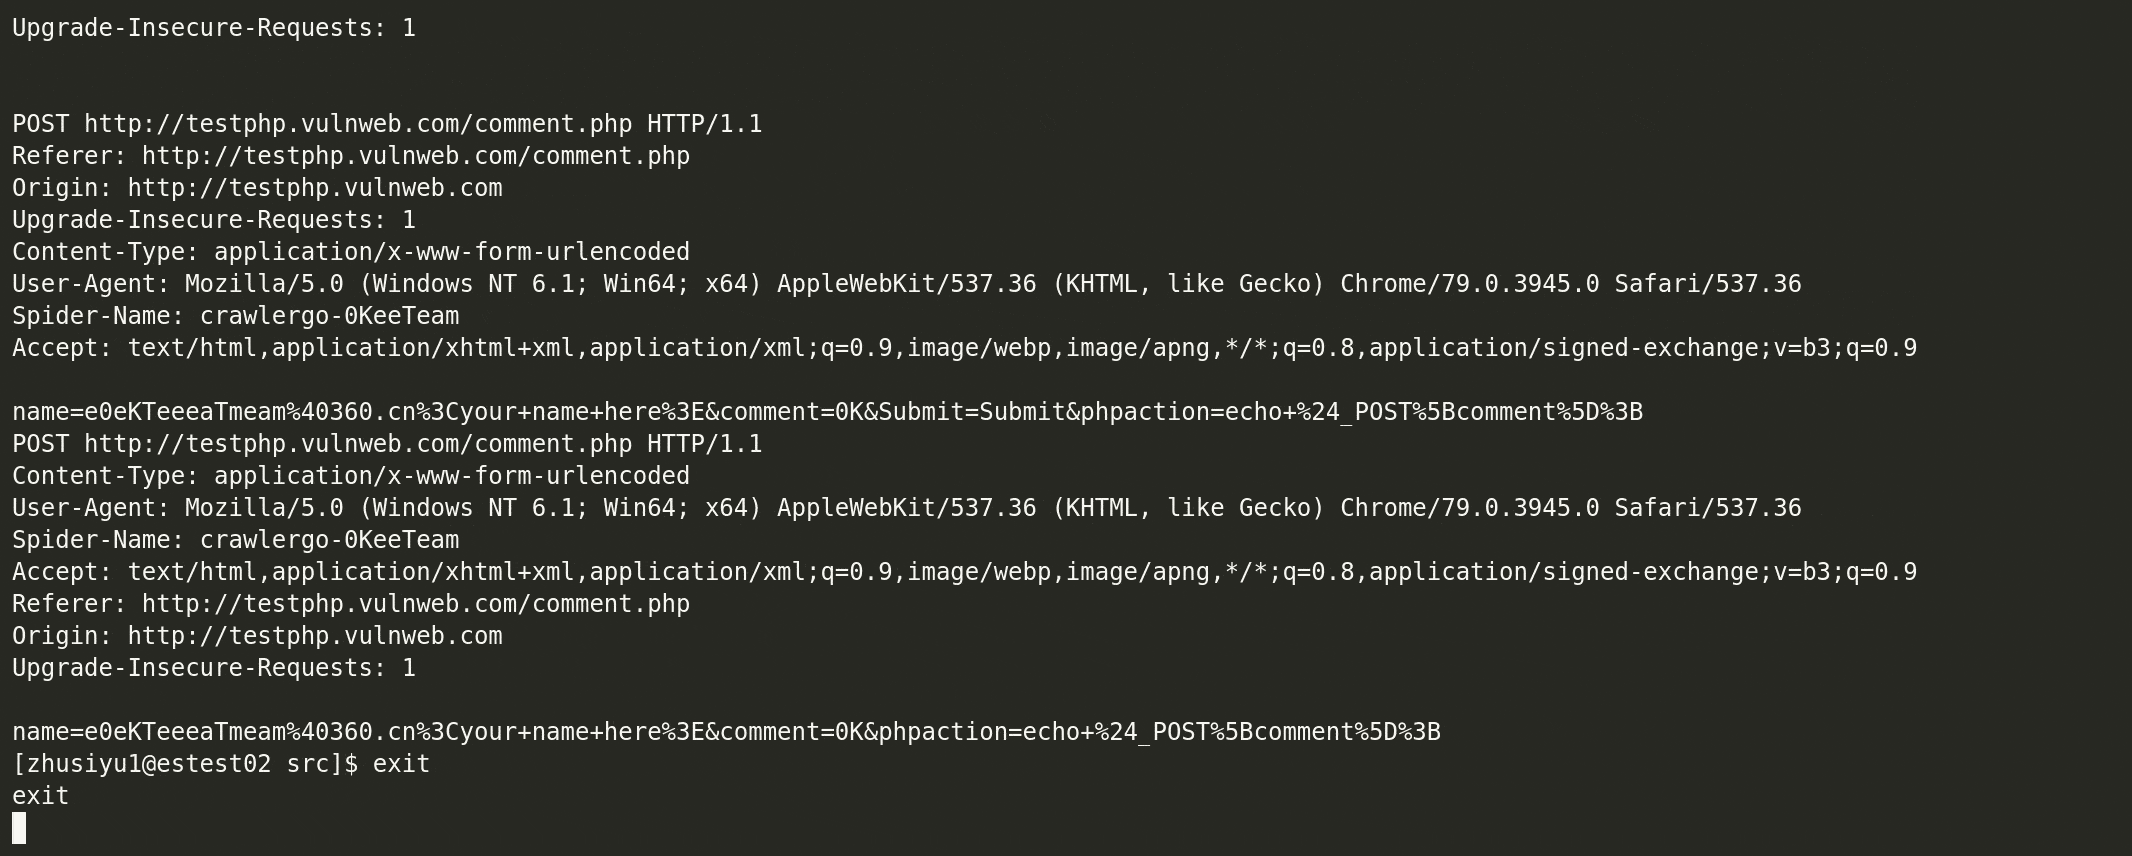
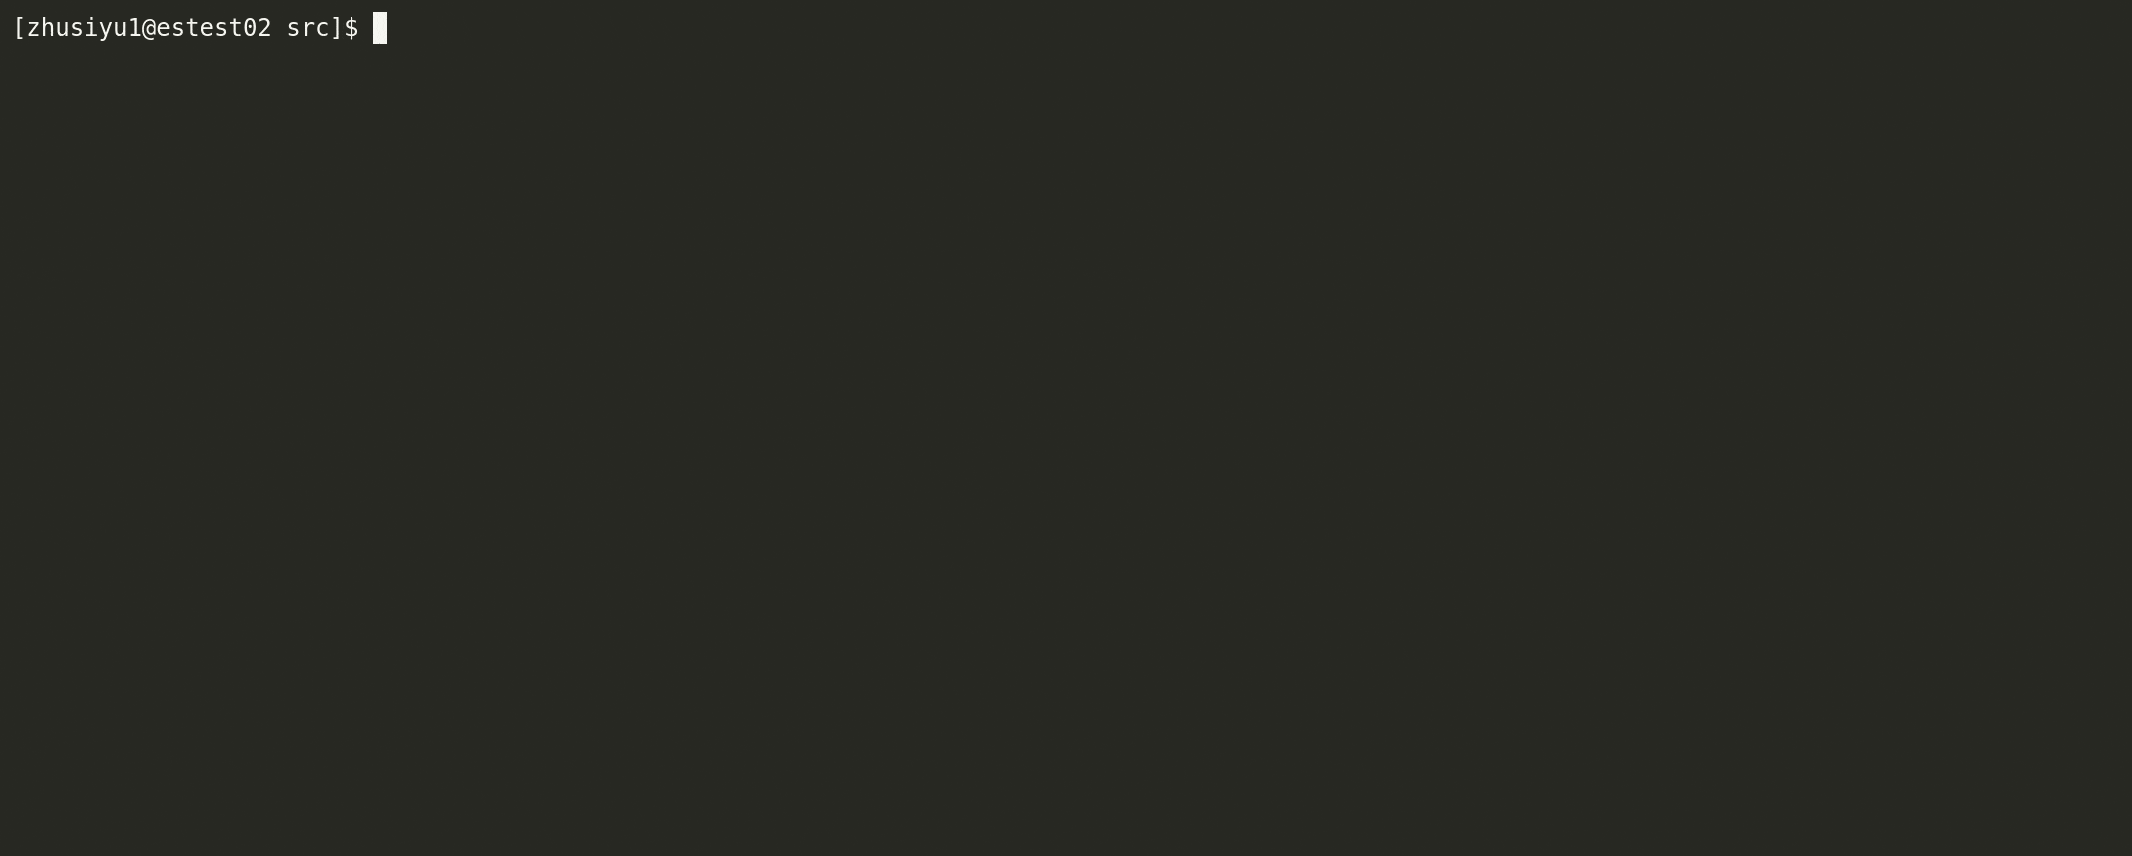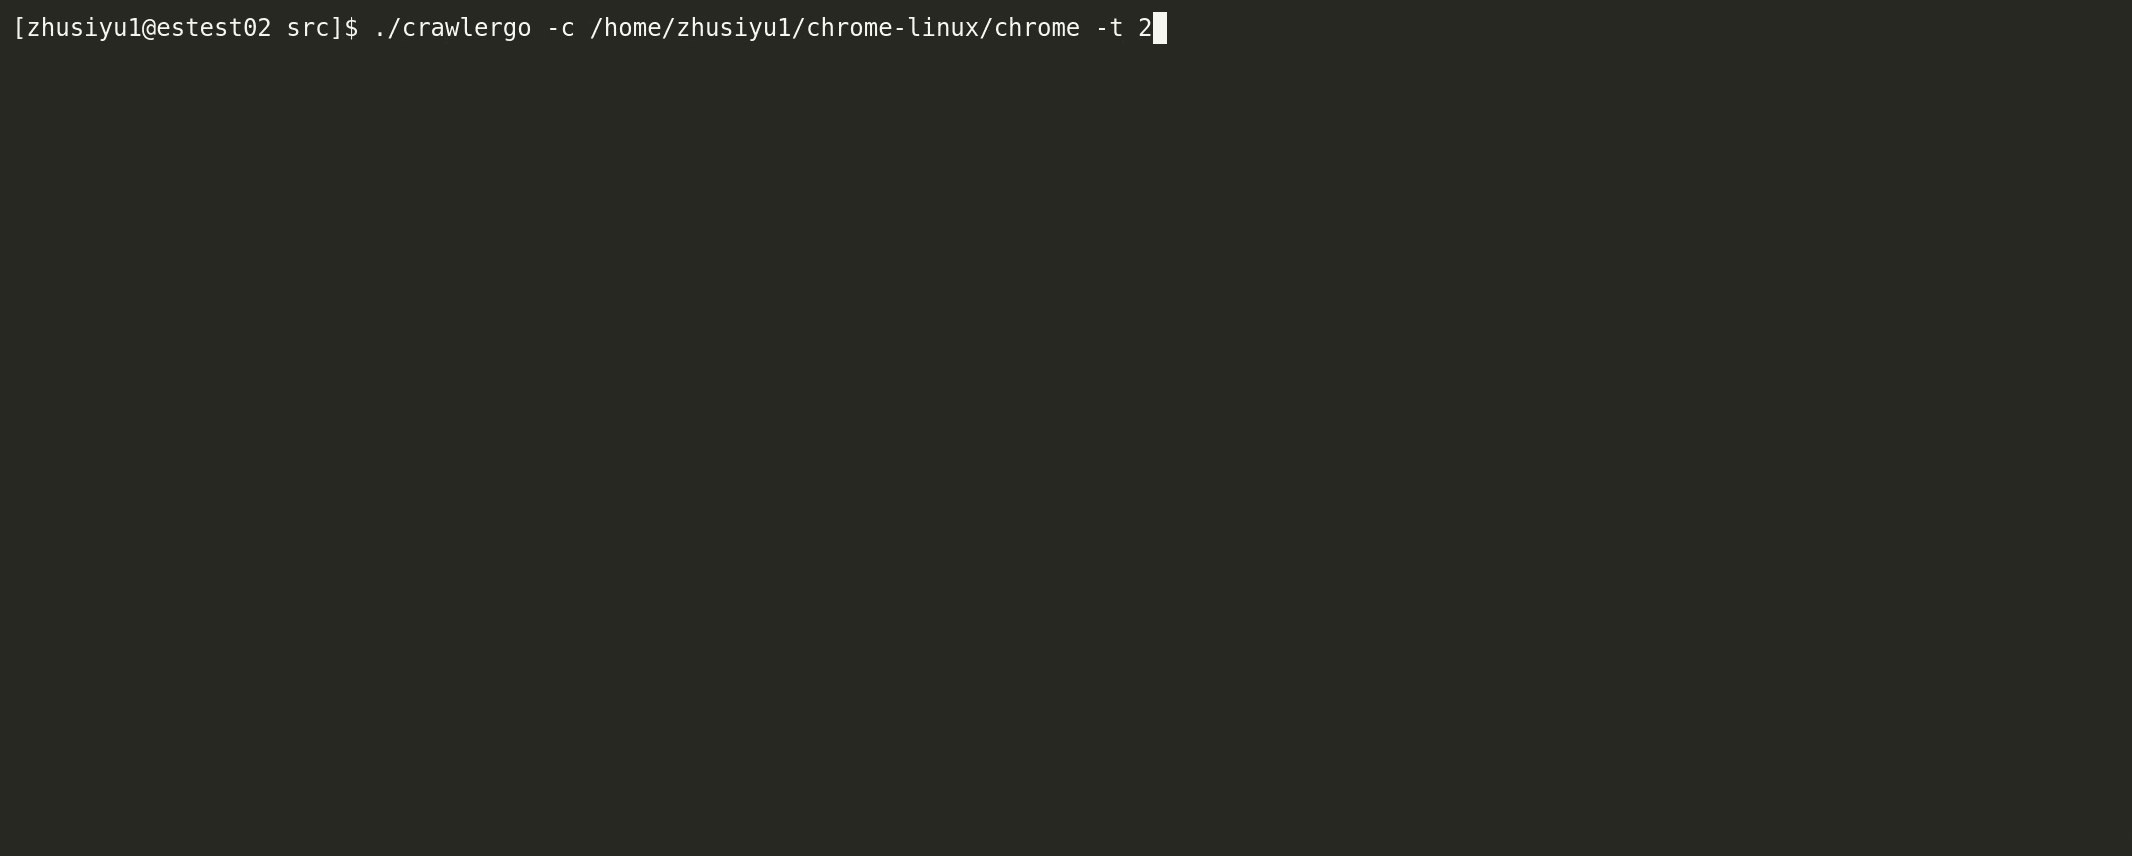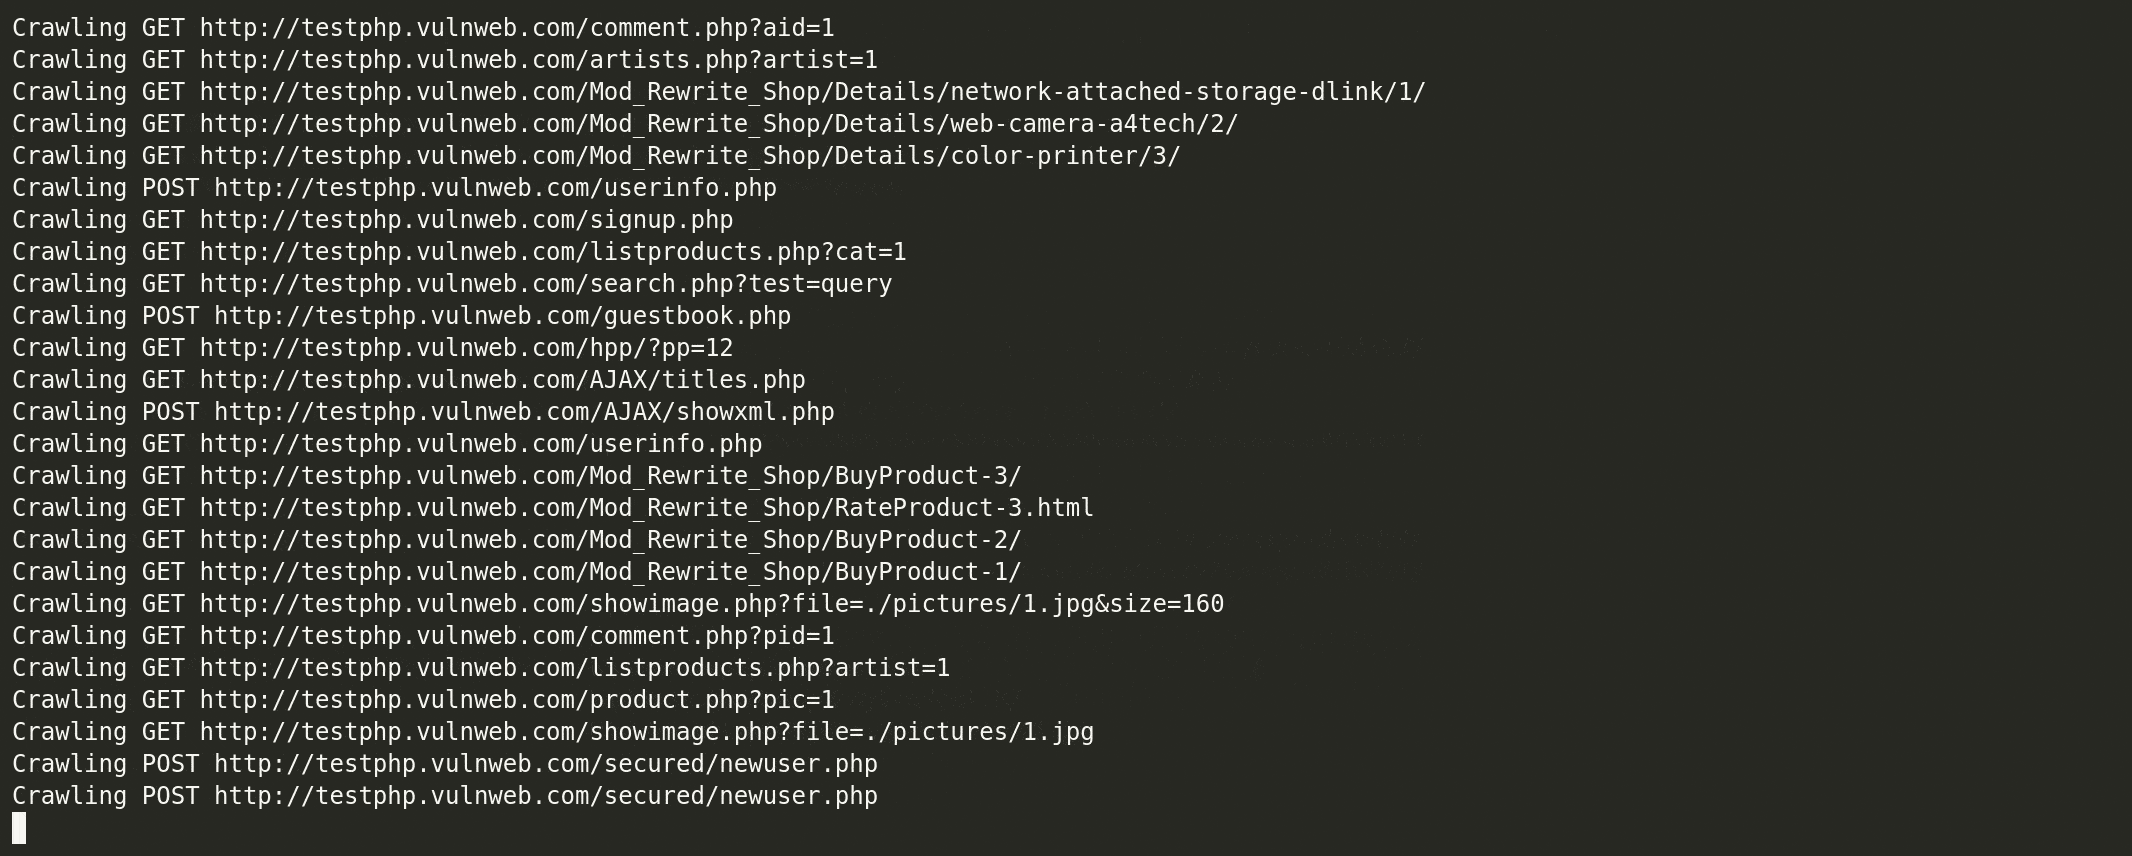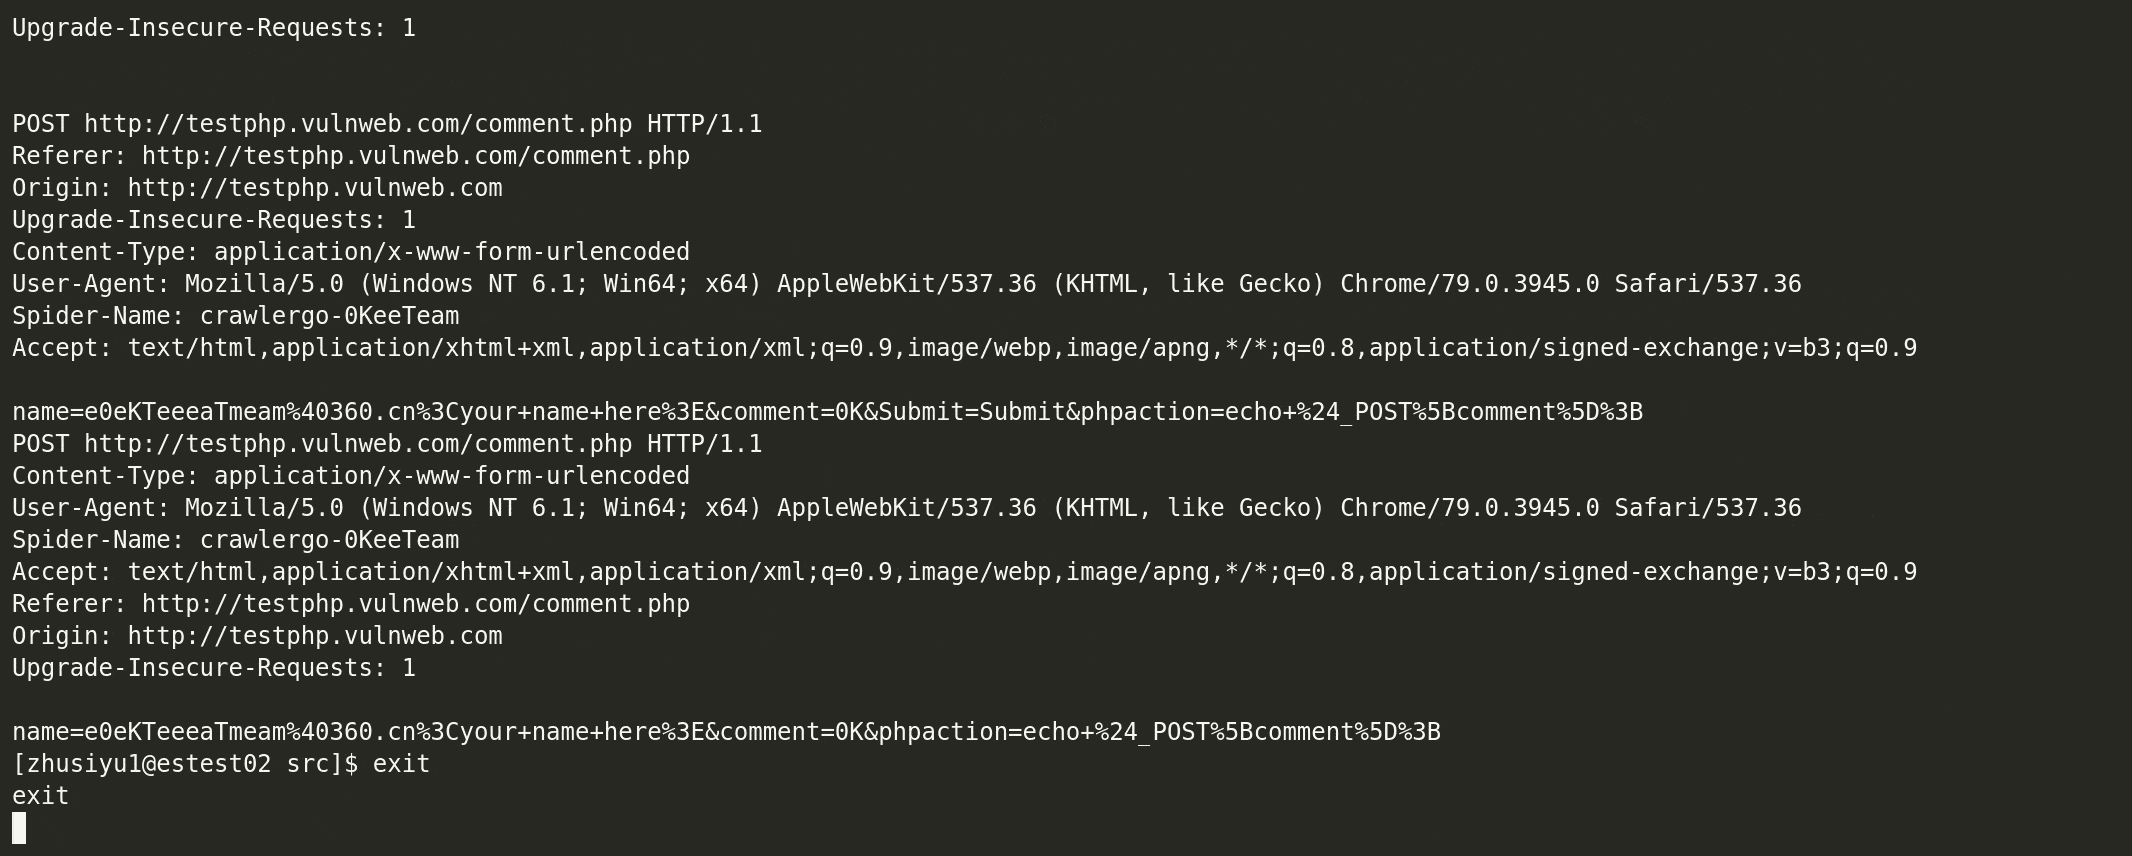
crawlergo é um rastreador de navegador que utiliza o modo headless do chrome para coleta de URLs. Ele intercepta pontos-chave de toda a página web durante a fase de renderização do DOM, preenche e submete formulários automaticamente, com acionamento inteligente de eventos JS, e coleta o maior número possível de entradas expostas pelo site. O módulo interno de desduplicação de URLs filtra uma grande quantidade de URLs pseudoestáticas, mantendo uma velocidade rápida de análise e rastreamento para sites grandes, e finalmente obtém uma coleção de alta qualidade de resultados de requisições.
crawlergo atualmente suporta os seguintes recursos:
Por favor, leia e confirme o termo de isenção de responsabilidade cuidadosamente antes de instalar e usar.
Construção
make build
make build_all
Se estiver usando um sistema Linux e o Chrome reclamar de dependências ausentes, veja a seção de Solução de Problemas abaixo
Supondo que seu diretório de instalação do Chromium seja /tmp/chromium/, configure 10 abas abertas simultaneamente e rastreie o testphp.vulnweb.com:
bin/crawlergo -c /tmp/chromium/chrome -t 10 http://testphp.vulnweb.com/
Você também pode usar com docker sem problemas:
git clone https://github.com/Qianlitp/crawlergo
docker build . -t crawlergo
docker run crawlergo http://testphp.vulnweb.com/
bin/crawlergo -c /tmp/chromium/chrome -t 10 --request-proxy socks5://127.0.0.1:7891 http://testphp.vulnweb.com/
Por padrão, crawlergo imprime os resultados diretamente na tela. Em seguida, definimos o modo de saída como json, e o código de exemplo para chamá-lo usando Python é o seguinte:
#!/usr/bin/python3
# coding: utf-8

import simplejson
import subprocess


def main():
    target = "http://testphp.vulnweb.com/"
    cmd = ["bin/crawlergo", "-c", "/tmp/chromium/chrome", "-o", "json", target]
    rsp = subprocess.Popen(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
    output, error = rsp.communicate()
	#  "--[Mission Complete]--"  é a string separadora de fim de tarefa
    result = simplejson.loads(output.decode().split("--[Mission Complete]--")[1])
    req_list = result["req_list"]
    print(req_list[0])


if __name__ == '__main__':
    main()
Quando o modo de saída é definido como json, o resultado retornado, após desserialização JSON, contém quatro partes:
all_req_list: Todas as requisições encontradas durante esta tarefa de rastreamento, contendo qualquer tipo de recurso de outros domínios.req_list: Retorna os resultados do domínio atual desta tarefa de rastreamento, desduplicados pseudoestaticamente, sem links de recursos estáticos. É um subconjunto de all_req_list.all_domain_list: Lista de todos os domínios encontrados.sub_domain_list: Lista de subdomínios encontrados.crawlergo retorna a requisição completa e a URL, que podem ser usadas de várias maneiras:
Usado em conjunto com outros scanners passivos de vulnerabilidades web
Primeiro, inicie um scanner passivo e defina o endereço de escuta como: http://127.0.0.1:1234/
Em seguida, assumindo que crawlergo está na mesma máquina que o scanner, inicie crawlergo e defina os parâmetros:
--push-to-proxy http://127.0.0.1:1234/
Vinculação de Host (não disponível para versões altas do Chrome) (exemplo)
Cookies Personalizados (exemplo)
Limpeza regular de processos zumbis gerados pelo crawlergo (exemplo), contribuído por @ring04h
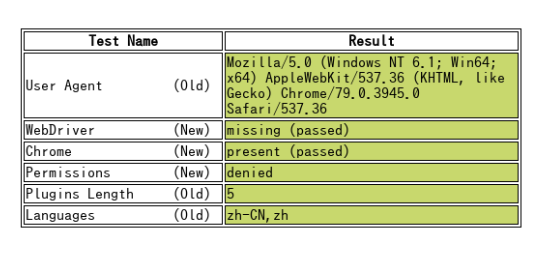
crawlergo pode contornar a detecção de modo headless por padrão.
https://intoli.com/blog/not-possible-to-block-chrome-headless/chrome-headless-test.html
'Fetch.enable' não foi encontrado
Fetch é um recurso suportado pela nova versão do Chrome. Se este erro ocorrer, significa que sua versão é muito antiga, por favor, atualize a versão do Chrome.
Chrome é executado com dependências ausentes, como xxx.so
// Ubuntu
apt-get install -yq --no-install-recommends \
     libasound2 libatk1.0-0 libc6 libcairo2 libcups2 libdbus-1-3 \
     libexpat1 libfontconfig1 libgcc1 libgconf-2-4 libgdk-pixbuf2.0-0 libglib2.0-0 libgtk-3-0 libnspr4 \
     libpango-1.0-0 libpangocairo-1.0-0 libstdc++6 libx11-6 libx11-xcb1 libxcb1 libgbm1 \
     libxcursor1 libxdamage1 libxext6 libxfixes3 libxi6 libxrandr2 libxrender1 libxss1 libxtst6 libnss3

// CentOS 7
sudo yum install pango.x86_64 libXcomposite.x86_64 libXcursor.x86_64 libXdamage.x86_64 libXext.x86_64 libXi.x86_64 \
     libXtst.x86_64 cups-libs.x86_64 libXScrnSaver.x86_64 libXrandr.x86_64 GConf2.x86_64 alsa-lib.x86_64 atk.x86_64 gtk3.x86_64 \
     ipa-gothic-fonts xorg-x11-fonts-100dpi xorg-x11-fonts-75dpi xorg-x11-utils xorg-x11-fonts-cyrillic xorg-x11-fonts-Type1 xorg-x11-fonts-misc -y

sudo yum update nss -y
Execução com aviso Navigation timeout / navegador não encontrado / não sabe o caminho executável correto do navegador
Certifique-se de que o caminho executável do navegador está configurado corretamente. Digite: chrome://version na barra de endereços e encontre o caminho do arquivo executável: