 nvidia-nemo/guardrails
Guardrails programáveis para aplicativos de chat com LLM: impor limites de entrada/saída, bloquear jailbreaks e injeções de prompt, detectar alucinações e mascarar dados sensíveis.



ÚLTIMA VERSÃO / VERSÃO DE DESENVOLVIMENTO: O branch develop acompanha o desenvolvimento mais recente. A versão mais recente lançada é a 0.24.1.
✨✨✨
📌 A documentação oficial da biblioteca NeMo Guardrails está disponível em docs.nvidia.com/nemo/guardrails.
✨✨✨
A biblioteca NVIDIA NeMo Guardrails é um kit de ferramentas de código aberto para adicionar facilmente guardrails programáveis a aplicações conversacionais baseadas em LLM. Guardrails (ou "rails", abreviadamente) são formas específicas de controlar a saída de um modelo de linguagem de grande porte, como não falar sobre política, responder de uma forma específica a pedidos específicos do utilizador, seguir um caminho de diálogo predefinido, usar um estilo de linguagem específico, extrair dados estruturados, entre outros.
Este artigo apresenta a biblioteca NeMo Guardrails e contém uma visão geral técnica do sistema e a avaliação atual.
Python 3.10, 3.11, 3.12 ou 3.13.
Para instalar usando pip:```bash
pip install nemoguardrails
Para obter instruções mais detalhadas, consulte o [Guia de Instalação](https://docs.nvidia.com/nemo/guardrails/get-started/installation-guide).

## Visão Geral

<!-- start-documentation-reuse -->

A biblioteca NeMo Guardrails permite que desenvolvedores que criam aplicações baseadas em LLM adicionem **guardrails programáveis** entre o código da aplicação e o LLM.

<div align="center">
  <img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/programmable_guardrails.png"  width="75%" alt="Programmable Guardrails">
</div>

Os principais benefícios de adicionar *guardrails programáveis* incluem:

- **Construir aplicações baseadas em LLM confiáveis, seguras e protegidas:** você pode definir rails para orientar e proteger conversas; você pode optar por definir o comportamento da sua aplicação baseada em LLM sobre tópicos específicos e impedi-la de se envolver em discussões sobre tópicos indesejados.

- **Conectar modelos, chains e outros serviços com segurança:** você pode conectar um LLM a outros serviços (também conhecidos como ferramentas) de forma integrada e segura.

- **Diálogo controlável**: você pode direcionar o LLM para seguir caminhos conversacionais predefinidos, permitindo que você projete a interação seguindo as melhores práticas de design de conversação e imponha procedimentos operacionais padrão (por exemplo, autenticação, suporte).

<!-- end-documentation-reuse -->

### Proteção contra Vulnerabilidades de LLM

A biblioteca NeMo Guardrails fornece vários mecanismos para proteger uma aplicação de chat baseada em LLM contra vulnerabilidades comuns de LLM, como jailbreaks e injeções de prompt. Abaixo está uma visão geral de exemplo da proteção oferecida por diferentes configurações de guardrails para o exemplo [ABC Bot](https://github.com/nvidia-nemo/guardrails/blob/develop/examples/bots/abc) incluído neste repositório. Para mais detalhes, consulte a página [LLM Vulnerability Scanning](https://docs.nvidia.com/nemo/guardrails/evaluation/llm-vulnerability-scanning.html).

<div align="center">
<img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/abc-llm-vulnerability-scan-results.png" width="500">
</div>

### Casos de Uso

Você pode usar guardrails programáveis em diferentes tipos de casos de uso:

1. **Perguntas e Respostas** sobre um conjunto de documentos (também conhecido como Retrieval Augmented Generation): Imponha verificação de fatos e moderação de saída.
2. **Assistentes Específicos de Domínio** (também conhecidos como chatbots): Garanta que o assistente permaneça no tópico e siga os fluxos conversacionais projetados.
3. **Endpoints de LLM**: Adicione guardrails ao seu LLM personalizado para uma interação mais segura com o cliente.
4. **LangChain Chains** (opcional): Se você usa LangChain para qualquer caso de uso, pode adicionar uma camada de guardrails em torno de suas chains. Para habilitar essa integração, defina a variável de ambiente `NEMOGUARDRAILS_LLM_FRAMEWORK=langchain` ou chame `set_default_framework("langchain")`.

### Uso

Para adicionar guardrails programáveis à sua aplicação, você pode usar a API Python ou um servidor de guardrails (consulte o [Guia do Servidor](https://docs.nvidia.com/nemo/guardrails/get-started/integrate-into-application) para mais detalhes). Usar a API Python é semelhante a usar o LLM diretamente. Chamar a camada de guardrails em vez do LLM requer apenas mudanças mínimas na base de código, e envolve dois passos simples:

1. Carregar uma configuração de guardrails e criar uma instância de `LLMRails`.
2. Fazer as chamadas ao LLM usando os métodos `generate`/`generate_async`.```python
from nemoguardrails import LLMRails, RailsConfig

# Load a guardrails configuration from the specified path.
config = RailsConfig.from_path("PATH/TO/CONFIG")
rails = LLMRails(config)

completion = rails.generate(
    messages=[{"role": "user", "content": "Hello world!"}]
)
Saída de exemplo:```json {"role": "assistant", "content": "Hi! How can I help you?"}
O formato de entrada e saída para o método `generate` é semelhante à [Chat Completions API](https://platform.openai.com/docs/guides/gpt/chat-completions-api) da OpenAI.

#### Async API

A biblioteca NeMo Guardrails é um toolkit async-first, pois os mecanismos principais são implementados usando o modelo assíncrono do Python. Os métodos públicos têm tanto uma versão síncrona quanto uma assíncrona. Por exemplo: `LLMRails.generate` e `LLMRails.generate_async`.

### LLMs Suportados

Você pode usar o NeMo Guardrails com múltiplos LLMs como OpenAI GPT-3.5, GPT-4, LLaMa-2, Falcon, Vicuna ou Mosaic. Para mais detalhes, confira a seção [Supported LLM Models](https://docs.nvidia.com/nemo/guardrails/about-nemo-guardrails-library/supported-llms) no Guia de Configuração.

### Tipos de Guardrails

A biblioteca NeMo Guardrails suporta cinco tipos principais de guardrails:

<div align="center">
  <img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/programmable_guardrails_flow.png"  width="75%" alt="Programmable Guardrails Flow">
</div>

1. **Input rails**: aplicados à entrada do usuário; um input rail pode rejeitar a entrada, interrompendo qualquer processamento adicional, ou alterar a entrada (por exemplo, para mascarar dados potencialmente sensíveis, para reformular).

2. **Dialog rails**: influenciam como o LLM é instruído; os dialog rails operam sobre mensagens em forma canônica para detalhes veja [Colang Guide](https://docs.nvidia.com/nemo/guardrails/configure-guardrails/colang)) e determinam se uma ação deve ser executada, se o LLM deve ser invocado para gerar o próximo passo ou uma resposta, se uma resposta predefinida deve ser usada em vez disso, etc.

3. **Retrieval rails**: aplicados aos chunks recuperados no caso de um cenário RAG (Retrieval Augmented Generation); um retrieval rail pode rejeitar um chunk, impedindo que ele seja usado para instruir o LLM, ou alterar os chunks relevantes (por exemplo, para mascarar dados potencialmente sensíveis).

4. **Execution rails**: aplicados à entrada/saída das ações personalizadas (também conhecidas como ferramentas), que precisam ser chamadas pelo LLM.

5. **Output rails**: aplicados à saída gerada pelo LLM; um output rail pode rejeitar a saída, impedindo que ela seja retornada ao usuário, ou alterá-la (por exemplo, removendo dados sensíveis).

### Configuração de Guardrails

Uma configuração de guardrails define o(s) **LLM(s)** a serem usados e **um ou mais guardrails**. Uma configuração de guardrails pode incluir qualquer número de input/dialog/output/retrieval/execution rails. Uma configuração sem nenhum rail configurado essencialmente encaminhará as requisições para o LLM.

A estrutura padrão para uma pasta de configuração de guardrails é assim:```
.
├── config
│   ├── actions.py
│   ├── config.py
│   ├── config.yml
│   ├── rails.co
│   ├── ...
O config.yml contém todas as opções de configuração gerais, como modelos LLM, rails ativos e dados de configuração personalizados". O arquivo config.py contém qualquer código de inicialização personalizado e o actions.py contém quaisquer ações python personalizadas. Para uma visão geral completa, consulte o Configuration Guide.
Abaixo está um exemplo de config.yml:```yaml
models:
rails:
input: flows: - check jailbreak - mask sensitive data on input
output: flows: - self check facts - self check hallucination - activefence moderation on input
config: # Configure the types of entities that should be masked on user input. sensitive_data_detection: input: entities: - PERSON - EMAIL_ADDRESS
Os arquivos `.co` incluídos em uma configuração de guardrails contêm as definições Colang (consulte a próxima seção para uma visão geral rápida do que é Colang) que definem vários tipos de rails. Abaixo está um exemplo de arquivo `greeting.co` que define os dialog rails para saudar o usuário.```colang
define user express greeting
  "Hello!"
  "Good afternoon!"

define flow
  user express greeting
  bot express greeting
  bot offer to help

define bot express greeting
  "Hello there!"

define bot offer to help
  "How can I help you today?"
Abaixo está um exemplo adicional de definições Colang para um trilho de diálogo contra insultos:```colang define user express insult "You are stupid"
define flow user express insult bot express calmly willingness to help
### Colang

Para configurar e implementar vários tipos de guardrails, este toolkit introduz o **Colang**, uma linguagem de modelagem criada especificamente para projetar fluxos de diálogo flexíveis, porém controláveis. O Colang tem uma sintaxe semelhante ao Python e foi projetado para ser simples e intuitivo, especialmente para desenvolvedores.```{note}
Two versions of Colang, 1.0 and 2.0, are supported and Colang 1.0 is the default.
Para uma breve introdução à sintaxe do Colang 1.0, consulte o Guia de Sintaxe da Linguagem Colang 1.0.
Para começar com o Colang 2.0, consulte a Documentação do Colang 2.0.
O NeMo Guardrails vem com um conjunto de guardrails integrados.```{note} The built-in guardrails may or may not be suitable for a given production use case. As always, developers should work with their internal application team to ensure guardrails meets requirements for the relevant industry and use case and address unforeseen product misuse.
A biblioteca inclui guardrails para autoverificação de LLM (moderação de entrada/saída, verificação de fatos, detecção de alucinações), modelos de segurança NVIDIA (segurança de conteúdo, segurança de tópicos), detecção de jailbreak e injeção, e integrações com modelos da comunidade e APIs de terceiros. Para a lista completa, consulte a [documentação da Biblioteca de Guardrails](https://docs.nvidia.com/nemo/guardrails/user-guides/guardrails-library.html).

## CLI

A biblioteca NeMo Guardrails também vem com uma CLI integrada.```bash
$ nemoguardrails --help

Usage: nemoguardrails [OPTIONS] COMMAND [ARGS]...

actions-server    Start a NeMo Guardrails actions server.
chat              Start an interactive chat session.
evaluate          Run an evaluation task.
server            Start a NeMo Guardrails server.
Você pode usar a CLI da biblioteca NeMo Guardrails para iniciar um servidor de guardrails. O servidor pode carregar uma ou mais configurações da pasta especificada e expor uma API HTTP para usá-las.``` nemoguardrails server [--config PATH/TO/CONFIGS] [--port PORT]
Por exemplo, para obter uma conclusão de chat para uma configuração `sample`, você pode usar o endpoint `/v1/chat/completions`:```
POST /v1/chat/completions
Ao final deste módulo, você será capaz de:
Antes de começar este módulo, você deve ter:
O Model Context Protocol (MCP) é um padrão aberto que permite que aplicações de IA se conectem de forma segura a fontes de dados externas e ferramentas. Pense nele como uma "porta USB-C" para aplicações de IA — uma maneira padronizada de conectar modelos de IA a diversos recursos, mantendo a segurança e o controle.
A arquitetura MCP consiste em três componentes principais:
O MCP resolve vários desafios críticos de segurança de IA:
A integração do MCP expande a superfície de ataque de aplicações de IA:
Ao configurar o transporte MCP, considere:
Padrões de autenticação comuns para MCP incluem:
Use esta lista de verificação para avaliar a segurança da sua implantação MCP:
Analise uma implantação MCP existente e identifique possíveis vulnerabilidades de segurança. Documente suas descobertas e recomende mitigações.
Projete um servidor MCP seguro para um caso de uso específico. Considere autenticação, autorização, validação de entrada e segurança de transporte.
Realize testes de segurança em um servidor MCP, incluindo testes de autenticação, validação de entrada e limitação de taxa.
Agora que você entende os fundamentos da segurança MCP, prossiga para o próximo módulo para aprender sobre tópicos avançados de segurança e cenários de implantação do mundo real.
Lembre-se: A segurança é uma responsabilidade compartilhada. Mantenha-se vigilante, mantenha-se informado e sempre priorize a segurança em suas implantações MCP.```json { "config_id": "sample", "messages": [{ "role":"user", "content":"Hello! What can you do for me?" }] }
Saída de exemplo:```json
{"role": "assistant", "content": "Hi! How can I help you?"}
Para iniciar um servidor de guardrails, você também pode usar um contêiner Docker. A biblioteca NeMo Guardrails fornece um Dockerfile que você pode usar para construir uma imagem nemoguardrails. Para mais informações, consulte a seção usando Docker.
A integração com LangChain é opcional. Para habilitá-la, defina a variável de ambiente NEMOGUARDRAILS_LLM_FRAMEWORK=langchain ou chame set_default_framework("langchain"). Em seguida, instale os pacotes LangChain exigidos pela sua configuração. Depois de habilitar a integração, você pode envolver uma configuração de guardrails em torno de uma cadeia LangChain (ou qualquer Runnable), e pode chamar uma cadeia LangChain de dentro de uma configuração de guardrails. Para mais informações, consulte a Documentação de Integração com LangChain.
Avaliar a segurança de uma aplicação conversacional baseada em LLM é uma tarefa complexa e ainda uma questão de pesquisa em aberto. Para apoiar uma avaliação adequada, a biblioteca NeMo Guardrails fornece o seguinte:
nemoguardrails evaluate, com suporte para rails tópicos, verificação de fatos, moderação (jailbreak e moderação de saída) e alucinação.Existem muitas maneiras de adicionar guardrails a uma aplicação conversacional baseada em LLM. Por exemplo: endpoints explícitos de moderação (por exemplo, OpenAI, ActiveFence, PolicyAI), cadeias de crítica (por exemplo, cadeia constitucional), análise da saída (por exemplo, guardrails.ai), guardrails individuais (por exemplo, LLM-Guard), detecção de alucinação para aplicações RAG (por exemplo, Got It AI, Patronus Lynx).
A biblioteca NeMo Guardrails tem como objetivo fornecer um kit de ferramentas flexível que possa integrar todas essas abordagens complementares em uma camada coesa de guardrails para LLM. Por exemplo, o kit de ferramentas fornece integração pronta para uso com ActiveFence, PolicyAI, AlignScore e cadeias LangChain.
Até onde sabemos, a biblioteca NeMo Guardrails é o único kit de ferramentas de guardrails que também oferece uma solução para modelar o diálogo entre o usuário e o LLM. Isso possibilita, por um lado, a capacidade de guiar o diálogo de forma precisa. Por outro lado, possibilita controle refinado sobre quando certos guardrails devem ser usados, por exemplo, usar verificação de fatos apenas para certos tipos de perguntas.
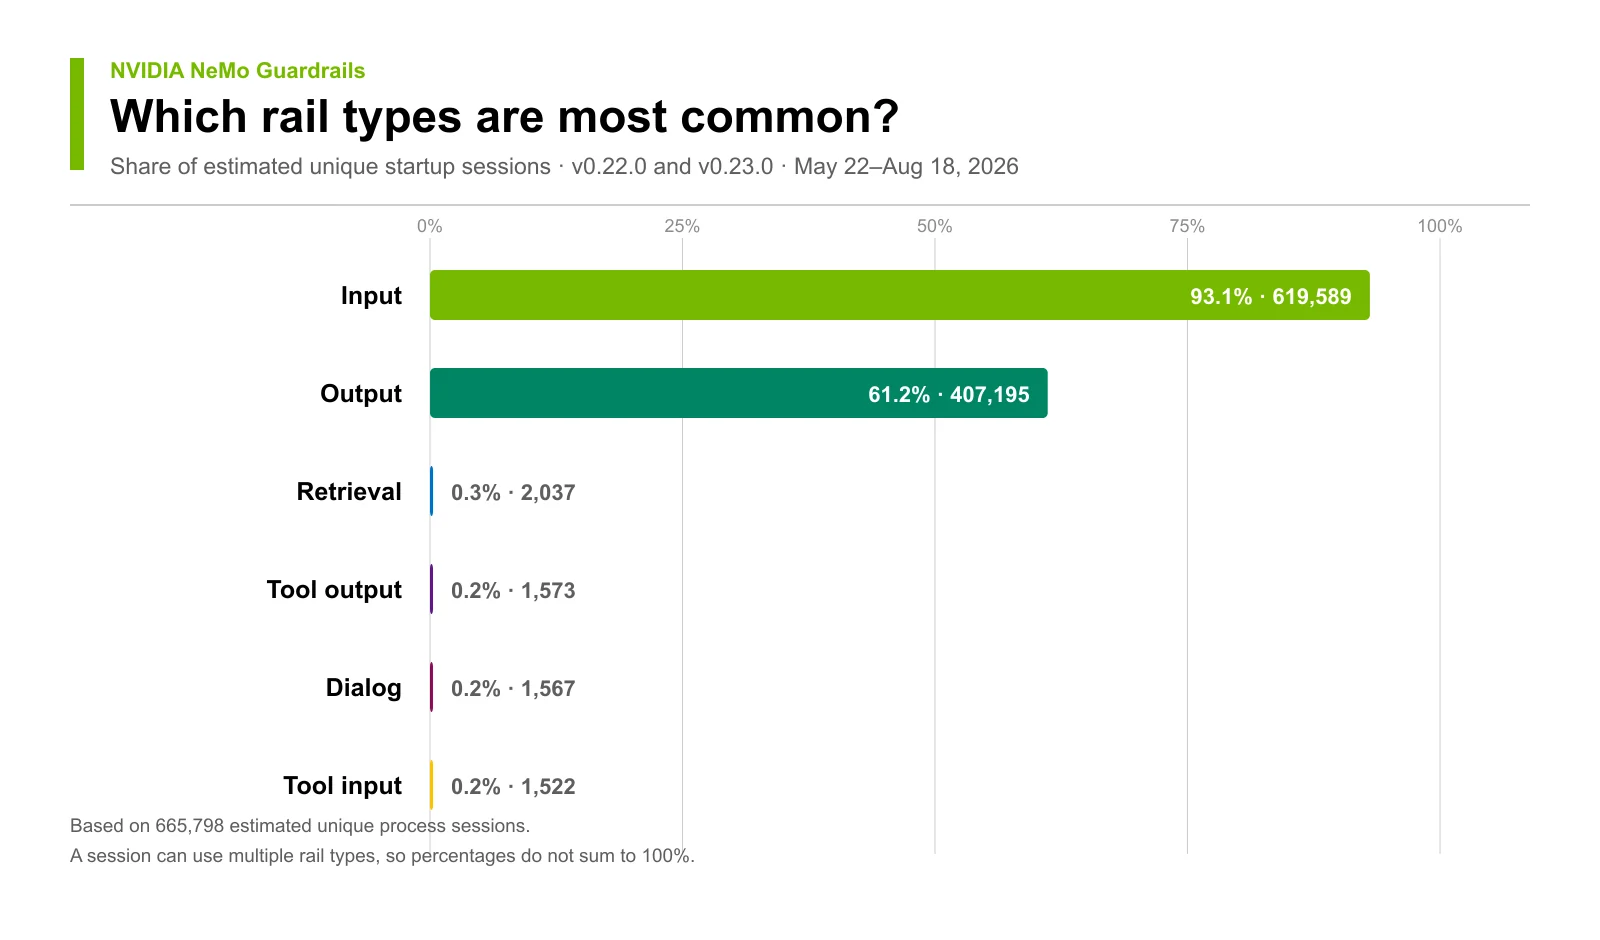
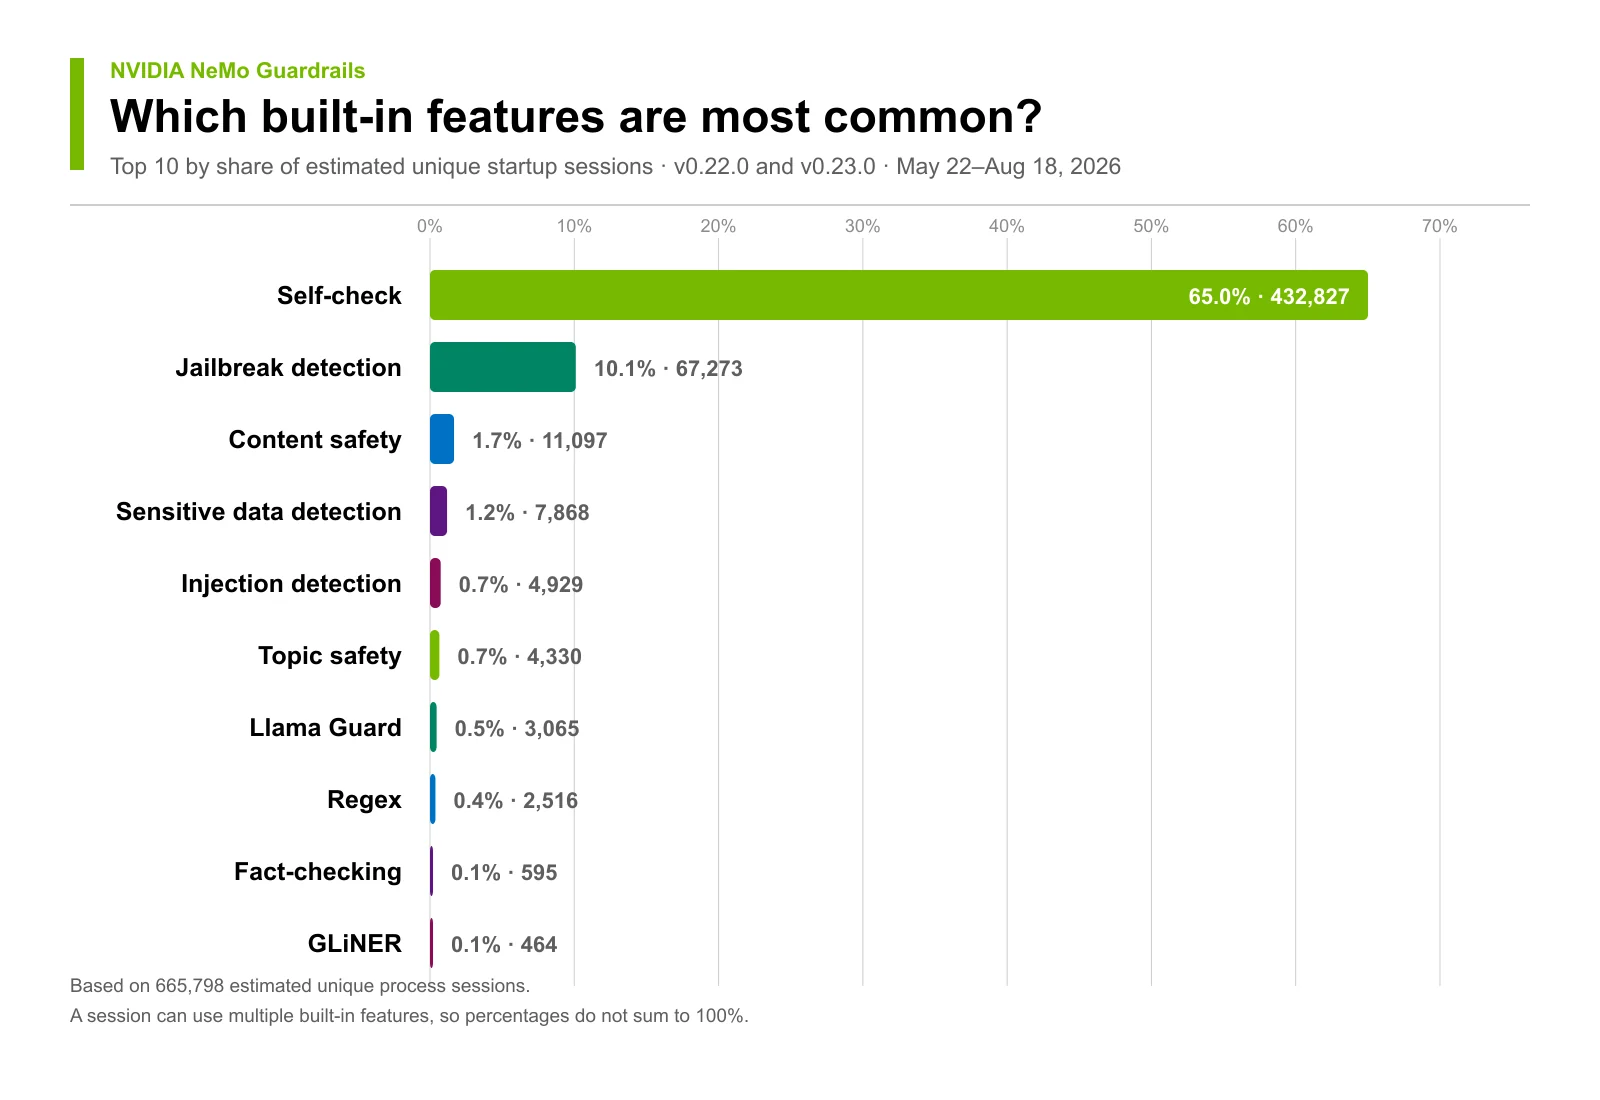
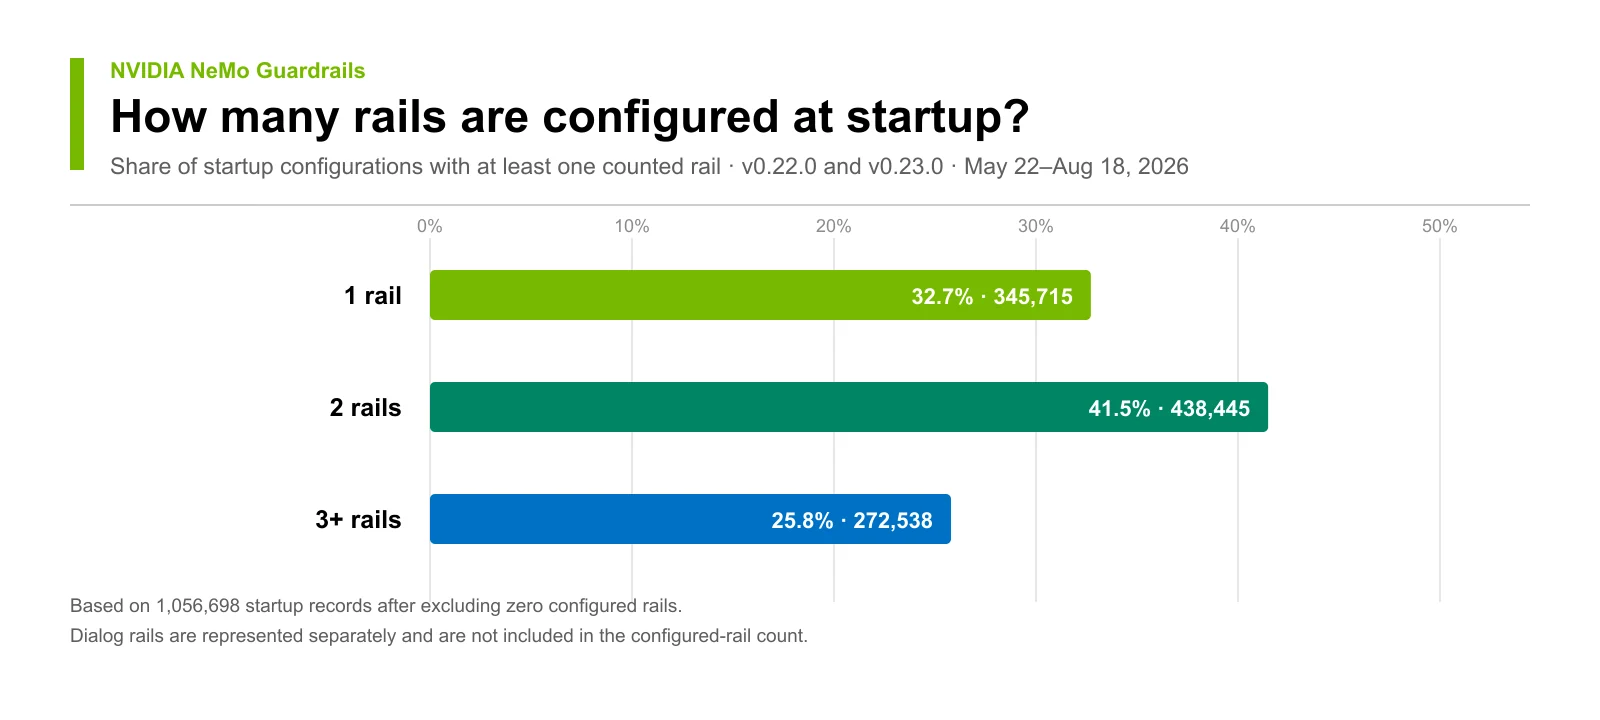
A biblioteca NVIDIA NeMo Guardrails coleta telemetria anônima para ajudar a NVIDIA a entender quais padrões de implantação e recursos de segurança são mais usados. A biblioteca emite um evento de uso quando você instancia LLMRails, IORails ou Guardrails, e então emite heartbeats periódicos a partir de uma única thread daemon por processo. Essa telemetria é separada do rastreamento por requisição. Você configura o rastreamento na sua configuração de guardrails e o envia para o seu próprio backend de observabilidade. A telemetria é um ping anônimo mínimo para a NVIDIA.
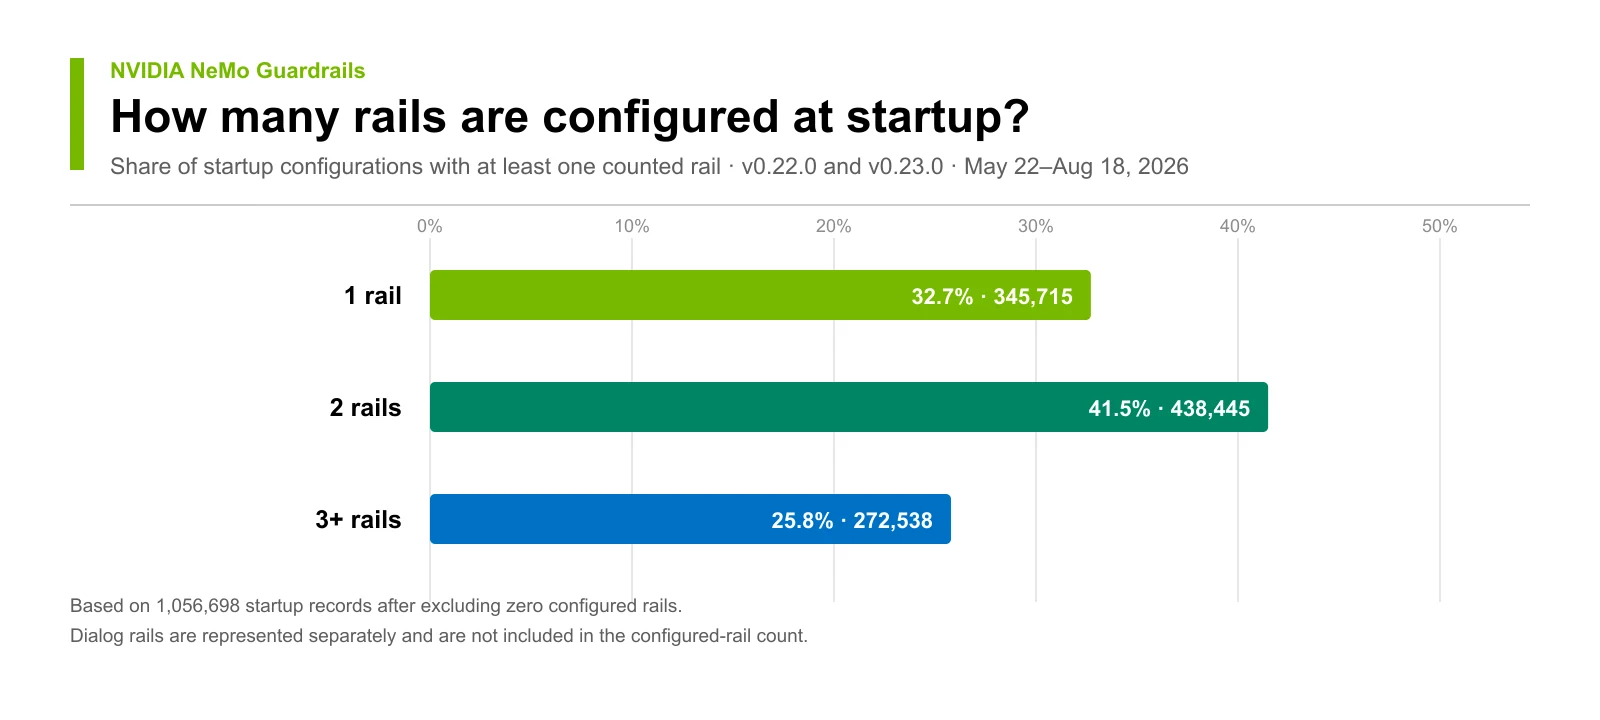
Uso anônimo agregado entre builds de lançamento exatos 0.22.0 e 0.23.0, de 22 de maio a 18 de agosto de 2026:
Última atualização em 18 de agosto de 2026
A telemetria inclui:
openai, nim ou nvidia_ai_endpoints, nunca nomes de modelos ou credenciaisjailbreak_detection, content_safety ou topic_safetylibrary, api ou cli)LLMRails ou IORails)Nenhum conteúdo do usuário é coletado no payload do evento. O payload não inclui nomes de modelos, chaves de API, endpoints, prompts, completions, contagens de tokens, métricas por requisição, caminhos de arquivos, nomes de usuário ou endereços IP. A NVIDIA usa os dados de forma agregada para priorizar o trabalho de engenharia e compartilhará tendências de adoção com a comunidade.
A biblioteca também tenta gravar cada payload de evento em um arquivo de auditoria local em ~/.config/nemoguardrails/usage_stats.json. O arquivo de auditoria armazena o JSONL do evento, não o envelope completo de telemetria da NVIDIA. As gravações de auditoria são feitas em regime de melhor esforço, e a transmissão de telemetria ainda prossegue se a gravação da auditoria local falhar.
Defina qualquer uma das seguintes opções para desabilitar a telemetria:```bash export NEMO_GUARDRAILS_NO_USAGE_STATS=1
export DO_NOT_TRACK=1
mkdir -p ~/.config/nemoguardrails && touch ~/.config/nemoguardrails/do_not_track
Defina o opt-out antes que a biblioteca NVIDIA NeMo Guardrails seja iniciada. Alterar variáveis de ambiente ou criar `do_not_track` depois que a telemetria já foi iniciada não interrompe uma thread de heartbeat em execução.

Consulte [docs/telemetry.md](https://docs.nvidia.com/nemo/guardrails/latest/telemetry.html) para o esquema completo e descrições campo a campo.

Você pode optar por não participar da coleta de telemetria a qualquer momento. O opt-out se aplica apenas à coleta de dados pela própria biblioteca NVIDIA NeMo Guardrails.

Endpoints de terceiros possuem termos e práticas de privacidade separados. A biblioteca NVIDIA NeMo Guardrails pode usar endpoints de inferência como o NVIDIA Build (`build.nvidia.com`). Se você usar o NVIDIA Build ou outro endpoint de terceiros, os termos de serviço e práticas de privacidade desse endpoint se aplicam independentemente da biblioteca. Qualquer opt-out de telemetria na biblioteca NVIDIA NeMo Guardrails não se estende ao endpoint que você escolher. O NVIDIA Build destina-se apenas a avaliação e testes e não deve ser usado em ambientes de produção. Não envie informações confidenciais ou dados pessoais ao usar o NVIDIA Build.

## Convidando a comunidade a contribuir

Os rails de exemplo residentes no repositório são excelentes pontos de partida. Convidamos entusiasticamente a comunidade a contribuir para tornar o poder de LLMs confiáveis, seguros e protegidos acessível a todos. Para orientações sobre como configurar um ambiente de desenvolvimento e como contribuir para a biblioteca NeMo Guardrails, consulte as [diretrizes de contribuição](https://github.com/nvidia-nemo/guardrails/blob/develop/CONTRIBUTING.md).

## Licença

A biblioteca NeMo Guardrails é licenciada sob a [Apache License, Version 2.0](http://www.apache.org/licenses/LICENSE-2.0).

## Como citar

Se você usar a biblioteca NeMo Guardrails, cite o [artigo da EMNLP 2023](https://aclanthology.org/2023.emnlp-demo.40) que a apresenta.```bibtex
@inproceedings{rebedea-etal-2023-nemo,
    title = "{N}e{M}o Guardrails: A Toolkit for Controllable and Safe {LLM} Applications with Programmable Rails",
    author = "Rebedea, Traian  and
      Dinu, Razvan  and
      Sreedhar, Makesh Narsimhan  and
      Parisien, Christopher  and
      Cohen, Jonathan",
    editor = "Feng, Yansong  and
      Lefever, Els",
    booktitle = "Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing: System Demonstrations",
    month = dec,
    year = "2023",
    address = "Singapore",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2023.emnlp-demo.40",
    doi = "10.18653/v1/2023.emnlp-demo.40",
    pages = "431--445",
}