 nil0x42/duplicut
Remova duplicatas de listas de palavras MASSIVAS, sem ordená-las (para quebra de senhas baseada em dicionário)




Atualmente, a criação de wordlists de senhas geralmente implica em concatenar múltiplas fontes de dados.
Idealmente, as senhas mais prováveis devem estar no início da wordlist, para que as senhas mais comuns sejam descobertas instantaneamente.
Com as ferramentas de deduplicação existentes, você é forçado a escolher se prefere preservar a ordem OU lidar com wordlists massivas.
Infelizmente, a criação de wordlists requer ambos
Então escrevi o duplicut em C altamente otimizado para atender a essa necessidade muito específica 🤓 💻
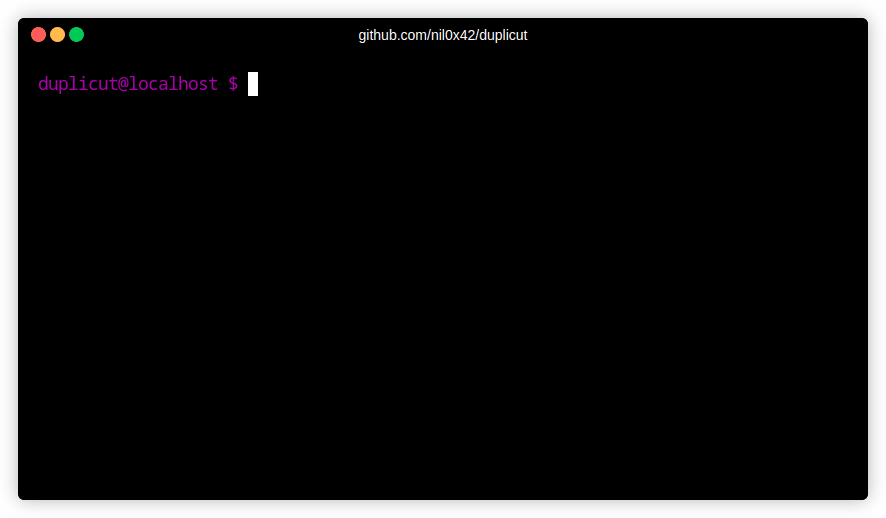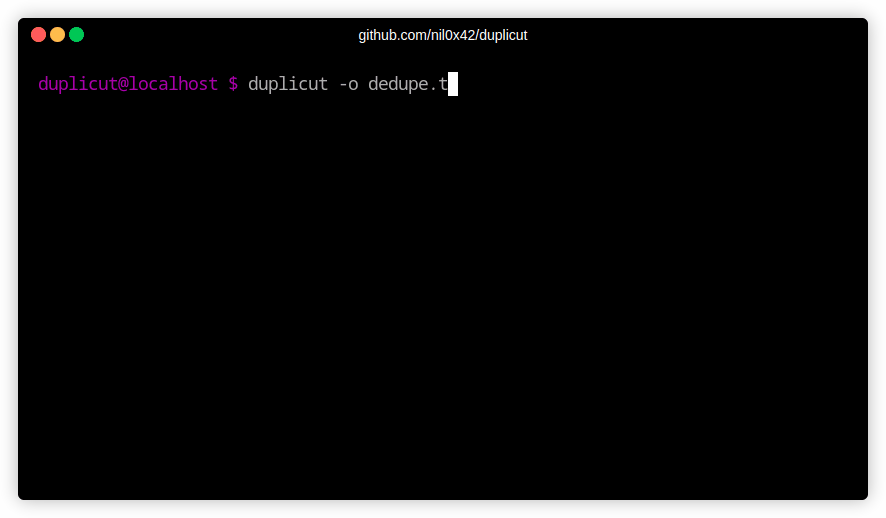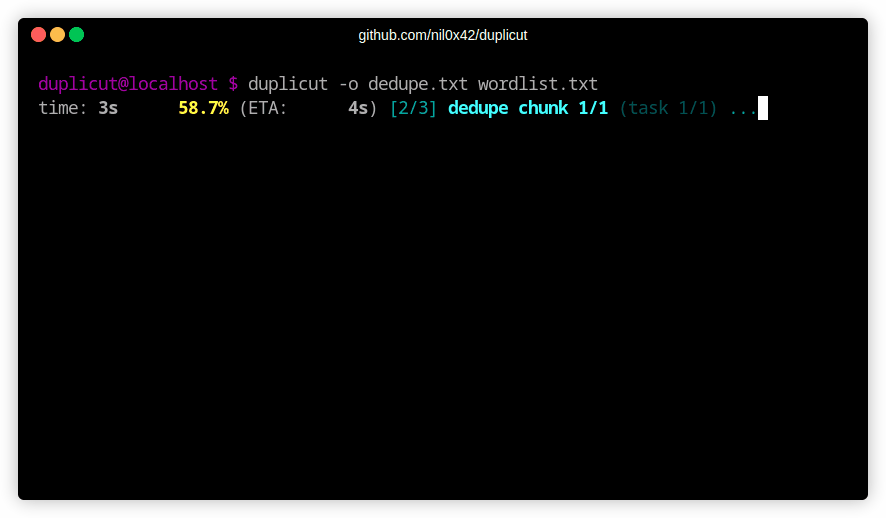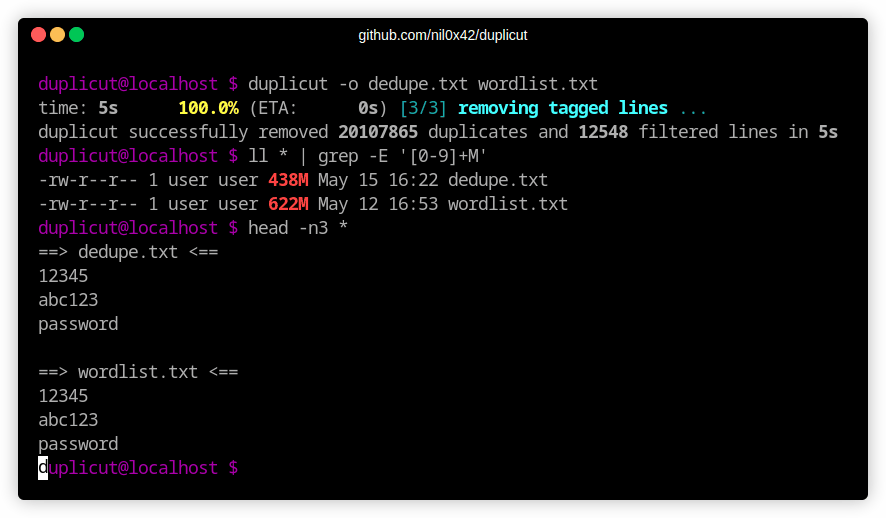
git clone https://github.com/nil0x42/duplicut  # download ...
cd duplicut/ && make                           # compile ...
./duplicut wordlist.txt -o clean-wordlist.txt  # dedupe !!!
-o, --outfile <FILE>       Write result to <FILE>
-t, --threads <NUM>        Max threads to use (default max)
-m, --memlimit <VALUE>     Limit max used memory (default max)
-l, --line-max-size <NUM>  Max line size (default 1024, max 4095)
-p, --printable            Filter ascii printable lines
-c, --lowercase            Convert wordlist to lowercase
-C, --uppercase            Convert wordlist to uppercase
-D, --dupfile <FILE>       Write dupes to <FILE> (slows down duplicut)
-h, --help                 Display this help and exit
-v, --version              Output version information and exit
Funcionalidades:
--line-max-size)--printable)--dupfile)--lowercase ou --uppercaseImplementação:
Limitações:
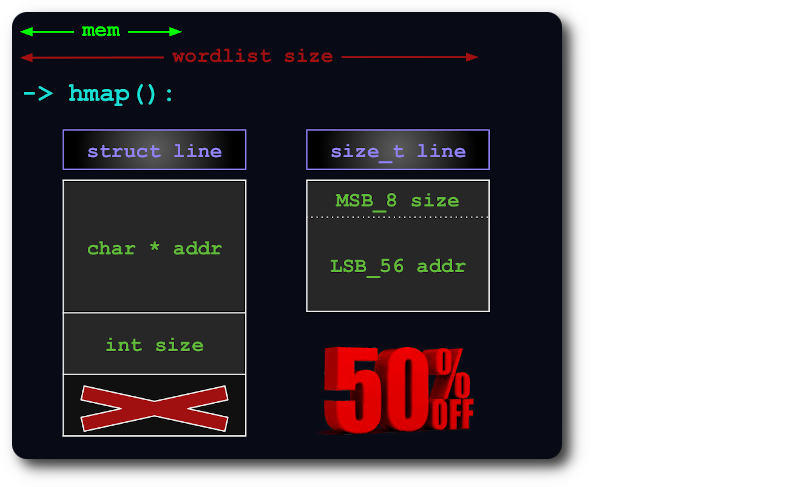
--line-max-size não pode exceder 4095Um uint64 é suficiente para indexar linhas no hashmap, empacotando a informação de size dentro dos bits extras do ponteiro:

Se o arquivo inteiro não couber na memória, ele é dividido em  chunks virtuais, de forma que cada chunk use o máximo de RAM possível.
Cada chunk é então carregado no hashmap, deduplicado e testado contra os chunks subsequentes.
Dessa forma, o tempo de execução diminui para no máximo o número triangular :

Se você encontrar um bug, ou algo não funcionar como esperado, por favor compile o duplicut em modo de depuração e poste uma issue com a saída anexada:
# debug level can be from 1 to 4
make debug level=1
./duplicut [OPTIONS] 2>&1 | tee /tmp/duplicut-debug.log
